
音频开发 / 系统课时
处理播报期间的用户打断
处理播报期间的用户打断
可打断语音对话的核心是:系统正在生成或播报回复时,一旦检测到用户重新开口,就立即取消旧任务、停止播放并恢复监听。实现时必须把“检测到语音”和“真正取消异步任务”连成一条可靠链路,否则只停声音而后台仍在继续消耗资源。
学习目标
- 识别播报阶段的 barge-in 触发条件
- 同时取消文本生成、TTS 合成和音频播放
- 用明确状态切换避免旧回复在打断后继续输出
打断不是单纯暂停播放器
用户打断时,系统可能同时存在三类进行中的工作:大模型正在生成后续文本、TTS 正在合成音频、播放器正在消费已经生成的音频块。只暂停播放器会留下两个问题:后台任务仍继续消耗算力,旧音频还可能在稍后重新进入播放队列。
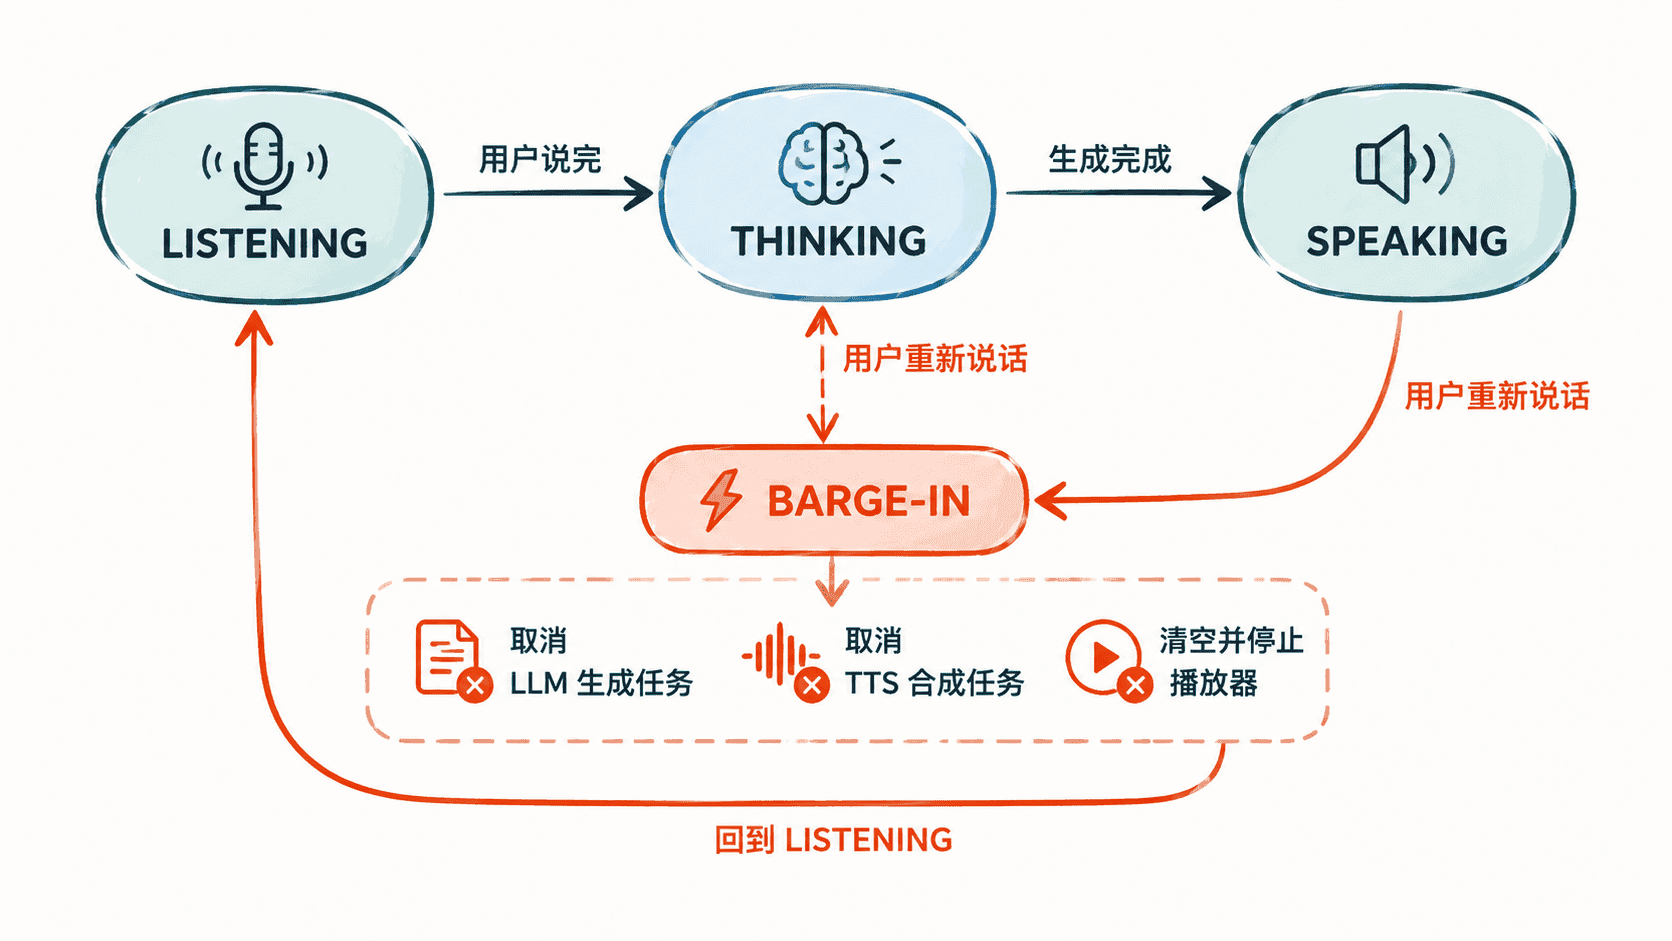
因此打断处理应当是一次“会话级取消”。最稳妥的设计是给当前轮回复保存可取消任务句柄,并在检测到新的语音活动后统一取消,再清理播放缓冲区,最后切回监听状态。
建立可取消的会话状态
下面的 Python 示例用 asyncio.Task 模拟大模型生成和 TTS 播报。示例可直接运行,不依赖外部服务,重点是观察取消顺序和状态恢复。
import asyncio

class VoiceSession:
    def __init__(self) -> None:
        self.state = 'LISTENING'
        self.generation_task: asyncio.Task[str] | None = None
        self.tts_task: asyncio.Task[None] | None = None

    async def fake_llm(self, text: str) -> str:
        await asyncio.sleep(0.1)
        return f'关于“{text}”,我先给你一个简短回答。'

    async def fake_tts(self, reply: str) -> None:
        print('开始播报:', reply)
        try:
            # 模拟持续生成并播放多个音频块。
            for index in range(5):
                await asyncio.sleep(0.2)
                print(f'播放音频块 {index + 1}')
        except asyncio.CancelledError:
            print('TTS 任务已取消')
            raise

    async def handle_user_turn(self, text: str) -> None:
        try:
            self.state = 'THINKING'
            self.generation_task = asyncio.create_task(self.fake_llm(text))
            reply = await self.generation_task

            self.state = 'SPEAKING'
            self.tts_task = asyncio.create_task(self.fake_tts(reply))
            await self.tts_task

            self.state = 'LISTENING'
        except asyncio.CancelledError:
            # 被打断后,状态由 barge_in() 统一恢复,避免重复切换。
            pass

    async def barge_in(self) -> None:
        print('检测到用户打断')

        for task in (self.generation_task, self.tts_task):
            if task is not None and not task.done():
                task.cancel()

        await asyncio.gather(
            *[
                task
                for task in (self.generation_task, self.tts_task)
                if task is not None
            ],
            return_exceptions=True,
        )

        self.state = 'LISTENING'
        print('已停止旧回复,回到监听状态')

async def main() -> None:
    session = VoiceSession()
    turn = asyncio.create_task(session.handle_user_turn('介绍一下今天的安排'))

    await asyncio.sleep(0.25)
    await session.barge_in()
    await asyncio.gather(turn, return_exceptions=True)

    print('当前状态:', session.state)

if __name__ == '__main__':
    asyncio.run(main())
预期输出
开始播报: 关于“介绍一下今天的安排”,我先给你一个简短回答。
检测到用户打断
TTS 任务已取消
已停止旧回复,回到监听状态
当前状态: LISTENING
真实系统中的音频块是否已经播放一部分取决于设备和调度时机,因此不要把“完全没有旧声音”作为唯一验证条件。更重要的是,打断触发后旧任务不再继续产生新的文本或音频。
把 VAD 事件接到取消逻辑
barge-in 一般由 VAD(语音活动检测)触发,但不能只要有一点声音就取消。扬声器回声、键盘声和环境噪声都可能误触发,因此常见做法是要求检测到持续的人声活动,并结合回声消除后的输入信号判断。
触发条件可以概括为:当前状态处于 THINKING 或 SPEAKING,并且 VAD 连续确认用户语音达到最小持续时间。满足后立刻执行取消,而不是等待 ASR 先识别出完整句子。否则用户已经开口,系统还会继续说一段时间,打断感会非常迟钝。
清理旧轮次的残留数据
取消任务后还要处理缓冲区。播放器队列里可能已经有尚未播放的 PCM 或压缩音频块,TTS 流中也可能有刚抵达但还没消费的数据。打断时应同时清空这些旧数据,并为下一轮用户输入创建新的 turn ID 或 generation ID。
服务端返回流式结果时,客户端最好只接受当前轮次 ID 对应的数据。即使旧请求因为网络延迟又回来一块数据,也可以在进入 TTS 或播放器之前直接丢弃,避免“被打断的助手突然又说一句”。
验证打断是否真正生效
测试时不要只听主观效果,还要检查状态和资源是否回收。一次合格的打断应满足:检测到用户重新开口后迅速停止旧声音;旧 LLM/TTS 任务进入取消或结束状态;旧音频队列被清空;系统重新接受新的 ASR 输入;迟到的旧轮次数据被丢弃。
当这些条件同时成立时,barge-in 才是完整的会话控制能力,而不是一个“暂停播放”按钮。