
音频开发 / 系统课时
监控错误率延迟与资源占用
监控错误率延迟与资源占用
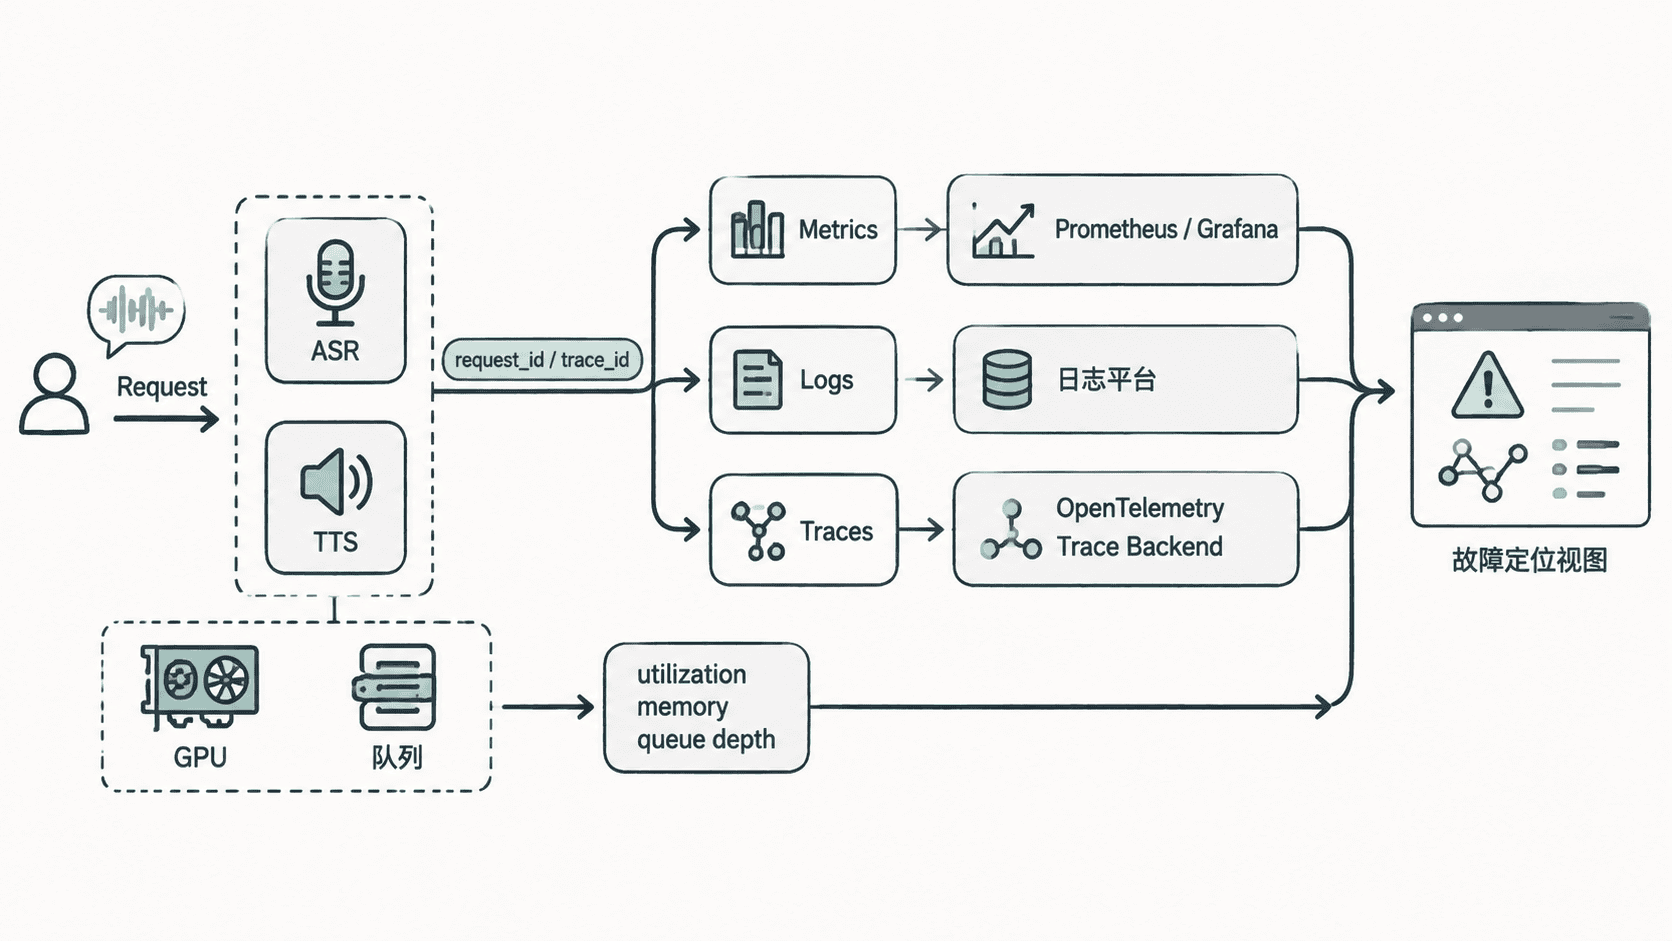
语音服务上线后,真正需要的是“出问题时能迅速定位”。本节把 ASR/TTS 请求量、错误率、处理时长、实时率、GPU 显存和队列积压放进同一套监控体系,并用统一请求标识把指标、日志与调用链串起来。
学习目标
- 能为 ASR 与 TTS 建立覆盖请求、延迟、错误和资源的核心指标集
- 能用队列、GPU 与实时率指标判断容量压力来自哪里
- 能通过统一
request_id关联日志、指标与链路追踪
先建立最小指标集
请求侧至少记录总请求数、成功数、失败数和处理时长直方图。语音业务还需要增加音频时长与实时率,因为“一个请求耗时 3 秒”对 1 秒语音和 60 秒语音代表完全不同的性能。
资源侧重点关注 CPU、内存、GPU 利用率、GPU 显存、活跃会话数和队列长度。队列积压尤其重要:它往往比错误率更早暴露容量不足。
| 指标 | 建议类型 | 主要用途 |
|---|---|---|
speech_requests_total |
Counter | 请求量与错误率 |
speech_request_duration_seconds |
Histogram | P95/P99 延迟 |
speech_audio_seconds_total |
Counter | 处理音频总量 |
speech_rtf |
Histogram | 推理是否跟得上实时输入 |
speech_queue_depth |
Gauge | 是否出现排队 |
| GPU 利用率/显存 | Gauge | 判断推理资源是否饱和 |
暴露 Prometheus 指标
下面示例用 Python 暴露一个最小监控端点。真实服务中应把计时与计数放到实际 ASR/TTS 请求处理路径中,而不是单独模拟。
import random
import time

from prometheus_client import Counter, Gauge, Histogram, start_http_server

REQUESTS = Counter(
    "speech_requests_total",
    "Speech requests",
    ["service", "status"],
)
LATENCY = Histogram(
    "speech_request_duration_seconds",
    "Speech request latency",
    ["service"],
)
QUEUE_DEPTH = Gauge(
    "speech_queue_depth",
    "Pending speech jobs",
    ["service"],
)

def handle_asr() -> None:
    QUEUE_DEPTH.labels("asr").inc()
    started = time.perf_counter()
    try:
        time.sleep(random.uniform(0.05, 0.15))
        REQUESTS.labels("asr", "success").inc()
    finally:
        QUEUE_DEPTH.labels("asr").dec()
        LATENCY.labels("asr").observe(time.perf_counter() - started)

if __name__ == "__main__":
    start_http_server(9108)
    while True:
        handle_asr()
安装依赖并启动后,可直接检查指标端点:
python -m pip install prometheus-client
python app.py
预期结果:进程持续运行,并在本机 9108 端口暴露 /metrics。实际启动时间和进程号可能不同。
再执行:
curl -s http://127.0.0.1:9108/metrics | grep -E 'speech_requests_total|speech_queue_depth'预期输出结构类似:
speech_requests_total{service="asr",status="success"} <VALUE>
speech_queue_depth{service="asr"} <VALUE>
生产环境还应通过 GPU exporter 或设备监控接口采集显存与 GPU 利用率,并给每个实例附加 service、model、instance 等稳定标签。不要把 request_id 放进 Prometheus 标签,否则高基数会显著增加存储与查询压力。
用统一标识串起日志与调用链
request_id 适合放进结构化日志,trace_id 适合跨网关、业务服务、模型服务和外部依赖传播。两者可以相同,也可以分别生成,但必须在日志中同时记录,确保从告警能够一路追到单次请求。
{"level":"INFO","service":"asr","request_id":"<ID>","trace_id":"<ID>","queue_wait_ms":12,"inference_ms":184,"status":"success"}这类日志不是用来替代指标,而是用于解释异常样本。Prometheus 告诉你“P99 变差了”,日志与 Trace 则帮助确认究竟是排队、模型推理、网络还是下游依赖拖慢了请求。
用指标组合定位常见故障
当 P95/P99 上升且 speech_queue_depth 同步增长,而 GPU 利用率长期接近上限时,通常是容量不足;当延迟上升但队列很浅、GPU 也空闲,应继续检查网络、存储、依赖服务或锁竞争。
如果错误率突然上升而资源正常,则优先按错误码分组查看,例如超时、音频格式错误、模型加载失败和 OOM 不应混成一个总错误率。这样告警一触发,就能快速判断是输入问题、容量问题还是服务故障。
生产监控的关键不是“指标越多越好”,而是让请求量、延迟、错误、队列和资源形成因果链:先看到用户是否受影响,再沿统一请求标识追到具体请求,最后用资源与队列数据验证根因。