
音频开发 / 系统课时
用 VAD 去掉静音片段
用 VAD 去掉静音片段
连续录音里往往有大量停顿、呼吸间隙和环境底噪。VAD 的目标不是“把所有安静处都删掉”,而是稳定找出真正需要送入识别模型的有声区间,并用最小时长、静音保持和前后缓冲避免把词头、词尾一起切掉。
学习目标
- 理解 VAD 的帧级判断与区间合并思路
- 能设置静音阈值、最小时长和前后缓冲
- 能验证裁剪后是否既节省计算又不截断语音
VAD 判断的是“是否像语音”
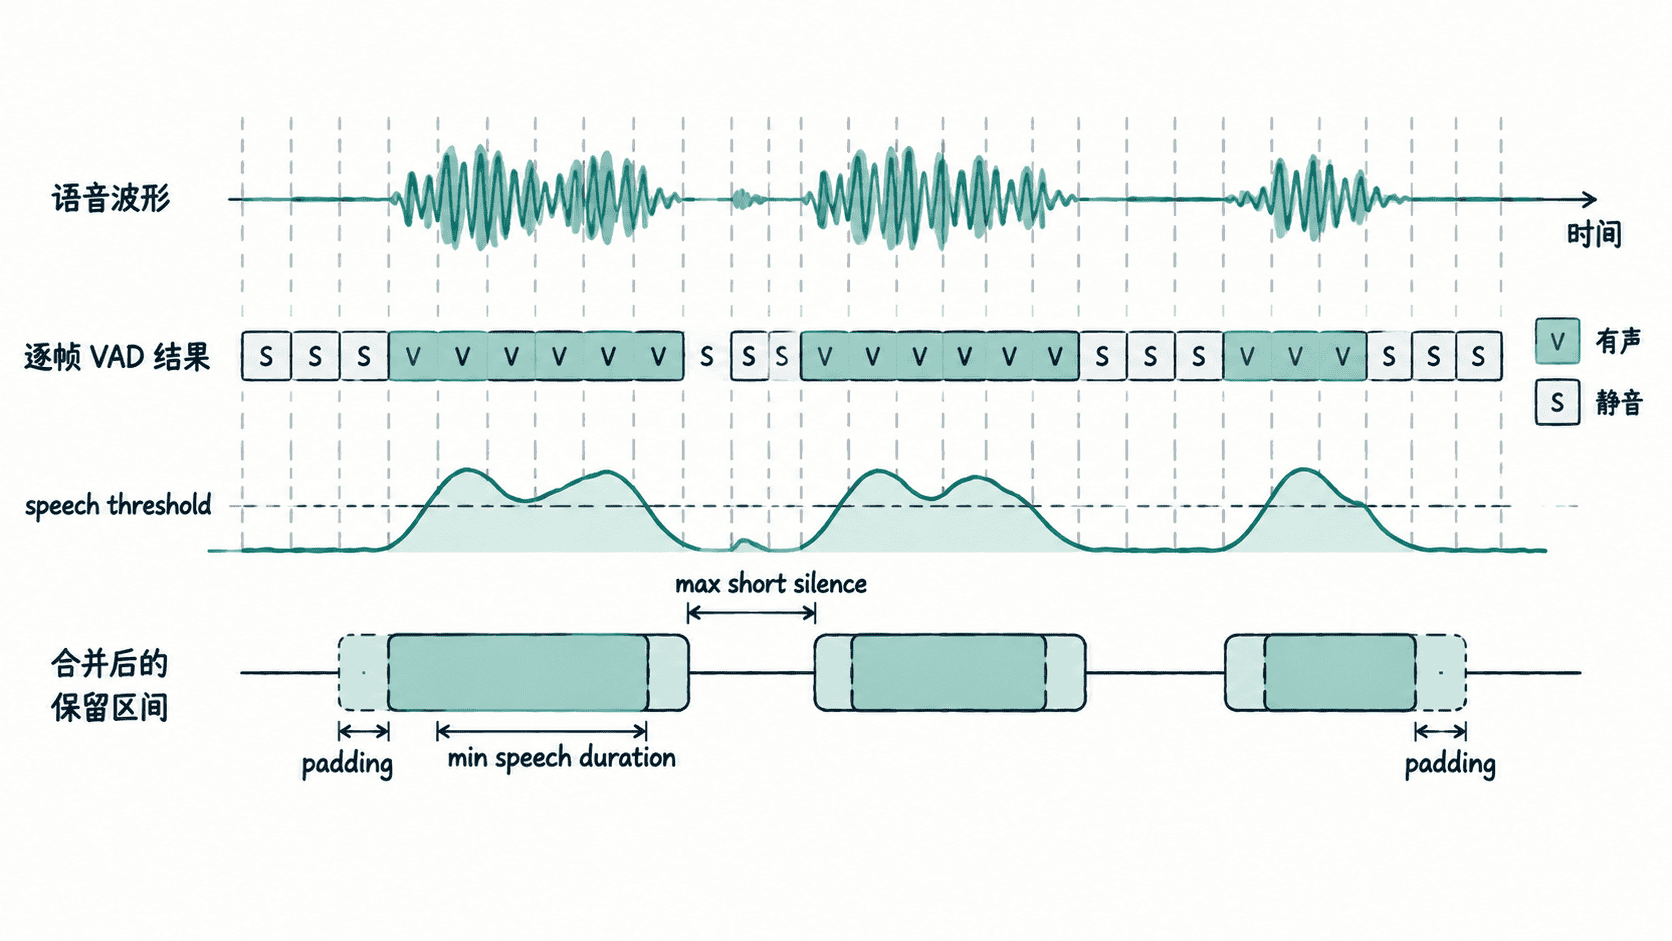
VAD 通常先把音频切成几十毫秒的小帧,再对每帧判断“有声”或“静音”。简单实现可以用短时能量,高级实现则会结合频谱或模型特征。无论算法多复杂,工程上真正影响体验的往往是阈值和区间合并策略。
如果只按单帧结果立刻开关,很容易出现“说话过程中被切断”。因此常见做法是:连续有声达到最小时长才开始保留;短暂静音先等待一段时间;最终区间再向前、向后各扩一点缓冲。
用能量 VAD 跑通最小实现
下面示例只依赖 Python 标准库,输入要求为 16 kHz、单声道、16-bit PCM WAV。它用 20 ms 帧计算 dBFS,把高于 -42 dBFS 的帧视为有声,再把小于 250 ms 的短静音桥接起来,并在最终区间两侧各保留 100 ms。
import math
import struct
import sys
import wave

FRAME_MS = 20
SILENCE_DBFS = -42.0
MIN_SPEECH_MS = 120
MAX_GAP_MS = 250
PADDING_MS = 100

def dbfs(frame: bytes) -> float:
    samples = struct.unpack("<" + "h" * (len(frame) // 2), frame)
    if not samples:
        return -100.0
    rms = math.sqrt(sum(s * s for s in samples) / len(samples))
    return -100.0 if rms == 0 else 20 * math.log10(rms / 32768.0)

def main(src: str, dst: str) -> None:
    with wave.open(src, "rb") as wf:
        if (wf.getframerate(), wf.getnchannels(), wf.getsampwidth()) != (16000, 1, 2):
            raise ValueError("需要 16 kHz、单声道、16-bit PCM WAV")
        params = wf.getparams()
        frame_samples = 16000 * FRAME_MS // 1000
        frames = []
        while True:
            data = wf.readframes(frame_samples)
            if not data:
                break
            frames.append(data)

    voiced = [dbfs(f) > SILENCE_DBFS for f in frames]
    max_gap = MAX_GAP_MS // FRAME_MS
    # 先桥接说话内部的短停顿,避免把一个词组切成多段。
    for i in range(1, len(voiced) - 1):
        if not voiced[i]:
            left = next((j for j in range(i - 1, max(-1, i - max_gap - 1), -1) if voiced[j]), None)
            right = next((j for j in range(i + 1, min(len(voiced), i + max_gap + 1)) if voiced[j]), None)
            if left is not None and right is not None and right - left - 1 <= max_gap:
                for j in range(left + 1, right):
                    voiced[j] = True

    min_frames = max(1, MIN_SPEECH_MS // FRAME_MS)
    pad_frames = PADDING_MS // FRAME_MS
    ranges = []
    start = None
    for i, flag in enumerate(voiced + [False]):
        if flag and start is None:
            start = i
        elif not flag and start is not None:
            if i - start >= min_frames:
                ranges.append((max(0, start - pad_frames), min(len(frames), i + pad_frames)))
            start = None

    with wave.open(dst, "wb") as out:
        out.setparams(params)
        for start, end in ranges:
            for frame in frames[start:end]:
                out.writeframes(frame)

    kept_ms = sum(end - start for start, end in ranges) * FRAME_MS
    print(f"保留 {len(ranges)} 段有声区间,共 {kept_ms} ms")

if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
运行方式:
python vad_trim.py input.wav speech_only.wav预期输出:
保留 <N> 段有声区间,共 <MS> ms<N> 和 <MS> 由实际录音决定。输出文件 speech_only.wav 应只包含被保留的区间,同时仍能听到词头和词尾。
调参数时先保护语音完整性
SILENCE_DBFS 越高,越容易把轻声当成静音;越低,则越容易把风扇声、空调声当成语音。建议先从 -45 到 -35 dBFS 的范围试起,并优先查看漏掉的轻声片段,而不是一味追求“删得干净”。
MIN_SPEECH_MS 用来过滤咳嗽、点击声等极短脉冲;MAX_GAP_MS 决定一句话内部多长的停顿仍视为同一段;PADDING_MS 则保护辅音起始和词尾衰减。实时识别里,宁可多保留几十到几百毫秒,也不要为了节省一点计算量而截掉有效语音。
验证是否真的值得裁剪
验证时至少比较三个指标:裁剪前后总时长、识别文本是否缺字、端到端识别耗时是否下降。若时长明显减少但文本出现词头缺失,应先增大前向缓冲;若一句话被切成很多碎片,应增加允许的短静音时长。
VAD 的价值不是把波形“修得更整齐”,而是用尽量保守的边界把无效静音挡在识别模型之前。只要完整性优先、阈值和缓冲经过真实录音验证,就能在不明显伤害准确率的前提下降低后续计算量。