
音频开发 / 系统课时
实现边合成边播放的流式输出
实现边合成边播放的流式输出
这一节把“等整段 TTS 完成再播放”改造成真正的流式链路:音频块一到就进入有界缓冲,达到启动水位后立即播放,并用背压和低水位策略处理合成速度抖动。完成后,你能把首包等待压低,同时避免因为网络或合成瞬时变慢而频繁卡顿。
学习目标
- 理解流式 TTS 中生产者、播放缓冲和消费者之间的速度关系。
- 实现“先攒少量再开播”的启动水位,并用有界队列提供背压。
- 能区分 PCM 与压缩音频的处理方式,并定位常见的爆音、断流和延迟问题。
流式播放真正解决什么
非流式方案通常是“提交文本 → 等待整段音频 → 下载完整文件 → 播放”。它实现简单,但首句很长时,用户必须等待全部合成结束才听到声音。流式方案把合成结果切成连续音频块,接收端不再等待完整文件,而是边收、边缓冲、边播放。
这里有两个不同指标:首包时间表示 TTS 服务何时返回第一块音频,首声时间表示用户何时真正听到声音。播放器如果为了“绝不卡顿”预缓冲两三秒,即使首包很快,首声仍然很慢;反过来完全不缓冲,网络稍有抖动就会断续。
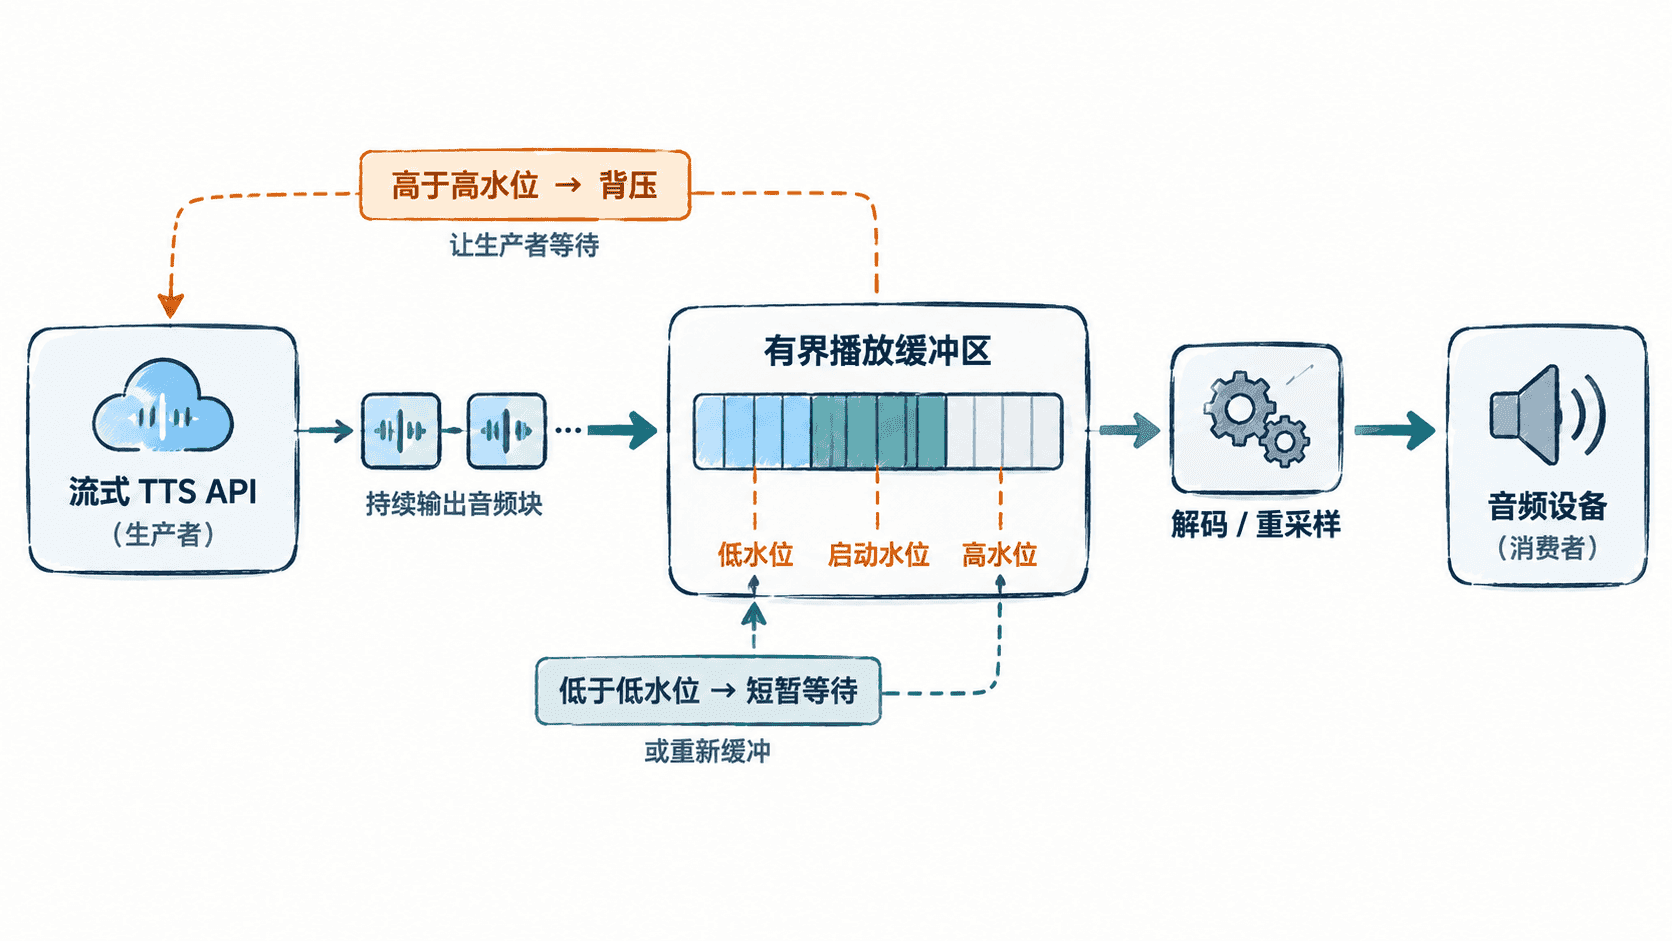
一个可用的策略不是“缓存越多越好”,而是只缓存足以吸收短时抖动的数据。例如 24 kHz、单声道、16 bit PCM 每毫秒约产生 48 字节,160 ms 启动缓冲约为 7680 字节。启动水位越高越稳,但首声时间也越长,需要在真实网络环境中测量后调整。
用有界队列连接生产与消费
生产者负责从 TTS SDK、HTTP 流或 WebSocket 接收音频块;消费者负责按真实播放速度取走数据。两者之间使用有界队列比无限列表更安全:当网络和合成长时间快于播放速度时,队列满会自然形成背压,避免内存持续增长。
下面的示例使用 sounddevice 打开原始 PCM 输出流,并用本地生成的正弦波模拟 TTS 连续返回的 PCM 块。这样可以先独立验证播放缓冲逻辑,再把 synthesize() 替换为实际 TTS SDK 的流式读取代码。运行前需要安装 Python 包 sounddevice。
import asyncio
import math
import random
import struct

import sounddevice as sd

SAMPLE_RATE = 24_000
CHANNELS = 1
CHUNK_MS = 40
START_BUFFER_MS = 160
CHUNK_SAMPLES = SAMPLE_RATE * CHUNK_MS // 1000
START_CHUNKS = START_BUFFER_MS // CHUNK_MS
END = object()

def make_pcm_chunk(chunk_index: int) -> bytes:
    # 生成 440 Hz、16 bit 单声道 PCM,模拟 TTS 返回的一个音频块。
    start = chunk_index * CHUNK_SAMPLES
    samples = []
    for i in range(CHUNK_SAMPLES):
        value = int(8000 * math.sin(2 * math.pi * 440 * (start + i) / SAMPLE_RATE))
        samples.append(struct.pack("<h", value))
    return b"".join(samples)

async def synthesize(queue: asyncio.Queue) -> None:
    for index in range(50):
        # 平均生产速度略快于播放速度,同时保留抖动。
        await asyncio.sleep(random.uniform(0.015, 0.050))
        await queue.put(make_pcm_chunk(index))
    await queue.put(END)

async def play(queue: asyncio.Queue) -> None:
    buffered = []
    while len(buffered) < START_CHUNKS:
        item = await queue.get()
        if item is END:
            break
        buffered.append(item)

    print("开始播放")
    with sd.RawOutputStream(
        samplerate=SAMPLE_RATE,
        channels=CHANNELS,
        dtype="int16",
    ) as stream:
        for chunk in buffered:
            stream.write(chunk)

        while True:
            item = await queue.get()
            if item is END:
                break
            stream.write(item)
    print("播放结束")

async def main() -> None:
    queue = asyncio.Queue(maxsize=20)
    await asyncio.gather(synthesize(queue), play(queue))

if __name__ == "__main__":
    asyncio.run(main())
预期输出如下,同时扬声器会播放一小段连续音调:
开始播放
播放结束
这个示例里的队列既是缓冲区,也是背压边界。真实项目还应记录队列当前时长而不是只看“块数量”,因为 TTS 返回块的大小可能不固定。更稳妥的实现会按采样率、位深、声道数换算为可播放毫秒数,再判断是否达到启动、低水位或高水位。
处理格式和速度不一致
最容易踩坑的是把“收到字节”直接等价为“可以播放”。如果服务返回的是裸 PCM,采样率、位深、声道数和字节序必须与播放设备配置一致;如果返回 MP3、AAC、Opus 等压缩格式,则必须先经过支持流式输入的解码器,不能把压缩字节直接写进 PCM 输出流。
还要区分短时抖动和持续速度不足。偶尔低于低水位,可以暂停几十到几百毫秒补缓冲;如果长期“生产速度 < 消费速度”,再大的启动缓冲也只能延迟卡顿发生,此时应减少合成复杂度、降低输出码率、切换更近的服务节点,或调整播放策略。
验证首声时间和抗抖动能力
验收时不要只听“能不能播”,至少记录请求发出时间、第一音频块到达时间、播放器开始时间、缓冲最低值和重新缓冲次数。首声时间可以拆成“请求到首包 + 首包到达到启动水位”,这样才能判断延迟究竟来自 TTS、网络还是播放器自身。
测试时可人为给生产者增加随机延迟,再观察缓冲是否能吸收抖动;随后逐步降低启动水位,直到首声时间和卡顿率达到可接受平衡。生产环境通常还需要在用户开始说话、切换页面或取消朗读时立即停止生产者并清空旧缓冲,避免上一段音频继续播放。
真正稳定的流式播放并不是“收到一块就立即写声卡”,而是用少量预缓冲换取抗抖动能力,用有界队列限制内存,并把格式转换、背压和取消逻辑放在清晰的链路边界上。