
音频开发 / 系统课时
输出词级时间戳与分段结果
输出词级时间戳与分段结果
批量识别只有一段纯文本还不够:字幕需要句段起止时间,播放器定位需要词级坐标,跟读高亮还要求每个词与音频时间轴严格对齐。本节把常见识别结果整理成统一的段落与词级结构,并给出可直接验证的 Python 处理方式。
学习目标
- 理解句段时间戳与词级时间戳各自解决的问题
- 将识别结果规范化为稳定的结构化片段
- 正确处理时间单位、边界重叠与缺失词时间戳
两层时间坐标分别做什么
句段时间戳描述“这一句话何时开始、何时结束”,适合生成字幕块、段落跳转和检索定位;词级时间戳描述“每个词在句段内出现在哪里”,适合逐词高亮、跟读评分和精确剪辑。
一个可靠的数据结构应同时保留段级与词级坐标。段落本身是粗粒度容器,词级时间戳是更细的索引,二者不要互相替代。
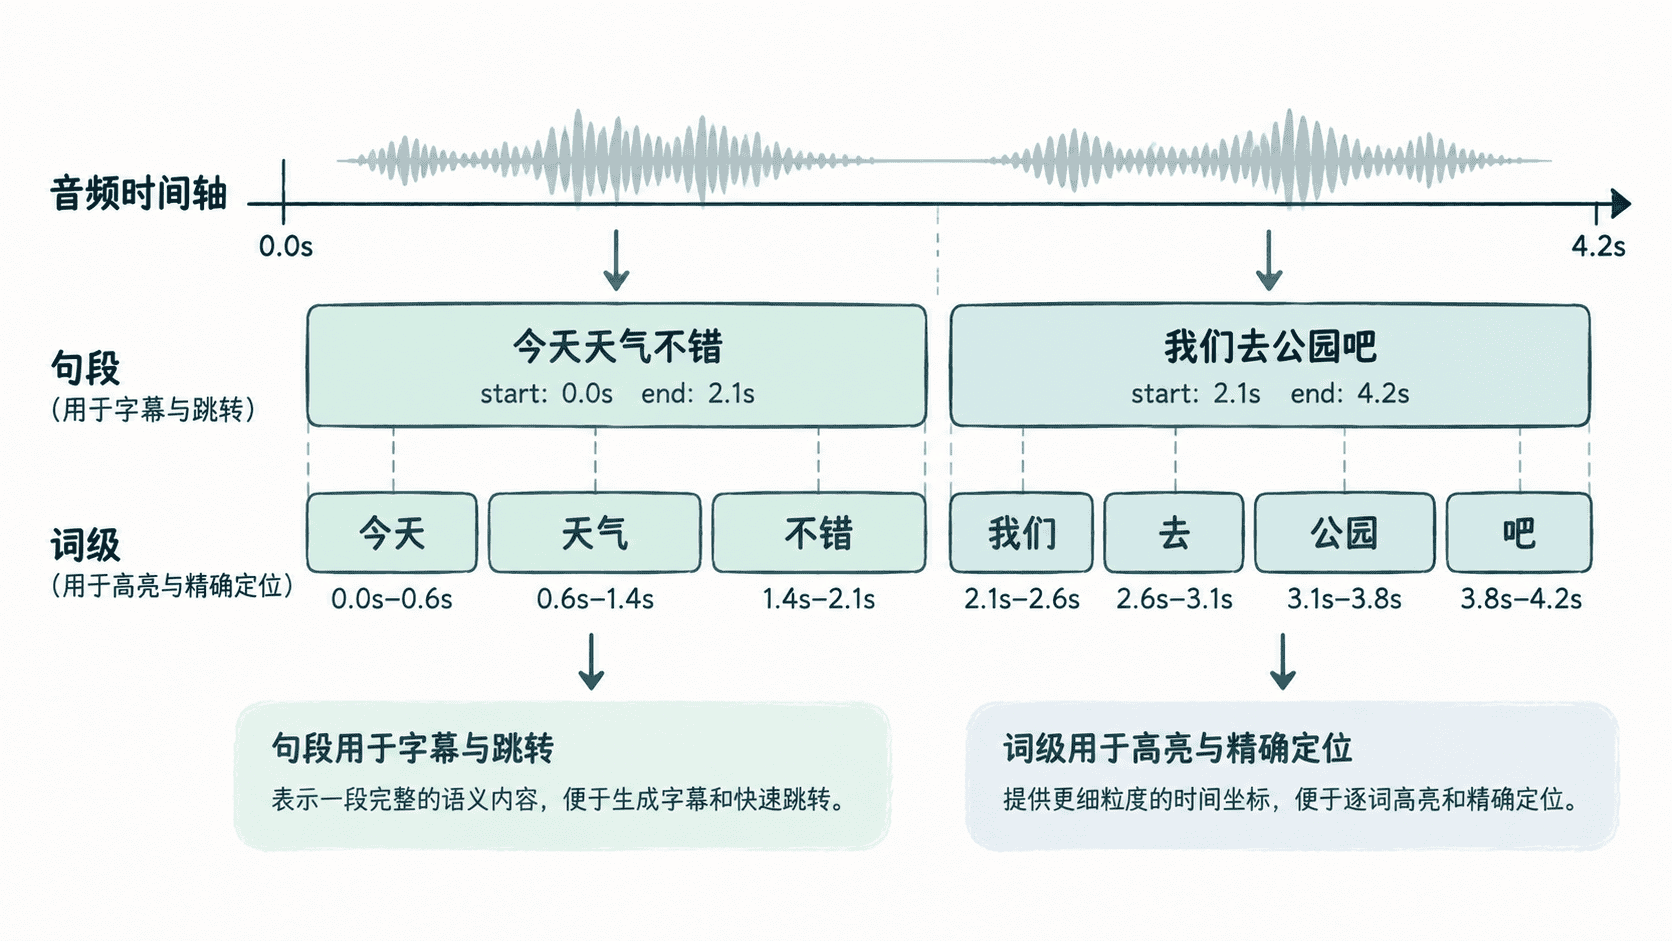
统一结果结构
不同识别服务返回的字段名可能不同,但进入业务层后最好转换成统一结构。下面的示例只依赖 Python 标准库,模拟一份已经获得的识别结果,并把毫秒时间戳统一转换为秒。
from dataclasses import dataclass, asdict
from typing import List

@dataclass
class Word:
    text: str
    start: float
    end: float

@dataclass
class Segment:
    text: str
    start: float
    end: float
    words: List[Word]

raw_segments = [
    {
        "text": "实时语音已经开始",
        "start_ms": 0,
        "end_ms": 1800,
        "words": [
            {"text": "实时", "start_ms": 0, "end_ms": 520},
            {"text": "语音", "start_ms": 560, "end_ms": 980},
            {"text": "已经", "start_ms": 1040, "end_ms": 1320},
            {"text": "开始", "start_ms": 1360, "end_ms": 1800},
        ],
    }
]

def ms_to_seconds(value: int) -> float:
    # 统一保留三位小数,避免前端重复处理毫秒与秒两套单位。
    return round(value / 1000, 3)

segments = [
    Segment(
        text=item["text"],
        start=ms_to_seconds(item["start_ms"]),
        end=ms_to_seconds(item["end_ms"]),
        words=[
            Word(
                text=word["text"],
                start=ms_to_seconds(word["start_ms"]),
                end=ms_to_seconds(word["end_ms"]),
            )
            for word in item["words"]
        ],
    )
    for item in raw_segments
]

print(asdict(segments[0]))
预期输出
{'text': '实时语音已经开始', 'start': 0.0, 'end': 1.8, 'words': [{'text': '实时', 'start': 0.0, 'end': 0.52}, {'text': '语音', 'start': 0.56, 'end': 0.98}, {'text': '已经', 'start': 1.04, 'end': 1.32}, {'text': '开始', 'start': 1.36, 'end': 1.8}]}这里最重要的不是字段名,而是明确时间单位和边界语义。推荐业务层统一使用秒并保留小数,播放器、字幕和检索模块都只消费这一种格式。
生成字幕片段时保留边界
字幕通常按句段输出,不应把每个词都做成独立字幕,否则画面会频繁跳变。词级时间戳更适合作为段落内部的附加信息。
整理字幕时至少保留 text、start、end。若两个相邻句段存在轻微重叠,不要直接修改原始识别时间;可以在字幕导出层做显示裁剪,同时把原值留给检索和回放定位。
词级时间戳并不总是完整
部分模型或服务只在特定模式下返回词级时间戳,也可能出现某个词没有起止时间。此时不要用平均分配法伪造精确坐标,否则跟读高亮会明显漂移。
更稳妥的处理顺序是:有真实词级时间戳就直接使用;只有句段时间戳时仅提供段级定位;必须做逐词高亮时,再选择支持词级时间戳的识别能力重新处理音频。
当结果进入字幕、播放器或搜索系统后,句段时间戳负责“快速定位到一段”,词级时间戳负责“精确定位到一个词”。只要先把单位、层级和缺失策略统一,后续功能就不需要反复适配识别服务的原始格式。