
音频开发 / 系统课时
规划 CPU 与 GPU 推理容量
规划 CPU 与 GPU 推理容量
语音服务上线前不能只看“单次推理有多快”,还要把峰值请求、音频时长、实时率、批处理收益和目标利用率一起换算成设备数量。本节给出一套可复算的容量估算方法,并说明何时优先 CPU、何时应直接规划 GPU。
学习目标
- 用实时率把业务流量换算为 CPU 或 GPU 的推理负载
- 比较 CPU 与 GPU 在延迟、批处理和成本上的适用边界
- 为单机容量、扩容阈值和压测验收预留可解释的安全余量
先把业务流量换算成音频负载
实时率 RTF 定义为推理耗时与音频时长之比:RTF = t_infer / t_audio。RTF 为 0.2 表示处理 10 秒音频大约需要 2 秒计算时间;RTF 小于 1 代表单路任务能够快于实时完成。
容量估算不能只拿平均 QPS。先计算峰值时每秒需要处理多少音频秒,再叠加模型 RTF、批处理收益和目标利用率。对于流式 ASR,还要额外检查并发连接数、每路状态内存和实时尾延迟,最终实例数取吞吐约束与并发约束中的较大值。
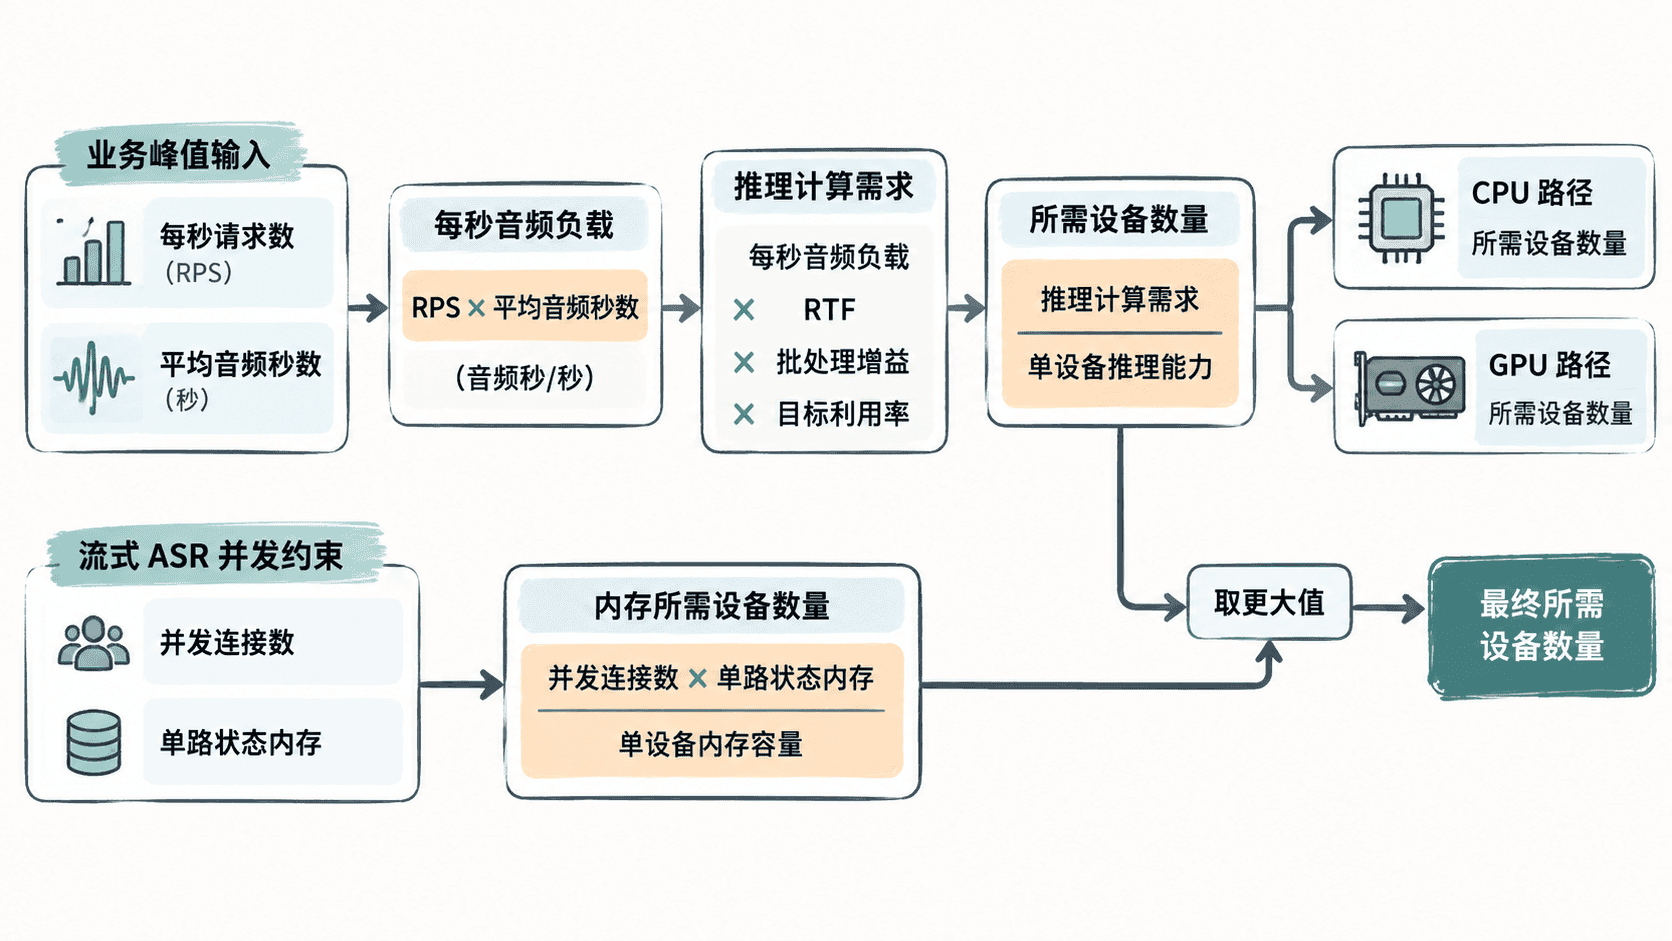
用同一条公式估算基础设备数
对可按音频秒计量的 TTS 或离线 ASR,可以先用下面的近似式做初算:
设备数 = ceil(峰值 QPS × 平均音频秒数 × RTF ÷ 批处理增益 ÷ 目标利用率)
批处理增益大于 1 表示一次处理多条样本后,设备的有效吞吐提高;目标利用率不要直接填 100%,否则任何抖动、预处理或后处理开销都会把队列推高。
下面的脚本比较同一业务峰值下两组实测参数。示例假设峰值为每秒 8 个请求,每个请求平均生成 3 秒音频。
from math import ceil

def required_devices(
    qps: float,
    audio_seconds_per_request: float,
    rtf: float,
    batch_gain: float,
    target_utilization: float,
) -> int:
    audio_load = qps * audio_seconds_per_request
    # 先换算为每秒需要多少设备计算秒,再按批处理收益和利用率折算实例数。
    device_seconds = audio_load * rtf / batch_gain
    return ceil(device_seconds / target_utilization)

gpu_count = required_devices(8, 3.0, 0.12, 1.60, 0.75)
cpu_count = required_devices(8, 3.0, 0.65, 1.05, 0.75)

print(f"GPU instances: {gpu_count}")
print(f"CPU instances: {cpu_count}")
预期输出:
GPU instances: 3
CPU instances: 20
这个结果只说明在给定基准测试下,GPU 所需实例更少,并不自动等于 GPU 总成本更低。实例单价、显存容量、冷启动、数据搬运和可获得的批大小都要一起进入最终决策。
CPU 与 GPU 要按端到端瓶颈选择
| 判断维度 | 更偏向 CPU | 更偏向 GPU |
|---|---|---|
| 模型与算子规模 | 小模型、量化模型、算子并行度低 | 大模型、矩阵计算密集 |
| 峰值吞吐 | 低到中等,流量离散 | 高吞吐,可形成稳定批次 |
| 延迟目标 | 允许较宽松尾延迟 | 需要更低的单次或批量延迟 |
| 资源约束 | 内存足够、CPU 核易横向扩 | 显存足够且 GPU 能稳定供给 |
| 成本形态 | 空闲时损失较小 | 高利用率时单位推理成本更低 |
不要用厂商公布的峰值算力替代真实语音基准。预处理、特征提取、分词、声码器、后处理和网络拷贝都可能成为瓶颈。尤其是 GPU 利用率不高时,问题未必是“GPU 太多”,也可能是 CPU 预处理喂不满设备。
扩容边界要盯队列而不只盯利用率
生产扩容通常应同时观察设备利用率、排队时长、P95/P99 推理延迟、批大小、显存或内存水位和错误率。只按 CPU 或 GPU 利用率扩容容易反应过慢:当队列已经持续增长时,用户延迟可能早已恶化。
初始容量可以按压测得到的峰值实例数,再预留故障与突发余量。自动扩容则优先使用能直接反映拥塞的指标,例如待处理任务数、最老任务等待时间或活跃流式会话数,并结合实例启动时间设置冷却窗口,避免在短暂毛刺下频繁扩缩。
压测结果才是最终容量边界
上线前应使用与生产一致的模型版本、精度、音频格式、批处理配置和硬件型号做阶梯压测,逐步提高流量,记录每档的 RTF、队列长度、P95/P99 延迟、吞吐、内存或显存峰值以及错误率。容量上限应取“仍满足延迟与稳定性目标”的最高负载,而不是设备刚好跑满的点。
如果 GPU 方案在高批量下表现优秀,但真实业务请求稀疏、无法形成批次,就要用真实到达分布重新测量;反过来,CPU 在低流量时可能更经济,但峰值需要大量实例时,运维与机器成本会迅速放大。最终方案应以同一业务负载下的端到端单位成本和尾延迟为依据,而不是单看设备型号。