
音频开发 / 系统课时
采集麦克风流并稳定分帧
采集麦克风流并稳定分帧
实时识别首先要解决的不是模型调用,而是把长度不稳定的麦克风回调数据变成持续、等时长的音频帧。本节实现一个可运行的采集器,以设备原生采样率接收音频,再通过累积缓冲稳定切出固定 20 ms 帧,为网络传输、VAD 和 ASR 提供可靠输入。
学习目标
- 理解麦克风回调块与业务音频帧为什么不能直接等同
- 使用累积缓冲把不定长回调数据切成固定时长帧
- 正确处理设备采样率差异,并建立可验证的实时输入约束
为什么回调块不能直接当音频帧
音频设备通常通过回调连续交付数据,但每次回调收到多少采样点由驱动、Host API 和内部缓冲策略决定。即使应用希望每 20 ms 获得一帧,也不能假设回调一定按照这个长度触发。
固定时长帧应根据实际采样率计算。若帧长为 20 ms,设备采样率为 48 kHz,则一帧需要 960 个采样点;16 kHz 下则需要 320 个采样点。关键约束是按时间切帧,而不是按回调次数切帧。
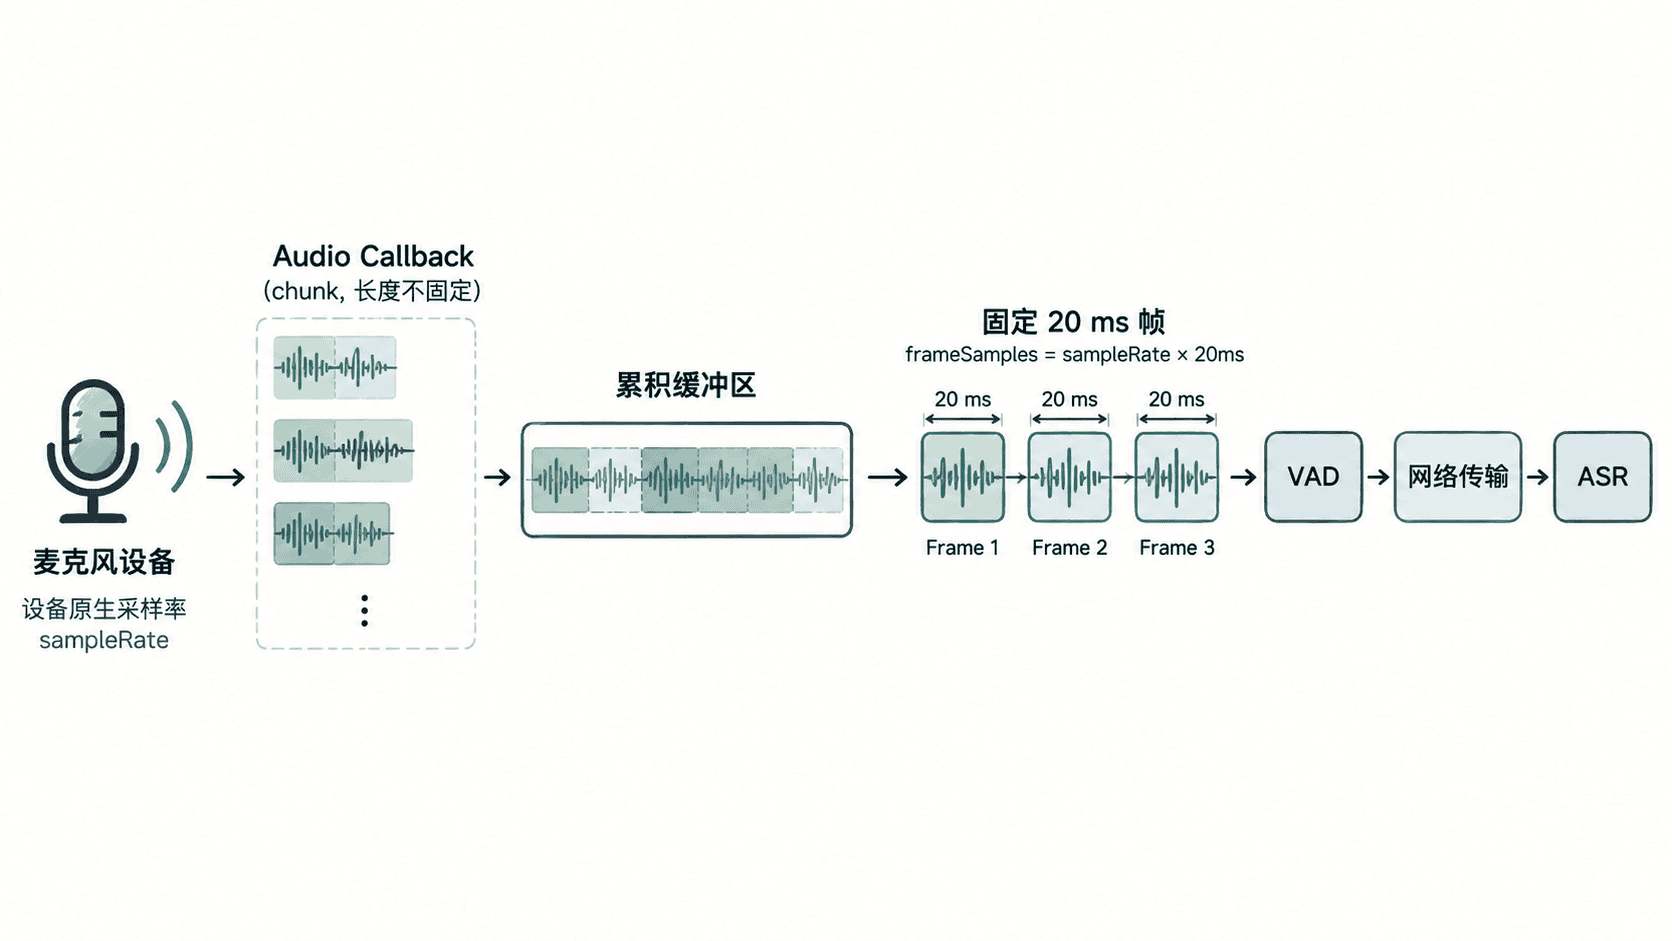
用累积缓冲切出固定帧
下面的 Python 示例使用 sounddevice 读取默认麦克风。blocksize=0 表示让音频后端自行决定回调块大小,应用只负责把数据追加到 pending,当累计采样点达到一帧长度时再切出完整帧。
示例依赖 sounddevice 与 numpy。运行时会采集 10 个 20 ms 音频帧,约 0.2 秒后自动结束。
import queue

import numpy as np
import sounddevice as sd

FRAME_MS = 20
FRAME_COUNT = 10
chunks = queue.Queue()


def on_audio(indata, frames, time_info, status):
    if status:
        print(f'audio status: {status}')
    # 回调缓冲区随后会被底层复用,因此必须复制后再交给消费线程。
    chunks.put(indata[:, 0].copy())


def main():
    device = sd.query_devices(kind='input')
    sample_rate = int(round(device['default_samplerate']))
    frame_samples = int(round(sample_rate * FRAME_MS / 1000))
    pending = np.empty(0, dtype=np.float32)
    emitted = 0

    print(f'sample_rate={sample_rate}Hz frame_samples={frame_samples}')

    with sd.InputStream(
        samplerate=sample_rate,
        channels=1,
        dtype='float32',
        blocksize=0,
        callback=on_audio,
    ):
        while emitted < FRAME_COUNT:
            chunk = chunks.get()
            # 回调块可以大于或小于一帧,统一先进入累积缓冲区。
            pending = np.concatenate((pending, chunk))

            while len(pending) >= frame_samples and emitted < FRAME_COUNT:
                frame = pending[:frame_samples].copy()
                pending = pending[frame_samples:]
                emitted += 1

                if emitted in (1, FRAME_COUNT):
                    duration_ms = len(frame) * 1000 / sample_rate
                    print(
                        f'frame={emitted:03d} samples={len(frame)} '
                        f'duration={duration_ms:.1f}ms'
                    )


if __name__ == '__main__':
    main()
预期输出如下,其中 <NATIVE_RATE> 和 <FRAME_SAMPLES> 取决于实际麦克风设备;无论设备回调块如何变化,每个输出帧的时长都应稳定在 20.0 ms。
sample_rate=<NATIVE_RATE>Hz frame_samples=<FRAME_SAMPLES>
frame=001 samples=<FRAME_SAMPLES> duration=20.0ms
frame=010 samples=<FRAME_SAMPLES> duration=20.0ms
这里不能把 chunks 本身当成帧队列,因为队列中的每个元素仍然只是一次设备回调。真正稳定的帧边界由 pending 和 frame_samples 共同决定。
处理采样率差异与实时抖动
如果 ASR 服务能够接收设备原生采样率,可以直接携带真实 sample_rate 发送固定时长帧。若服务强制要求 16 kHz,则应在采集与业务分帧之间加入连续、带状态的重采样器,把整个音频流转换到 16 kHz 后,再按每帧 320 个采样点切分。
音频回调本身还应保持足够轻量。不要在回调线程中执行网络请求、磁盘写入、模型推理或复杂编码;回调只复制数据并快速入队,切帧和后续处理放到消费线程中,才能降低系统调度抖动导致的丢帧风险。
验收稳定输入
验证时不要只听录音是否正常,而要记录连续数百帧的采样点数量和时间戳。固定采样率下,每一帧的采样点数必须一致;即使某次设备回调一次送来两帧以上的数据,或只送来半帧数据,最终输出仍应保持连续且不重不漏。
当下游要求 16 kHz、单声道、20 ms PCM 帧时,最终输入约束就是每帧恰好 320 个采样点,并保持原始时间顺序。做到这一点后,网络发送、端点检测和流式识别才能建立在稳定的时间基准上。