
音频开发 / 系统课时
用 MOS 与可懂度评估音质
用 MOS 与可懂度评估音质
这一节把“听起来还不错”变成可比较的数据。你会设计一组可重复的主观 MOS 评分与可懂度测试,让不同音色、语速、参数和文本类型在同一条件下被评价,并用均值、置信区间和字符错误率判断差异是否足以支持产品选择。
学习目标
- 设计题干、样本和随机顺序,减少主观评分中的系统性偏差。
- 用 MOS 衡量自然度或整体质量,用转写错误率衡量内容是否听得懂。
- 汇总不同音色与文本类型的结果,避免只看一个平均分就下结论。
先把两个问题分开测
MOS 适合回答“这段合成语音整体听起来有多好”,但它本质上是主观评分。可懂度则回答“用户能不能准确听清内容”,更适合通过听写结果计算错误率。两者相关,却不能互相替代:一段声音可能非常清楚但机械感明显,也可能自然度不错却在数字、英文缩写或专有名词上频繁读错。
评分题干必须一次只问一个维度。例如本轮明确评“自然度”,就不要让同一个 1~5 分同时混合自然度、情感、音量和可懂度。常用的五级量表可以定义为 1 分很差、2 分较差、3 分一般、4 分较好、5 分很好,但题干和锚点在整个实验中必须保持一致。
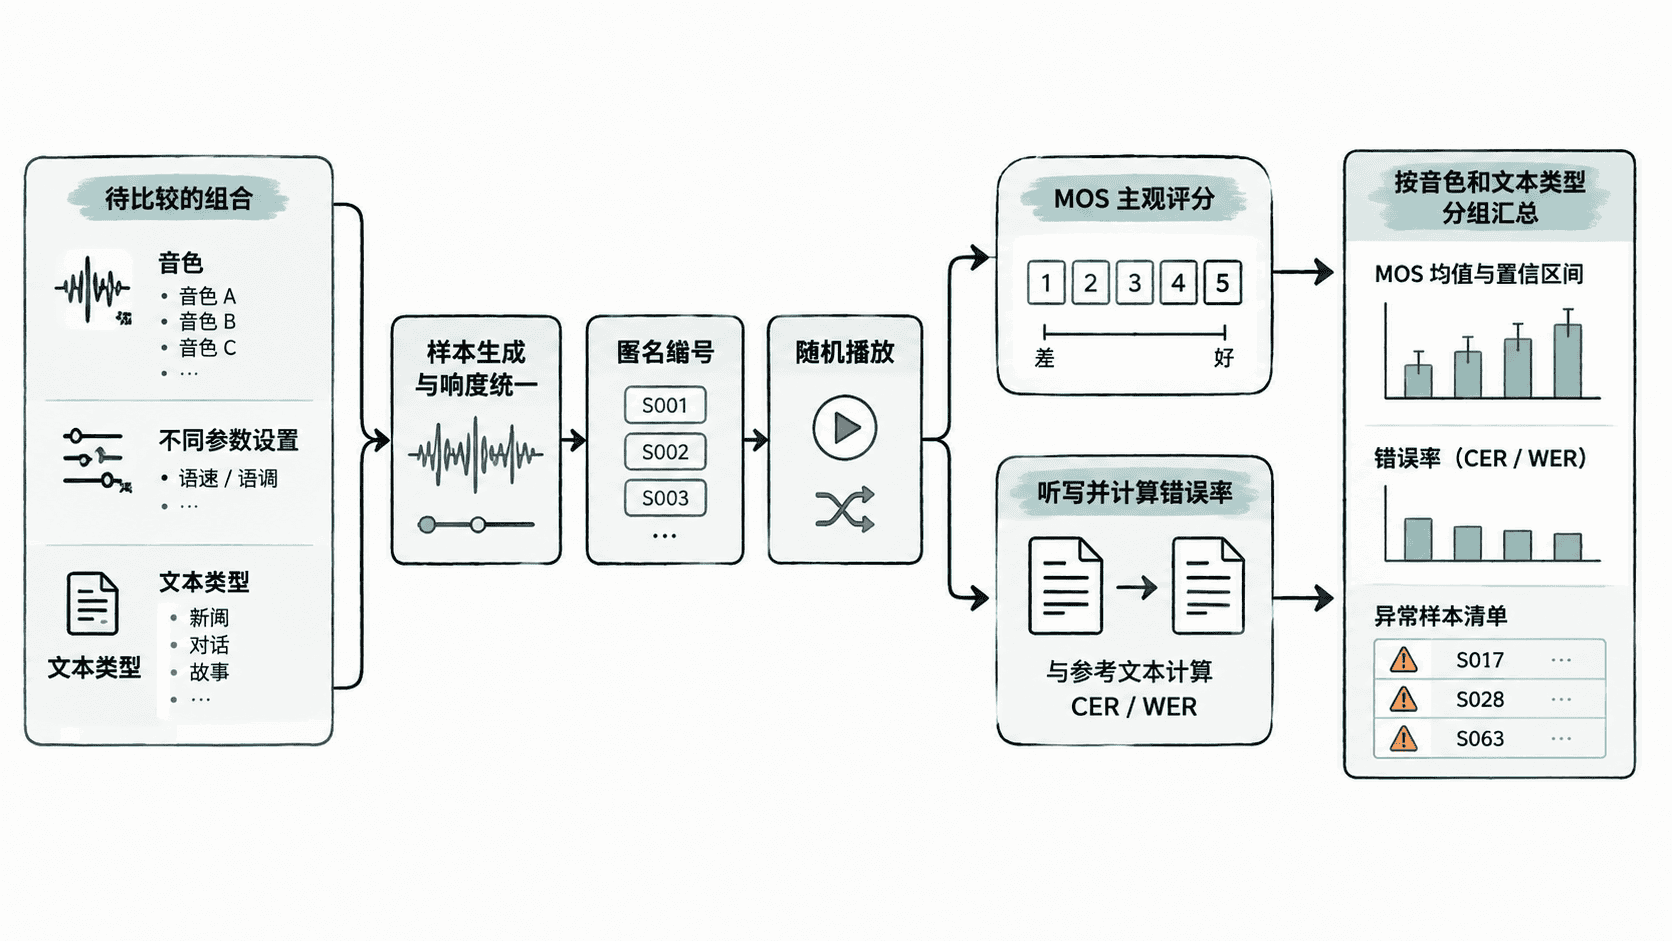
设计能比较的样本集
先确定你真正要做的产品决策,例如比较 A、B 两个音色,或比较语速 0.9、1.0、1.1。除了待比较变量,其他条件尽量固定:文本、采样率、后处理、播放音量和设备条件不应随方案变化,否则最终分数无法解释。
文本不要只选普通陈述句。一个更有诊断价值的集合应覆盖短句、长句、数字日期、英文缩写、专有名词、标点停顿和容易产生多音字歧义的句子。每种类型都准备多个样本,避免某一句文本偶然适配某个音色而拉高整体结果。
播放顺序应随机化,并隐藏音色或模型名称。若同一位听众连续听大量近似样本,疲劳会显著降低评分稳定性,因此可把实验拆成多个短批次。对比产品方案时,最好让各方案在同一批听众和同一批文本上出现,这样差异更容易归因到 TTS 本身。
汇总 MOS 和可懂度
MOS 最基本的汇总是分组平均值,但还应同时记录样本量和离散程度。两个方案平均分分别为 4.20 和 4.25,如果评分波动很大、样本又少,这个差距未必有产品意义。可以给平均值计算近似 95% 置信区间,用来观察结果稳定性。
可懂度测试可以让听众在不知道原文的情况下转写内容,再与参考文本比较。中文场景常用字符错误率 CER,英文或已经可靠分词的场景可以使用 WER。两者都可基于编辑距离统计替换、删除和插入,其中:
是替换数, 是删除数, 是插入数, 是参考文本字符数。错误率越低越好,但不要把标点、空格和大小写处理规则留到统计阶段才临时决定,否则不同批次无法复现。
下面的 Python 示例同时计算一组 MOS 的均值与近似 95% 置信区间,并计算中文听写的 CER。它只使用标准库,可以直接运行。
import math
import statistics

def edit_distance(reference: list[str], hypothesis: list[str]) -> int:
    # dp[j] 表示当前行到 hypothesis[:j] 的最小编辑次数。
    dp = list(range(len(hypothesis) + 1))
    for i, ref_token in enumerate(reference, start=1):
        current = [i]
        for j, hyp_token in enumerate(hypothesis, start=1):
            replace_cost = 0 if ref_token == hyp_token else 1
            current.append(
                min(
                    current[j - 1] + 1,
                    dp[j] + 1,
                    dp[j - 1] + replace_cost,
                )
            )
        dp = current
    return dp[-1]

def mos_interval(scores: list[int]) -> tuple[float, float, float]:
    mean = statistics.mean(scores)
    std = statistics.stdev(scores)
    half_width = 1.96 * std / math.sqrt(len(scores))
    return mean, mean - half_width, mean + half_width

def cer(reference: str, hypothesis: str) -> float:
    distance = edit_distance(list(reference), list(hypothesis))
    return distance / len(reference)

def main() -> None:
    scores = [4, 4, 5, 3, 4, 4, 5, 4]
    reference = "请在会议结束后发送纪要"
    hypothesis = "请在会议结束后发送记要"

    mean, low, high = mos_interval(scores)
    print(f"MOS={mean:.3f}, 95% CI≈[{low:.3f}, {high:.3f}]")
    print(f"CER={cer(reference, hypothesis):.2%}")

if __name__ == "__main__":
    main()
预期输出:
MOS=4.125, 95% CI≈[3.681, 4.569]
CER=9.09%
这里的 95% 区间使用正态近似,更适合快速产品评测而不是严格统计推断。样本很少、评分分布明显偏斜或需要正式实验结论时,应使用更合适的统计方法,并保留原始逐条评分,而不是只保存最终平均数。
让结果能够指导产品选择
最终报表至少要按音色/参数和文本类型两个维度切分。整体 MOS 很高但“数字日期”CER 明显偏高,说明模型并不是全面更优;相反,某个音色自然度略低,却在导航、播报或验证码场景里可懂度更稳定,也可能更符合业务目标。
| 指标 | 主要回答的问题 | 方向 |
|---|---|---|
| MOS 均值与区间 | 听起来是否自然、舒服、整体质量是否稳定 | 越高越好 |
| CER/WER | 内容是否被准确听懂 | 越低越好 |
| 分文本类型结果 | 问题集中在哪类内容 | 找异常分组 |
| 原始评分与转写 | 是否存在少量严重失败样本 | 必须保留 |
如果多个方案差距很小,不要只根据第二位小数做决定。先检查差异是否在多个文本类型和多个听众上都一致,再结合首声延迟、成本、稳定性和目标场景做取舍。音质评测真正有价值的地方,不是得到一个“4.3 分”,而是能明确回答哪个方案在什么文本和什么用户任务下更可靠。