
音频开发 / 系统课时
批量转写任务并发与失败重试
批量转写任务并发与失败重试
批量转写的难点不是把多个文件同时发给识别服务,而是让坏文件、网络抖动和超时不会拖垮整批作业。本节实现一个有并发上限、超时、重试和任务状态记录的最小调度器,并给出可以直接验收的失败处理规则。
学习目标
- 设计批量转写任务的并发上限、超时与重试边界
- 为单个文件记录状态、尝试次数和最终失败原因
- 区分可重试故障与永久故障,避免无效重试放大压力
先把任务状态设计清楚
每个文件应独立拥有状态,常见最小集合为 PENDING、RUNNING、SUCCEEDED、RETRY_WAIT 和 FAILED。批次本身只负责汇总,不应因为一个文件失败就停止其他文件。
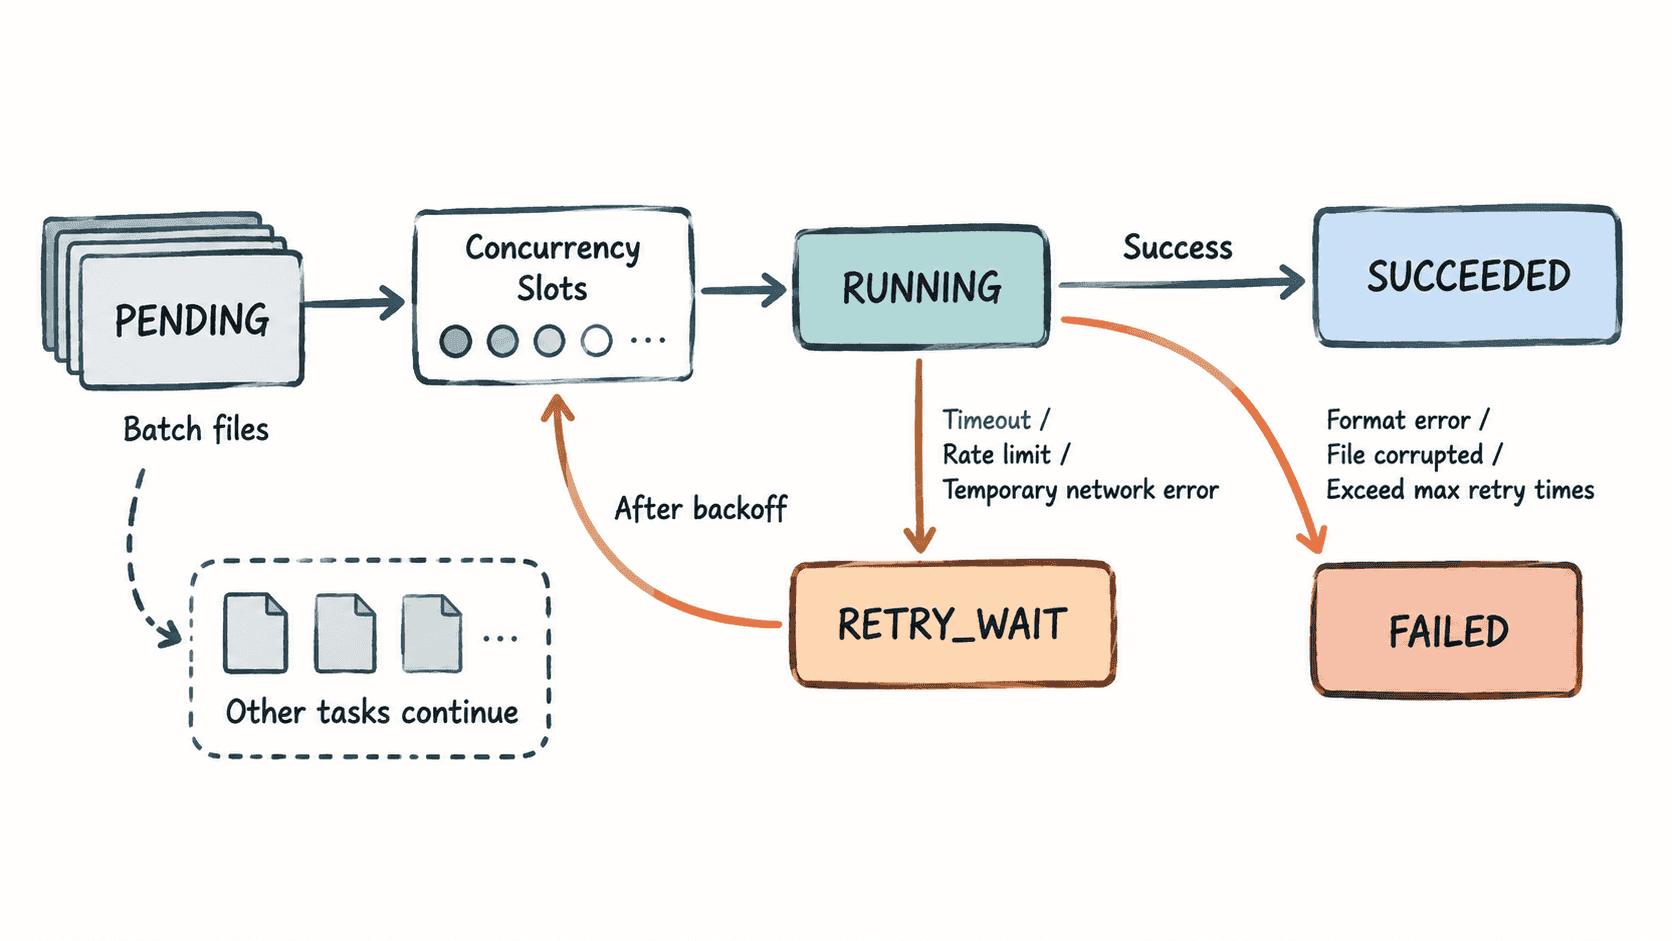
状态记录至少要能回答三个问题:任务现在在哪一步、已经尝试多少次、最后一次为什么失败。这样批次完成后可以只重跑失败项,而不是重新提交全部文件。
并发度不是越高越好
并发上限同时受本机连接数、识别服务配额、单请求耗时和文件大小影响。安全做法是先从较小并发开始,观察吞吐、超时率和服务端限流,再逐步上调。若服务端已经返回限流,继续增加并发通常只会制造更多失败和重试。
超时应针对单次识别调用,而不是整个批次。一个文件超时后释放并发槽位,让其他文件继续执行;是否重试再由错误类型和尝试次数决定。
实现一个可控的批量调度器
下面用 asyncio.Semaphore 控制最大并发数,用 asyncio.wait_for 限制单次调用时间,并对临时错误做指数退避。示例中的识别函数是可运行的本地模拟,便于稳定复现成功、超时和永久失败三种结果。
import asyncio
from dataclasses import dataclass

MAX_RETRIES = 2
TIMEOUT_SECONDS = 0.10
CONCURRENCY = 2

@dataclass
class TaskResult:
    file_name: str
    status: str
    attempts: int
    reason: str = ""

attempts_by_file: dict[str, int] = {}

async def transcribe(file_name: str) -> str:
    attempts_by_file[file_name] = attempts_by_file.get(file_name, 0) + 1
    attempt = attempts_by_file[file_name]

    if file_name == "broken.wav":
        raise ValueError("unsupported audio format")
    if file_name == "slow.wav" and attempt < 3:
        await asyncio.sleep(0.20)
    else:
        await asyncio.sleep(0.01)
    return f"text:{file_name}"

def is_retryable(error: Exception) -> bool:
    return isinstance(error, asyncio.TimeoutError)

async def run_one(file_name: str, semaphore: asyncio.Semaphore) -> TaskResult:
    for attempt in range(1, MAX_RETRIES + 2):
        try:
            async with semaphore:
                await asyncio.wait_for(transcribe(file_name), TIMEOUT_SECONDS)
            return TaskResult(file_name, "SUCCEEDED", attempt)
        except Exception as error:
            if not is_retryable(error) or attempt > MAX_RETRIES:
                return TaskResult(file_name, "FAILED", attempt, type(error).__name__)
            # 退避发生在并发槽位之外,避免等待期间占住稀缺并发。
            await asyncio.sleep(0.01 * (2 ** (attempt - 1)))

    raise RuntimeError("unreachable")

async def main() -> None:
    files = ["a.wav", "slow.wav", "broken.wav", "b.wav"]
    semaphore = asyncio.Semaphore(CONCURRENCY)
    results = await asyncio.gather(*(run_one(name, semaphore) for name in files))

    for result in sorted(results, key=lambda item: item.file_name):
        print(
            f"{result.file_name}: {result.status}, "
            f"attempts={result.attempts}, reason={result.reason or '-'}"
        )

if __name__ == "__main__":
    asyncio.run(main())
预期输出
a.wav: SUCCEEDED, attempts=1, reason=-
b.wav: SUCCEEDED, attempts=1, reason=-
broken.wav: FAILED, attempts=1, reason=ValueError
slow.wav: SUCCEEDED, attempts=3, reason=-
这里 slow.wav 前两次调用都会超过 0.10 秒,因此触发两次超时,第三次成功;broken.wav 属于格式错误,被判定为永久故障,所以不会浪费重试次数。实际服务中的具体超时值和退避时间应按接口 SLA 与文件时长调整。
只重试真正可能恢复的错误
适合重试的通常是连接中断、请求超时、服务端临时不可用和明确的限流响应。格式不支持、鉴权失败、文件损坏、参数错误等永久故障应直接失败,否则会把确定失败的请求重复打到服务端。
生产环境还应为重试加入随机抖动,避免大量任务在同一时刻同时恢复并再次冲击服务。若服务端提供 Retry-After 一类明确等待时间,应优先遵从服务端指示,而不是完全使用本地退避公式。
批次完成不等于全部成功
一个批次的结束条件应是“所有任务都进入终态”,而不是“所有任务都成功”。最终汇总应至少包含成功数、失败数、失败原因分布和可重跑任务列表;这样坏文件不会阻塞批次,也不会被悄悄忽略。
真正稳定的批量转写流程,本质上是把并发控制、单任务隔离、错误分类和可观测状态放在同一个调度边界内。只要每个文件都能独立结束并留下可解释结果,整个批次就具备可恢复性。