
大数据与流处理 / 系统课时
设计分区键
设计分区键
分区键解决的是“哪些数据作为一个管理与粗粒度裁剪单元”,而不是替代 ORDER BY 做主要查询加速。本课从保留周期、时间范围、数据规模和管理动作出发,设计一个不过度碎片化的 MergeTree 分区方案,并用系统表验证实际 Part 分布。
学习目标
- 区分
PARTITION BY与ORDER BY在 MergeTree 物理布局中的职责 - 根据保留周期、数据规模和批量管理动作选择合适的时间粒度
- 识别高基数分区与过多小 Part 的风险,并用
system.parts验证结果
先明确分区键负责什么
MergeTree 表中的每个数据 Part 只属于一个分区,后台 merge 也只会在同一分区内进行。PARTITION BY 因而特别适合按时间批量删除、移动、冻结或归档数据,也能让查询先按分区表达式做粗粒度裁剪。
真正决定 Part 内数据排序、稀疏主键索引效果和常见过滤路径的,通常是 ORDER BY。如果表没有明确的生命周期分组或批量分区操作需求,完全可以不声明 PARTITION BY,而不是为了“看起来完整”强行分区。
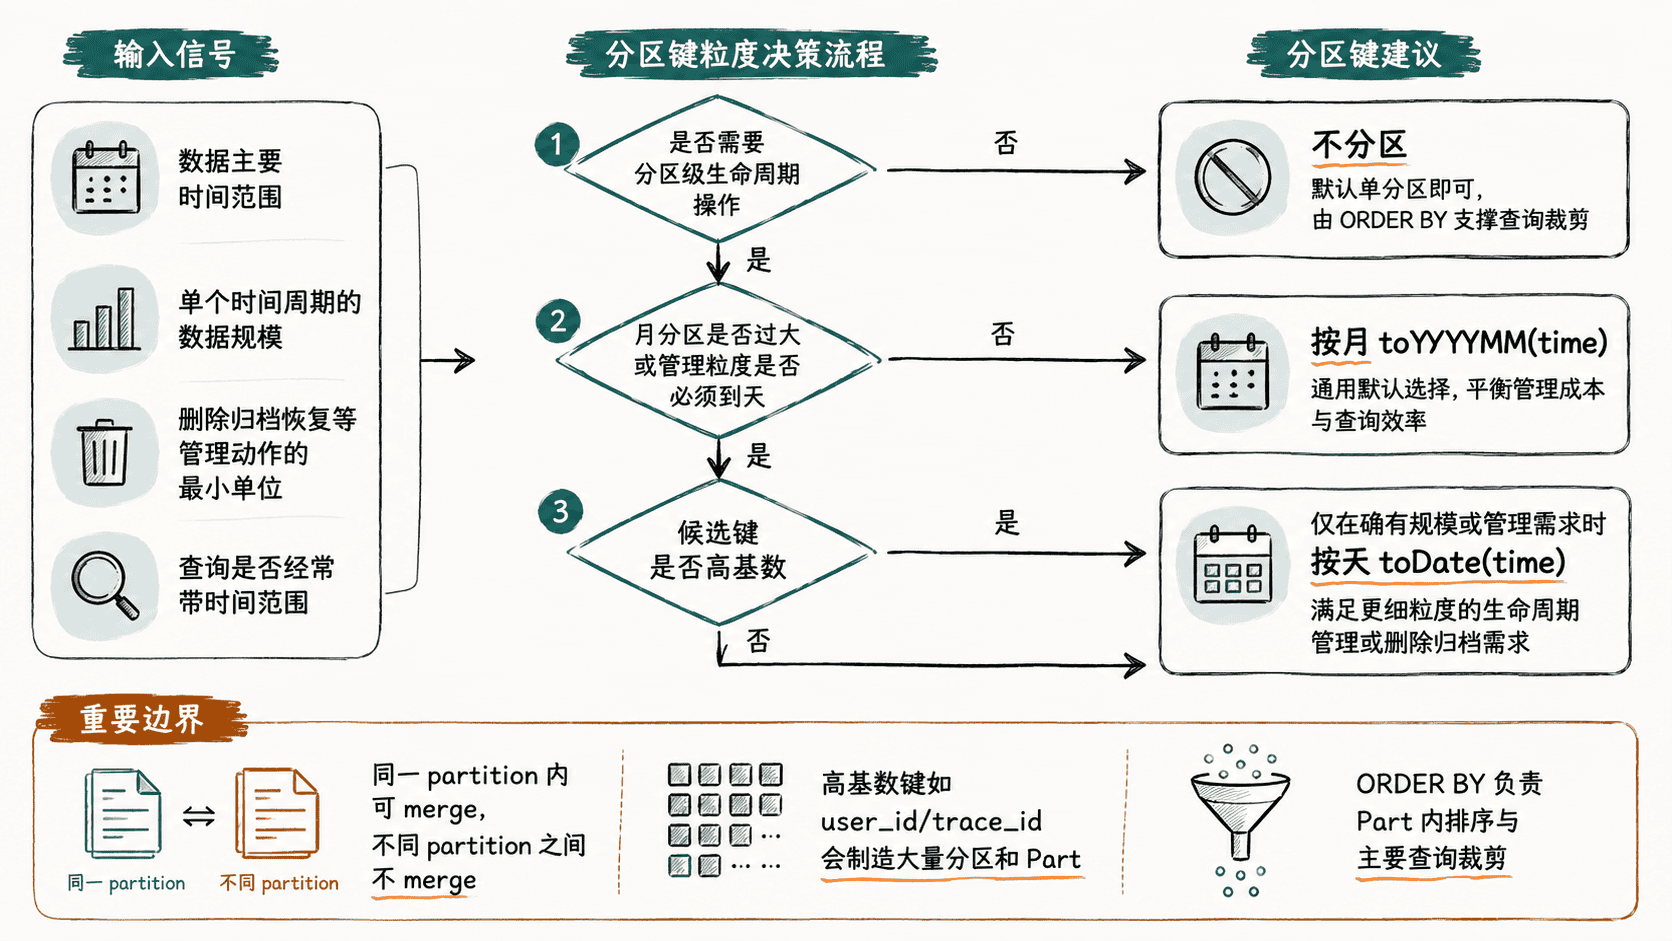
用三个问题决定分区粒度
先看管理动作的最小单位。如果数据按自然月到期、归档或恢复,月分区通常是很稳妥的起点;只有确实要求按天整体删除、迁移,或单月数据已经大到不利于管理时,才有理由进一步细化到天。
再看一个周期内会产生多少 Part。分区越细,活跃分区越多,写入越容易在多个分区中同时创建 Part,而不同分区之间又不能互相合并。没有必要为了缩小单个分区而持续细分,因为大量小分区和小 Part 会增加元数据、后台 merge 与查询调度开销。
最后看查询是否能利用时间范围。分区裁剪要求查询条件能够约束分区表达式;如果最常见条件是租户、设备或订单,而时间只是辅助条件,应把这些高价值过滤列优先考虑进 ORDER BY,不要把高基数实体 ID 直接拿来分区。
| 场景 | 建议起点 |
|---|---|
| 长期保存的事件、订单、日志,常按月管理 | PARTITION BY toYYYYMM(event_time) |
| 超大规模短保留日志,运维动作必须按天执行 | 在验证 Part 数量可控后考虑 PARTITION BY toDate(event_time) |
| 小表或没有分区级删除、迁移需求 | 可以不分区 |
想按 user_id、order_id、trace_id 分区 |
通常不要做,高基数会制造大量分区 |
创建按月分区的事件表并验证
下面的表按月分区,但把常用的租户过滤放在排序键前部。一次写入跨越两个自然月后,可以直接从 system.parts 看到两个分区及其行数。
DROP TABLE IF EXISTS page_events;

CREATE TABLE page_events
(
    event_time DateTime,
    tenant_id UInt32,
    event_type LowCardinality(String),
    value UInt32
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(event_time)
ORDER BY (tenant_id, event_time);

INSERT INTO page_events VALUES
    ('2026-08-30 10:00:00', 1, 'view', 1),
    ('2026-08-31 11:00:00', 2, 'view', 1),
    ('2026-09-01 09:00:00', 1, 'click', 1);

SELECT
    partition,
    sum(rows) AS rows
FROM system.parts
WHERE database = currentDatabase()
  AND table = 'page_events'
  AND active
GROUP BY partition
ORDER BY partition;
预期结果
┌─partition─┬─rows─┐
│ 202608    │    2 │
│ 202609    │    1 │
└───────────┴──────┘
partition 展示的是实际分区标识。这里没有按 tenant_id 分区,因此租户数量增长不会直接把分区数量放大;租户过滤仍然可以利用 ORDER BY (tenant_id, event_time) 对 Part 内数据进行裁剪。
控制分区数量与数据碎片
最危险的模式通常是高基数分区,例如 PARTITION BY user_id。如果一次批量写入包含成千上万个用户,ClickHouse 可能需要同时为大量分区创建新 Part;这些 Part 以后又无法跨分区合并,最终形成持续的碎片化和 too many parts 风险。
时间分区也不是越细越好。按小时甚至更细粒度分区,往往只是把可以在一个分区内合并的 Part 人为隔开。判断是否需要从月改成天时,应观察真实写入量、活跃 Part 数、保留策略和运维动作,而不是套用固定行数阈值。
如果使用 ReplacingMergeTree、SummingMergeTree 或 AggregatingMergeTree,还要额外检查业务上需要收敛的同键数据是否会跨分区。因为 merge 不跨分区,同一订单的两个版本如果被分到不同月份,后台替换或聚合语义就无法在物理合并阶段完成。
让分区键和其他物理设计分工
可以把物理设计职责拆成三层:PARTITION BY 管大块数据的生命周期与粗裁剪,ORDER BY 管 Part 内排序和主要过滤路径,TTL 或分区级操作负责数据过期与迁移。这样设计时,分区键不需要承载所有查询优化目标。
一个实用的默认策略是:时间型大表先从月分区开始,没有明确管理需求就不分区;只有真实数据规模或运维粒度证明月分区不合适时,再细化到天,并持续检查每个分区的活跃 Part 数量。