
大数据与流处理 / 系统课时
优化分布式聚合
优化分布式聚合
分布式聚合慢,通常不是 GROUP BY 本身算不动,而是分片产生的中间聚合状态太多、网络传输太大,最后又集中到协调节点合并。本课从执行链路入手,判断哪些工作应该留在分片、哪些结果必须跨网传输,以及什么时候可以安全消除协调端的二次聚合。
学习目标
- 解释分片内部分聚合、网络传输和协调节点合并的职责
- 根据分组基数与分片键判断中间结果为什么放大
- 使用分片键优化和查询日志验证协调节点是否真正降压
看清聚合的三段成本
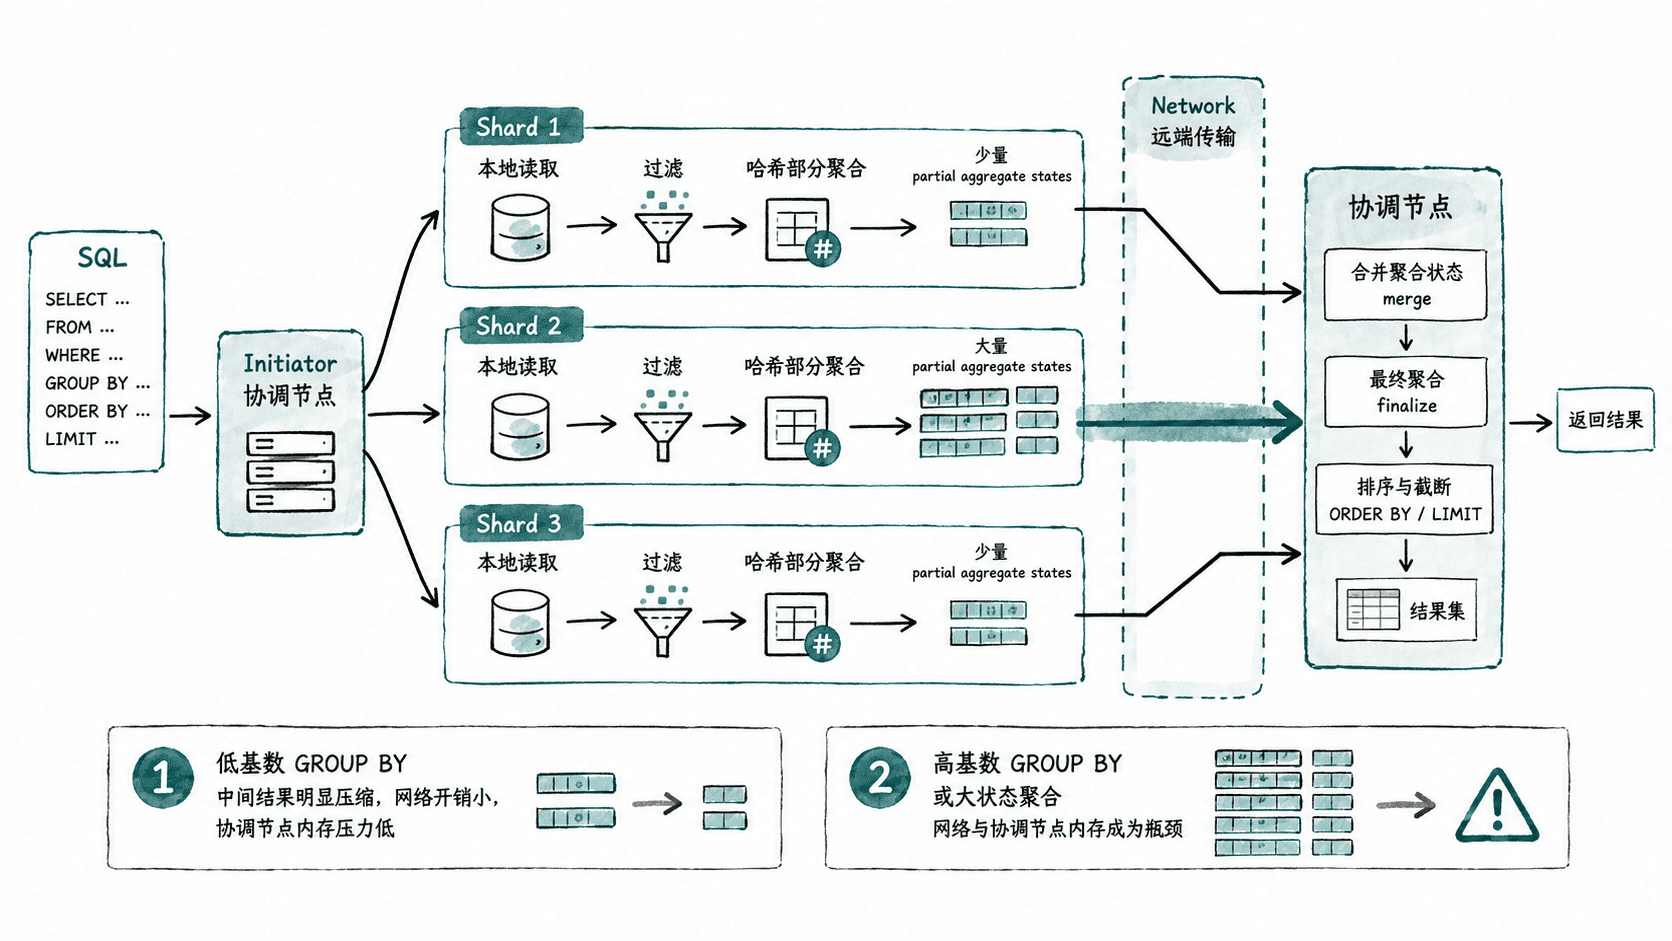
在经典 Distributed 查询路径中,发起查询的节点把子查询发送到各分片。每个分片先读取本地数据并执行过滤、表达式计算和部分聚合,再把聚合后的结果或聚合状态发回发起节点,最后由发起节点合并同一分组键的状态并完成排序、限制等后续处理。
因此,网络成本更接近“每个分片产生的分组数 × 每个聚合状态大小”,而不是原始扫描行数。低基数维度配合 sum、count 往往压缩得很好;高基数键或 uniqExact 这类状态较大的聚合,即使已经在分片内聚合,中间结果仍可能很重。
先把中间结果压小
第一层优化是让过滤尽早发生,并避免把不需要的维度带进 GROUP BY。例如报表只需要按 user_id 汇总流量,就不要同时分组 url、request_id 等高基数字段;否则每个分片都会保留更多哈希表条目,中间结果接近明细规模。
聚合函数本身也影响状态大小。sum、count、avg 的状态通常较紧凑,而精确去重需要维护更大的集合状态。若业务允许近似结果,可以评估 uniq、uniqCombined 等近似去重函数;这不是语法替换,而是用精度换取更小的状态、内存与网络成本。
利用分片键消除重复合并
最理想的情况是 分组键与分片键一致。假设 events_dist 按 user_id 分片,并且数据始终按照这个规则写入,那么同一个 user_id 只会落到一个分片。此时协调节点没有必要再次把同一用户的聚合状态跨分片合并。
片段示例:假设集群已存在 events_dist,其 Distributed 分片键就是 user_id,且历史数据也满足这一分布约束。
SET optimize_skip_unused_shards = 1;
SET optimize_distributed_group_by_sharding_key = 1;

SELECT
    user_id,
    sum(bytes) AS total_bytes
FROM events_dist
WHERE event_date = '2026-08-31'
GROUP BY user_id
ORDER BY total_bytes DESC
LIMIT 10;
预期结果:业务结果与未启用该优化时一致;具体用户和流量值取决于数据。
<USER_ID_1>    <VALUE>
<USER_ID_2>    <VALUE>
...
optimize_distributed_group_by_sharding_key 的价值不是“让 GROUP BY 自动变快”,而是在 ClickHouse 能确认分片键包含在分组逻辑中时,避免发起节点执行昂贵的再次聚合。这个前提必须由真实数据布局保证;仅仅让 SQL 看起来包含分片键,不代表历史数据一定分布正确。
用证据判断瓶颈是否转移
优化前后应使用同一时间窗口、相同过滤条件和相同并发环境比较。重点看查询耗时、峰值内存、远端读取量以及网络相关的 ProfileEvents;如果扫描量不变而协调节点内存与网络接收明显下降,说明优化命中了真正的分布式合并成本。
如果 GROUP BY 键与分片键天然不一致,高基数聚合仍长期压垮协调端,就应回到数据模型:按主要聚合实体重新设计分片键,或用物化视图预聚合到更合适的粒度。分布式聚合的核心不是把更多工作堆到协调节点,而是尽量让每个分片先得到足够“终局化”的结果,再跨网络传输。