
大数据与流处理 / 系统课时
让过滤触发分片裁剪
让过滤触发分片裁剪
Distributed 表默认可能把查询发送到多个 shard。要真正减少远程请求,过滤条件必须能让协调节点推导出 sharding key 的取值范围。本课以 intHash64(tenant_id) 为例,开启分片裁剪,并用查询日志验证实际访问的 shard 数量。
学习目标
- 理解
optimize_skip_unused_shards在查询路由阶段做了什么 - 能把等值或
IN过滤与 sharding key 对齐,使查询只访问必要 shard - 能通过分布式查询日志核对裁剪前后的远端 shard 数量
分片裁剪发生在远程查询之前
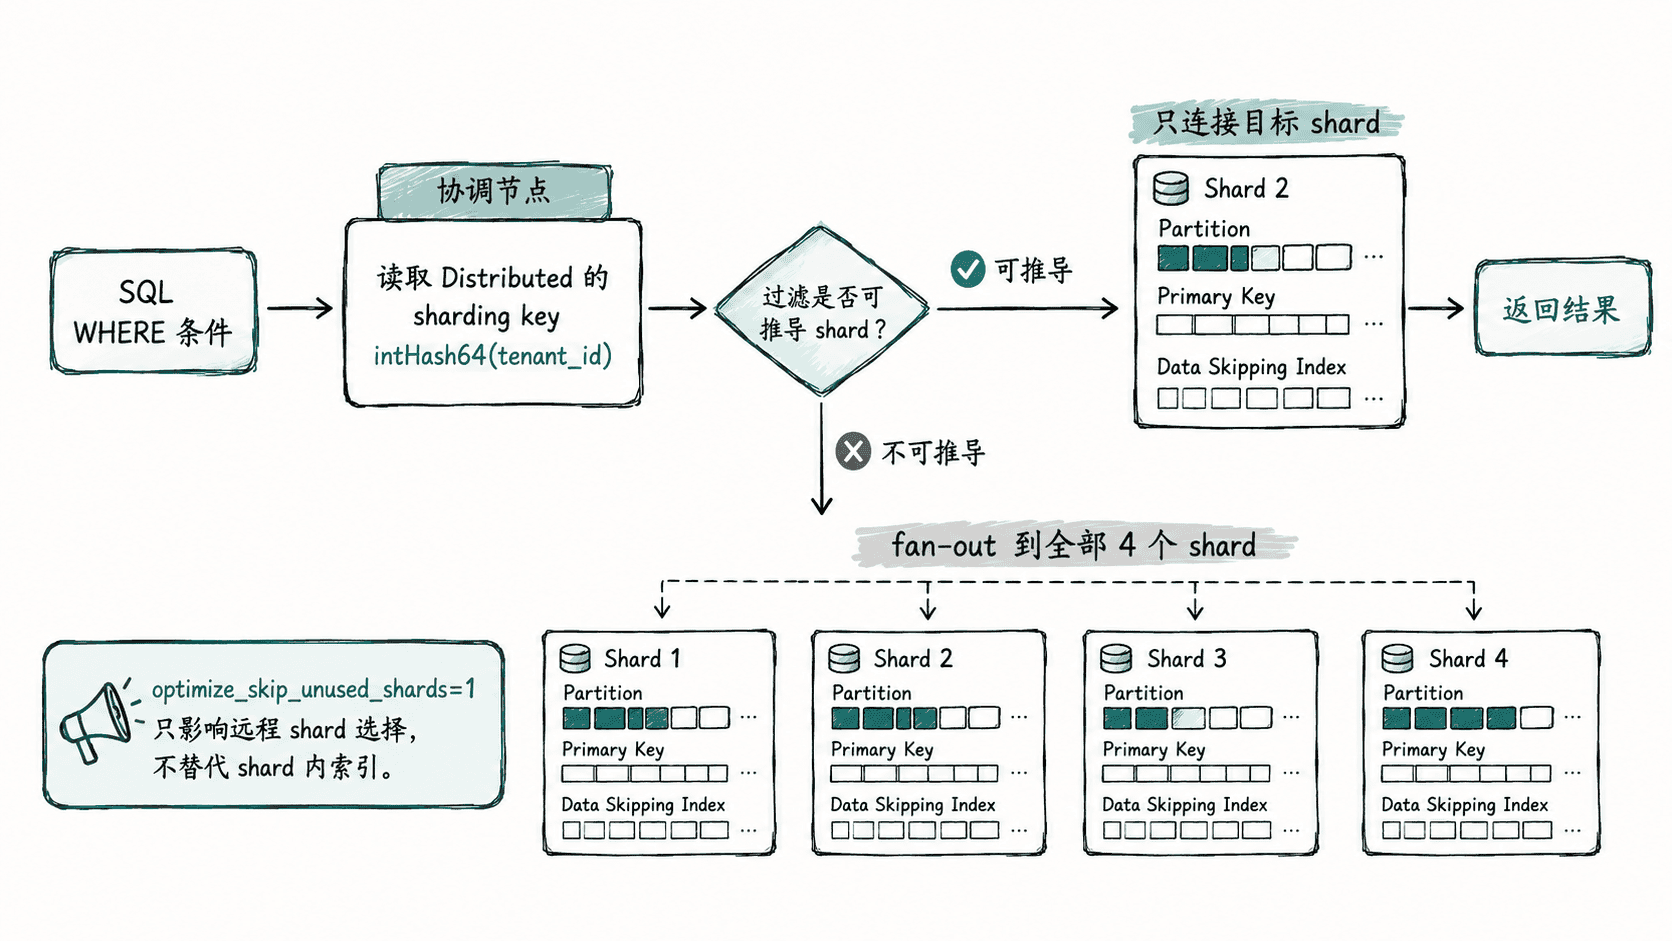
分片裁剪解决的是“要不要向这个 shard 发子查询”,它发生在各 shard 本地的 MergeTree 主键裁剪之前。协调节点先读取 Distributed 表的 sharding key,再分析常量过滤条件;如果能推导出目标 shard,就只向这些 shard 发送子查询,随后每个目标 shard 再用自己的 PARTITION BY、ORDER BY 和 skipping index 缩小本地读取范围。
让过滤条件与分片表达式对齐
假设分布式表定义为 Distributed(..., intHash64(tenant_id))。最容易裁剪的是对 tenant_id 的常量等值和有限集合过滤,因为协调节点可以计算这些常量经过同一表达式后会落到哪些 shard。只按 event_time、event_type 等非分片字段过滤时,即使本地索引很高效,协调节点通常仍需要把查询发送到所有 shard。
先确认表定义中的 sharding key,避免只看业务字段名猜测。
SHOW CREATE TABLE analytics.events_all;预期输出应包含分片表达式;实际 DDL 的其他设置可能不同。
ENGINE = Distributed('analytics_cluster', 'analytics', 'events_local', intHash64(tenant_id))然后对高频点查显式开启裁剪。下面命令假设测试数据中存在 tenant_id = 42,并给两次查询固定 query id,便于稍后统计远端子查询。
clickhouse-client --query_id prune-off --query "
SELECT count()
FROM analytics.events_all
WHERE tenant_id = 42
SETTINGS optimize_skip_unused_shards = 0"

clickhouse-client --query_id prune-on --query "
SELECT count()
FROM analytics.events_all
WHERE tenant_id = 42
SETTINGS optimize_skip_unused_shards = 1"
两次查询的业务结果应一致,只是访问的 shard 数量不同。
<COUNT>
<COUNT>
<COUNT> 取决于测试数据;若两次结果不同,应先排查数据路由或副本一致性,而不是继续做性能判断。
从 query_log 验证真正访问了多少 shard
只看总耗时不够,因为缓存、网络和并发会让一次测试产生噪声。更直接的证据是远端子查询落在哪些主机。等待相关记录进入 system.query_log 后,在全体副本上按 initial_query_id 汇总 is_initial_query = 0 的记录。
SELECT
    initial_query_id,
    uniqExact(hostName()) AS remote_hosts
FROM clusterAllReplicas('analytics_cluster', system.query_log)
WHERE type = 'QueryFinish'
  AND is_initial_query = 0
  AND initial_query_id IN ('prune-off', 'prune-on')
GROUP BY initial_query_id
ORDER BY initial_query_id;
在 4 shard、每 shard 1 replica 的测试集群里,等值过滤可被推导时,预期结果类似下面这样。
prune-off    4
prune-on     1
如果日志中暂时没有对应记录,先按集群既有运维方式刷新或确认 query_log 已启用,再重复统计。生产集群有多个 replica 时,关注“实际被远端子查询命中的 shard 数”而不是机械套用上面的主机数。
识别不会裁剪的过滤写法
是否裁剪取决于协调节点能否从过滤条件安全地推出 shard 集合,而不是查询里有没有 WHERE。可以用下面的判断表快速筛选:
| 过滤条件 | 对 intHash64(tenant_id) 的典型结果 |
|---|---|
tenant_id = 42 |
可计算单个键,通常可裁剪到一个 shard |
tenant_id IN (42, 43) |
可计算有限键集合,只访问对应 shard |
event_time >= ... |
与 sharding key 无直接映射,通常访问全部 shard |
event_type = 'purchase' |
与 sharding key 无直接映射,通常访问全部 shard |
对 tenant_id 做难以反推的复杂表达式 |
需要实测,不能假定一定裁剪 |
不要为了让分片裁剪生效就把所有过滤字段都塞进 sharding key。sharding key 首先决定数据布局,查询裁剪只是这个布局带来的收益之一。若大部分查询根本不携带分片键,应该重新审视分片策略、查询入口或预聚合设计,而不是仅靠开启设置期待消除 fan-out。
对于关键查询,可以在测试或受控会话中使用 force_optimize_skip_unused_shards 把“应该裁剪却没有裁剪”变成显式失败,但上线前要先验证当前 SQL 形态和 ClickHouse 版本对相关表达式的支持范围。可靠的验收标准始终是:业务结果一致,远端 shard 数减少,并且这种减少能在真实查询日志中重复观察到。