
大数据与流处理 / 系统课时
选择 MergeTree 家族引擎
选择 MergeTree 家族引擎
面对明细事实、重复版本和预聚合结果时,真正要选的是合并语义,而不是“哪个引擎更快”。本课用同一业务键说明四类 MergeTree 家族引擎如何处理同键行,并给出可以直接验证的选择边界。
学习目标
- 根据明细保留、版本替换、数值求和和聚合状态合并四类需求选择引擎
- 理解后台合并是异步的,知道查询何时需要
FINAL或再次聚合 - 明确
ORDER BY决定同键范围,不把排序键误当作唯一约束
先从合并语义做选择
MergeTree 家族都把写入形成不可变数据 Part,并在后台持续合并 Part。普通 MergeTree 的合并主要重组数据,不会因为排序键相同就自动删除明细;另外三类引擎则在合并时附加“替换、求和或合并聚合状态”的规则。
因此先问一个问题:同一排序键出现多行时,最终希望保留什么? 如果答案只是“全部保留”,就从 MergeTree 开始;只有业务语义明确要求收敛时,才选择特殊引擎。
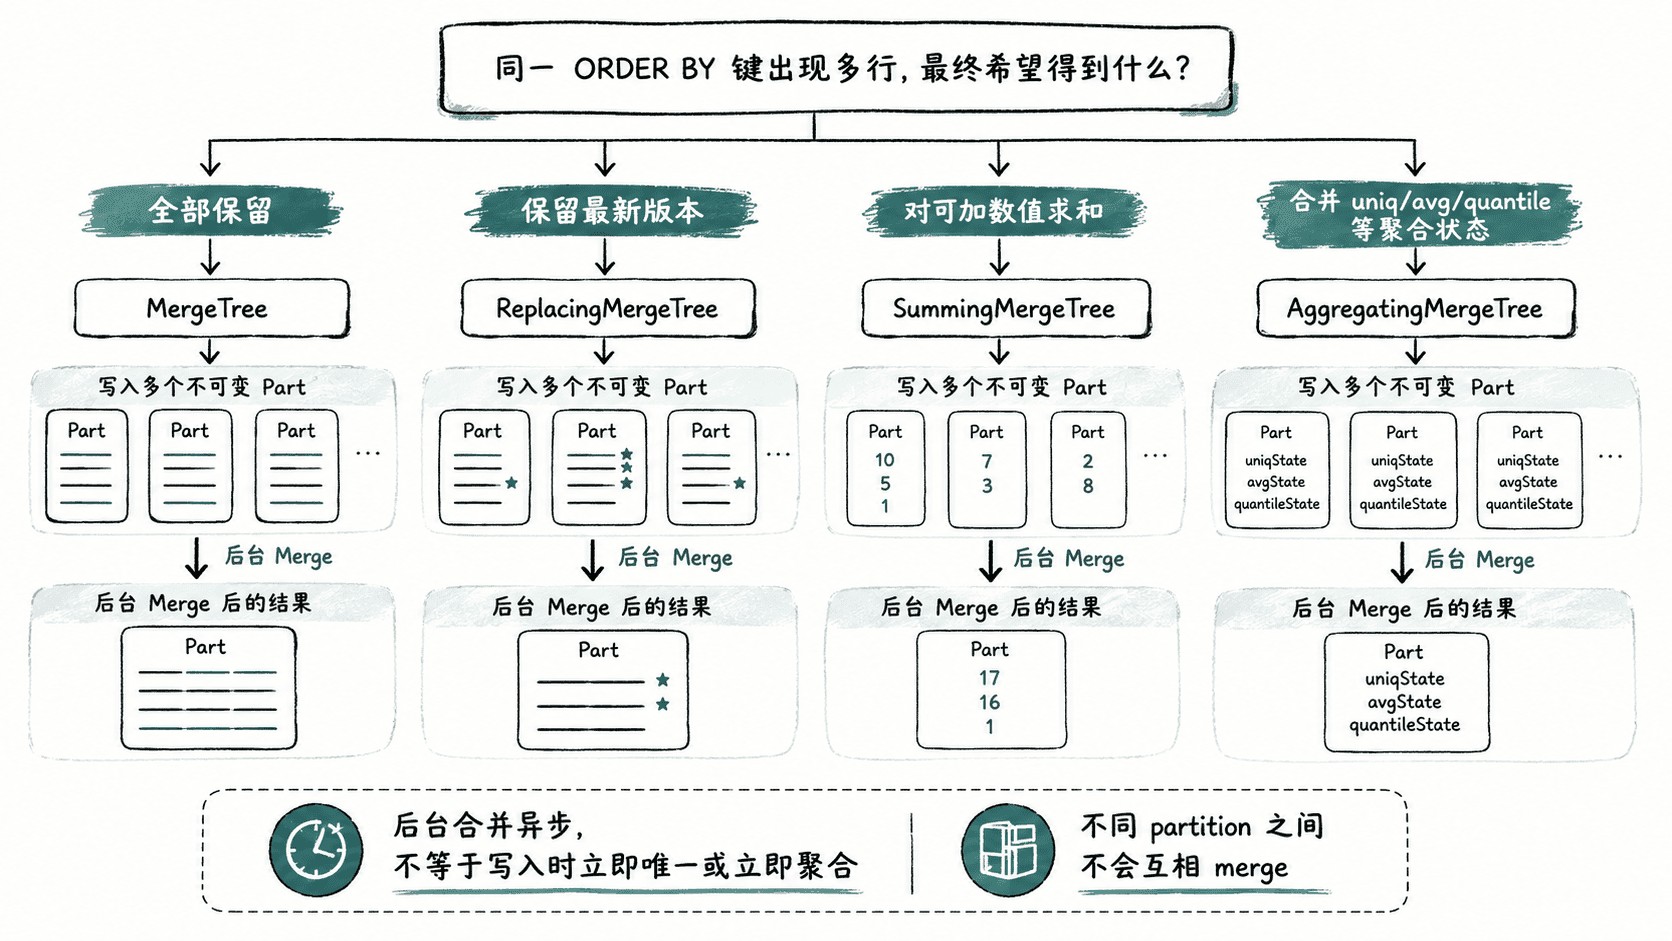
四类引擎的适用边界
| 引擎 | 同排序键行的合并语义 | 典型场景 | 查询侧要点 |
|---|---|---|---|
MergeTree |
保留所有明细 | 事件流、日志、不可变事实 | 直接按事实查询 |
ReplacingMergeTree |
保留一个版本,可用版本列决定较新记录 | CDC、维表当前状态、幂等重放后的去重 | 合并前可能同时看到多个版本;需要立即去重时可用 FINAL |
SummingMergeTree |
对同键的可加数值列做求和 | 按天、店铺、产品等维度保存增量计数或金额 | 查询仍应用 sum() 与 GROUP BY 兜住尚未完成的后台合并 |
AggregatingMergeTree |
合并 AggregateFunction 或 SimpleAggregateFunction 状态 |
uniq、avg、分位数等不能靠普通数值相加完成的预聚合 |
AggregateFunction 通常用 *State 写入、*Merge 读取 |
ReplacingMergeTree 不是唯一约束。新版本写入后,旧版本何时被清理由后台 merge 决定;SummingMergeTree 和 AggregatingMergeTree 也同样依赖后台合并,所以不能把“磁盘上已经物理收敛”当成查询正确性的前提。
用 ReplacingMergeTree 验证版本替换
下面建立一张订单当前状态表。order_id 是排序键,version 是递增版本号;同一订单重复到达时,通过 ReplacingMergeTree(version) 让更高版本成为保留候选。
DROP TABLE IF EXISTS orders_rmt;

CREATE TABLE orders_rmt
(
    order_id UInt64,
    status LowCardinality(String),
    amount UInt32,
    version UInt64
)
ENGINE = ReplacingMergeTree(version)
ORDER BY order_id;

INSERT INTO orders_rmt VALUES
    (1001, 'pending', 120, 1),
    (1001, 'paid',    120, 2),
    (1002, 'paid',     80, 1);

SELECT order_id, status, amount, version
FROM orders_rmt FINAL
ORDER BY order_id;
预期结果
┌─order_id─┬─status─┬─amount─┬─version─┐
│     1001 │ paid   │    120 │       2 │
│     1002 │ paid   │     80 │       1 │
└──────────┴────────┴────────┴─────────┘
这里使用 FINAL 是为了在查询阶段应用替换语义,因此不必等待后台 merge。它适合需要立即得到去重结果的查询,但会增加读取工作量;不要把频繁执行 OPTIMIZE TABLE ... FINAL 当成日常去重机制。
什么时候改用求和或聚合状态
如果业务只需要“同一维度键上的可加增量”,例如每小时请求数、销售额增量,SummingMergeTree 更直接。目标表最好只保留分组键和真正需要求和的指标,读取时继续按同一分组键执行 sum(),这样即使新 Part 尚未合并也能得到正确总量。
如果指标是去重用户数、平均值或分位数,就不能把最终数值简单相加。此时应让 AggregatingMergeTree 存储聚合中间状态:写入侧产生 uniqState、avgState 等状态,读取侧使用对应的 uniqMerge、avgMerge。它更复杂,但能正确组合多批次的非加法聚合。
选择时守住三个边界
- 排序键定义了“同键”:特殊 MergeTree 引擎按
ORDER BY键判断哪些行可以收敛,因此排序键既要服务查询,也必须包含业务上区分实体所需的字段。 - 分区是合并边界:不同分区的 Part 不会互相 merge。如果同一业务实体的多个版本可能落入不同分区,就不能指望
ReplacingMergeTree在后台把它们替换成一行。 - 特殊引擎不是万能更新机制:需要保留完整事件历史时优先用
MergeTree;只有确实需要“当前状态”或“预聚合状态”时,再把写入模型改成替换或聚合语义。
选择顺序可以压缩成一句话:先决定是否保留明细,再决定同键行要替换、求和还是合并聚合状态;如果没有明确的收敛语义,就使用普通 MergeTree。