
大数据与流处理 / 系统课时
选择 JOIN 算法与构建侧
选择 JOIN 算法与构建侧
ClickHouse 的 JOIN 性能取决于数据规模、可用内存、输入是否已经有序,以及哪一侧需要构建中间结构。本节不追求记住所有算法名,而是建立“先判断构建侧,再根据内存与排序条件选算法”的决策方法。
学习目标
- 理解 Hash 类 JOIN 为什么受构建侧大小影响
- 区分内存优先、磁盘友好与排序利用型 JOIN 的基本取舍
- 用会话级设置验证不同 JOIN 算法
先缩小构建侧
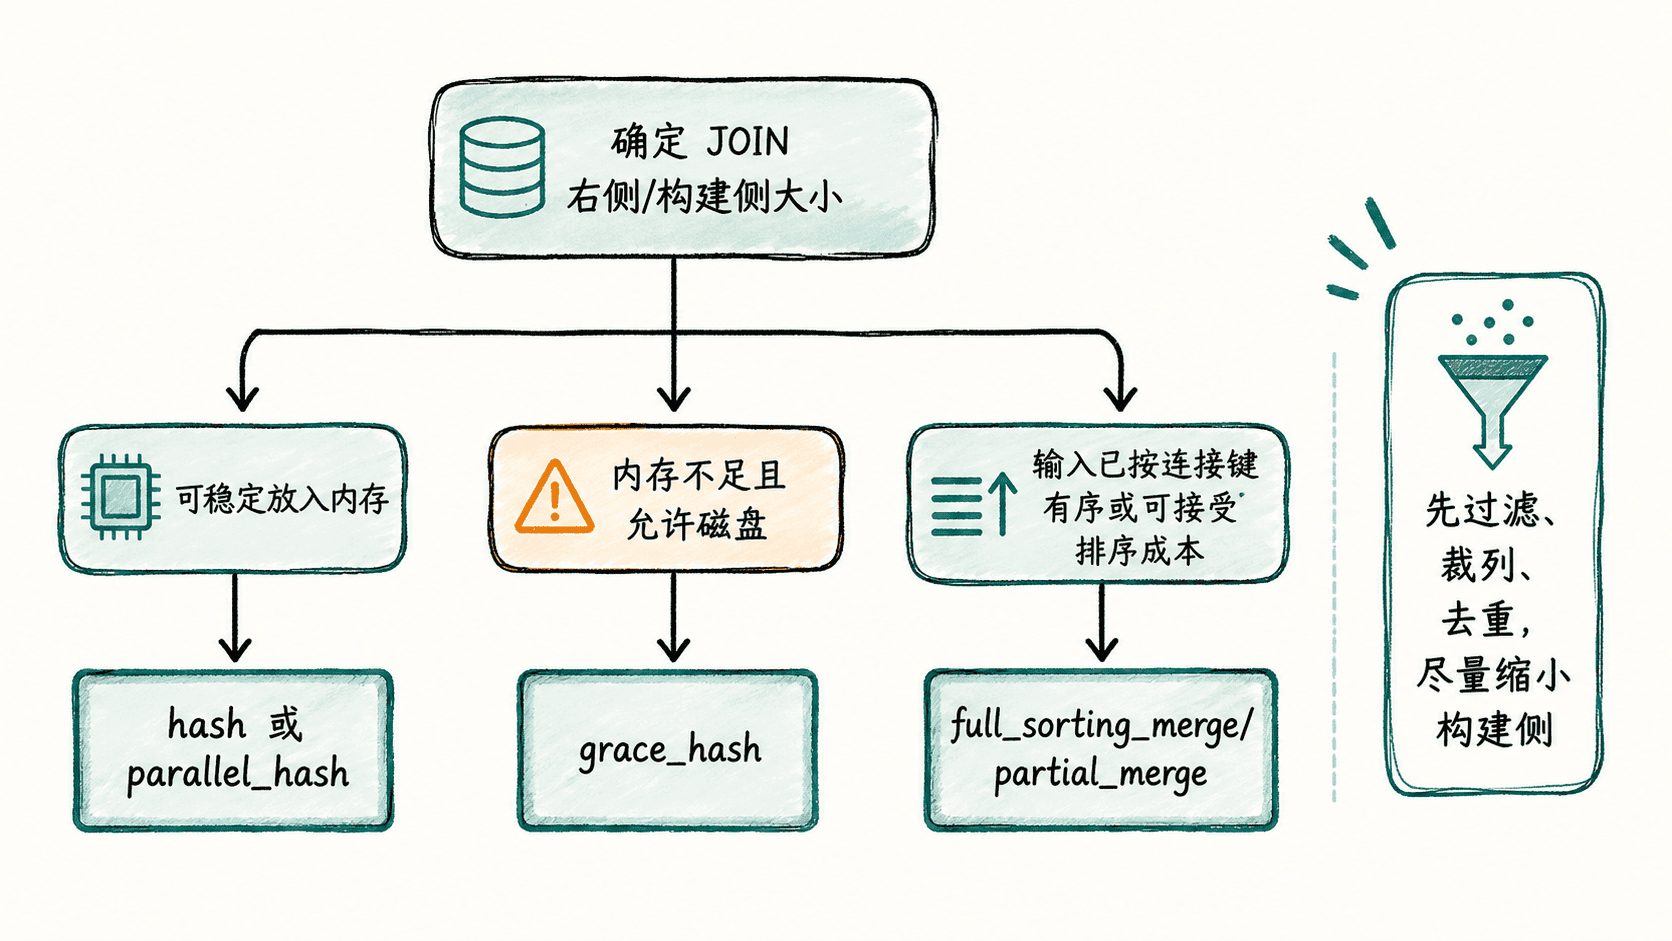
对于常见 Hash JOIN,右侧通常会被读取并构建哈希结构,因此右侧越小越容易控制内存。最直接的优化包括提前过滤、只选择必要列、避免重复键膨胀,以及在业务允许时把更小的数据集放到构建侧。
sql
-- 事实表放较大数据集,维表作为更小的右侧构建侧。
-- 只保留连接和聚合需要的列,避免无关数据进入 JOIN。
CREATE TABLE IF NOT EXISTS join_fact_demo
(
    user_id UInt64,
    amount UInt64
)
ENGINE = MergeTree
ORDER BY user_id;

CREATE TABLE IF NOT EXISTS join_dim_demo
(
    user_id UInt64,
    segment LowCardinality(String)
)
ENGINE = MergeTree
ORDER BY user_id;

INSERT INTO join_fact_demo VALUES (1, 100), (2, 200), (3, 300);
INSERT INTO join_dim_demo VALUES (1, 'A'), (2, 'B');

SELECT
    d.segment,
    sum(f.amount) AS revenue
FROM join_fact_demo AS f
INNER JOIN join_dim_demo AS d ON f.user_id = d.user_id
GROUP BY d.segment
ORDER BY d.segment;
预期结果:
text
A    100
B    200
用内存与排序条件选择算法
hash 适合构建侧能放进内存的常见等值连接;parallel_hash 可以增加构建与探测阶段的并行度,但通常需要更多内存。grace_hash 会分桶并允许使用磁盘,更适合内存放不下的大连接。full_sorting_merge 与 partial_merge 通过排序和归并换取更低的内存压力,在输入顺序可利用时可能更有优势。
用会话设置做对照验证
sql
-- 临时切换 JOIN 算法,保持 SQL 与输入数据不变。
SET join_algorithm = 'grace_hash';

SELECT
    d.segment,
    sum(f.amount) AS revenue
FROM join_fact_demo AS f
INNER JOIN join_dim_demo AS d ON f.user_id = d.user_id
GROUP BY d.segment
ORDER BY d.segment;
预期结果:
text
A    100
B    200
结果应与前一个查询一致,区别在执行算法与资源特征。真实比较时要记录峰值内存、读写字节、耗时和并发条件,而不是只看单次时间。
连接键设计会改变成本
连接键应尽量使用稳定、紧凑且类型一致的列,避免在 ON 条件中反复做昂贵的类型转换或字符串处理。若维表语义允许,还应确认是否真的需要普通 JOIN:字典、预聚合、宽表或物化视图有时能把高频连接成本前移到写入或维护阶段。
按自己的节奏,确认真正理解。