
大数据与流处理 / 系统课时
利用有序数据优化 LIMIT
利用有序数据优化 LIMIT
LIMIT 是否真的能让查询少读数据,关键不在数字有多小,而在 ORDER BY 能否复用 MergeTree 已有的数据顺序。本课通过可复现实验判断何时可以保序读取、提前停止,何时仍需读取大量候选行再排序。
学习目标
- 判断查询的
ORDER BY是否能够复用表的排序键顺序 - 使用
optimize_read_in_order和EXPLAIN PIPELINE验证执行路径 - 识别聚合、排序表达式和排序键错位对
LIMIT优化的影响
LIMIT 提前返回的前提
MergeTree 会让每个数据 Part 内的行按照表级 ORDER BY 排序。查询如果要求相同的顺序,ClickHouse 可以从多个有序 Part 中读取并合并有序流,而不必先把全部候选行送入额外的全局排序阶段。
当下游只要求 LIMIT 10 时,一旦有序流已经产生足够结果,后续处理就可以停止继续消费数据。因此,小 LIMIT 的价值来自保序读取能够提前结束,而不是 LIMIT 本身天然减少扫描量。
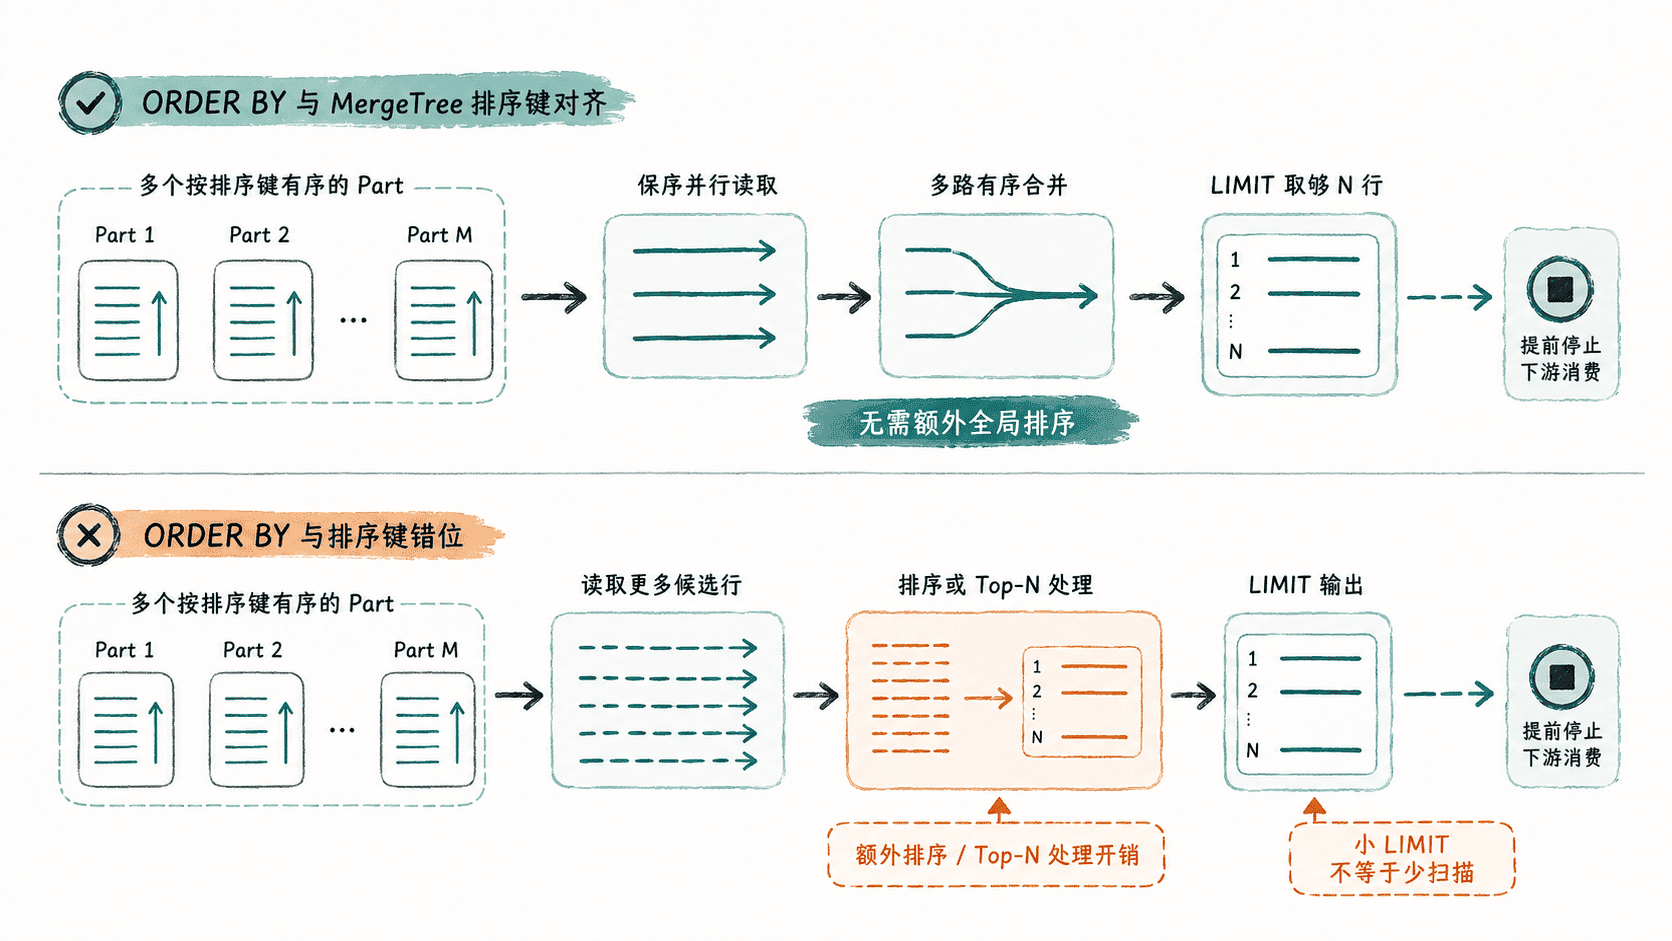
最容易利用已有顺序的情况,是最终 ORDER BY 与表排序键的前缀一致。例如表按 (event_time, id) 排序,查询也按 event_time, id 取前几行。多个 Part 并不会破坏这个原则,只是需要对各 Part 的有序输入做合并。
用最小实验对齐排序键
下面创建一个按时间与 ID 排序的表,同时执行一条排序键对齐查询和一条按 score 排序的错位查询。optimize_read_in_order 显式打开,便于明确实验条件。
DROP TABLE IF EXISTS limit_demo;

CREATE TABLE limit_demo
(
    event_time DateTime,
    id UInt64,
    score UInt32
)
ENGINE = MergeTree
ORDER BY (event_time, id);

INSERT INTO limit_demo VALUES
('2026-08-31 10:00:00', 1, 50),
('2026-08-31 10:01:00', 2, 90),
('2026-08-31 10:02:00', 3, 40),
('2026-08-31 10:03:00', 4, 100),
('2026-08-31 10:04:00', 5, 70),
('2026-08-31 10:05:00', 6, 80);

SET optimize_read_in_order = 1;

SELECT event_time, id, score
FROM limit_demo
ORDER BY event_time, id
LIMIT 3;

SELECT event_time, id, score
FROM limit_demo
ORDER BY score DESC
LIMIT 3;
预期输出:
2026-08-31 10:00:00    1    50
2026-08-31 10:01:00    2    90
2026-08-31 10:02:00    3    40

2026-08-31 10:03:00    4    100
2026-08-31 10:01:00    2    90
2026-08-31 10:05:00    6    80
第一条查询的最终顺序就是排序键前缀,因此具备保序读取条件;第二条需要按 score 重新建立顺序,不能仅凭底层 (event_time, id) 顺序直接确定前三名。这个小表用于验证语义,不适合拿耗时差异做性能结论。
从 Pipeline 判断是否额外排序
只看 SQL 文本可以做初步判断,线上排查还应检查实际 Pipeline。对两种查询分别执行 EXPLAIN PIPELINE,重点观察从 MergeTree 读取到结果输出之间是否出现为了满足最终 ORDER BY 而增加的排序处理。
EXPLAIN PIPELINE
SELECT event_time, id, score
FROM limit_demo
ORDER BY event_time, id
LIMIT 3;

EXPLAIN PIPELINE
SELECT event_time, id, score
FROM limit_demo
ORDER BY score DESC
LIMIT 3;
预期结果:
排序键对齐查询:执行链路能够复用已有有序输入,不需要为最终 ORDER BY 建立一套新的全局顺序。
排序键错位查询:执行链路需要额外的排序或 Top-N 类处理后才能确定最终 LIMIT 结果。
具体 Processor 名称、数量和并行度会随 ClickHouse 版本、Part 数量与查询设置变化。
判断时不要执着于某一个固定 Processor 名称。真正需要确认的是:最终结果能否沿已有顺序持续产生,以及 LIMIT 之前是否存在必须等待大量输入才能完成的重排阶段。
哪些写法会削弱提前返回
排序键对齐只是必要线索,不代表所有包含 LIMIT 的查询都会少读。GROUP BY、聚合后排序、窗口计算以及对排序列做复杂表达式,都可能改变数据顺序,使下游无法直接沿 MergeTree 的物理顺序输出最终结果。
例如表按 event_time 排序,但查询改成 ORDER BY toDate(event_time),不能简单地把它当成与原排序键完全等价的保序路径。类似地,ORDER BY score DESC LIMIT 10 即使只有十行结果,也可能需要检查大量候选行才能知道谁真正进入前十。
当高频查询长期围绕固定排序维度取前 N 行时,应把这种访问模式纳入排序键设计;如果排序需求彼此冲突,则需要在排序键、Projection、物化结果或额外计算成本之间做取舍。