
大数据与流处理 / 系统课时
设计增量物化视图
设计增量物化视图
增量 Materialized View 适合把过滤、路由和预聚合前移到写入阶段,让高频查询直接读取已经缩小或聚合后的目标表。本课通过跨两个插入批次的聚合示例,说明触发模型、目标表合并语义、历史回填和一致性边界。
学习目标
- 理解增量 Materialized View 只处理新插入数据块的触发模型
- 为过滤、路由与预聚合选择匹配语义的目标表引擎
- 使用
AggregatingMergeTree与State/Merge组合正确合并跨批次聚合状态
从写入链路设计目标表
增量 Materialized View 可以理解为源表上的插入触发器:每个新插入数据块到达时,视图的 SELECT 只处理这个数据块,再把结果写入目标表。它不会因为源表后来发生 mutation、分区删除或右侧维表变化而自动重算历史结果。
这意味着目标表必须表达“多个插入批次最终如何合并”。纯过滤或路由通常写入普通 MergeTree;只做可加和的计数、求和可以评估 SummingMergeTree;需要 avg、uniq、分位数等可合并聚合状态时,应优先使用 AggregatingMergeTree。
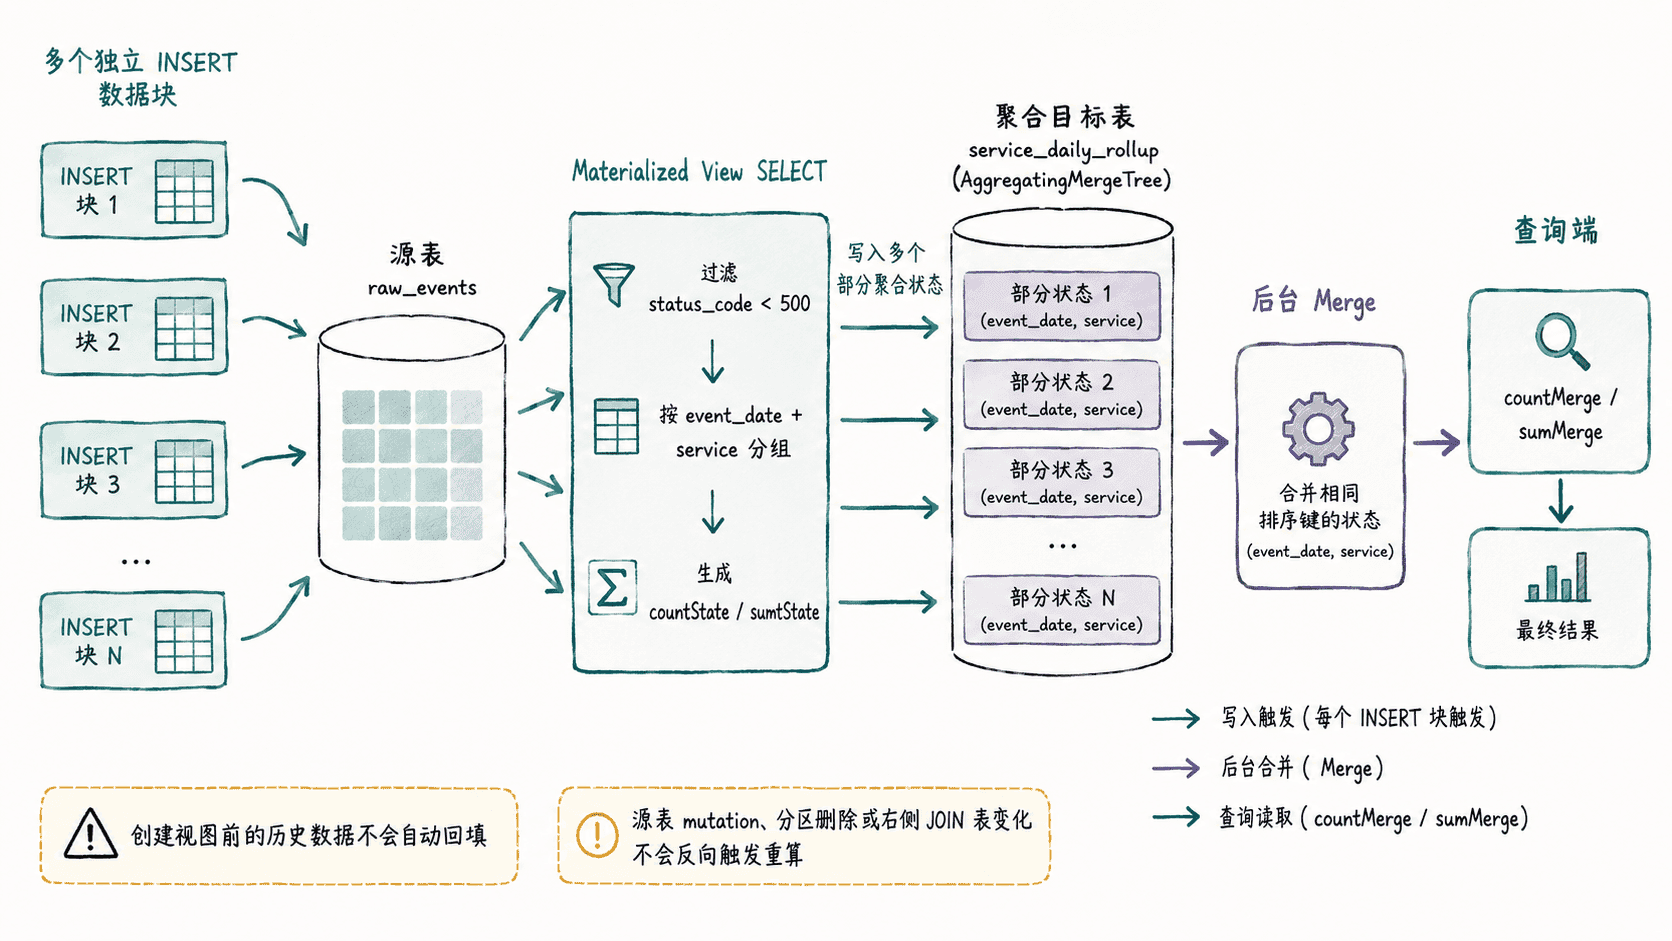
用聚合状态跨批次累加
下面把服务请求按天和服务名预聚合。status_code >= 500 的事件在写入目标表前被过滤;同一天同一服务即使来自不同插入批次,也会以聚合状态写入同一逻辑粒度。
DROP TABLE IF EXISTS service_daily_rollup_mv;
DROP TABLE IF EXISTS service_daily_rollup;
DROP TABLE IF EXISTS raw_events;

CREATE TABLE raw_events
(
    event_time DateTime,
    service LowCardinality(String),
    status_code UInt16,
    latency_ms UInt32
)
ENGINE = MergeTree
ORDER BY (event_time, service);

CREATE TABLE service_daily_rollup
(
    event_date Date,
    service LowCardinality(String),
    requests AggregateFunction(count),
    latency_sum AggregateFunction(sum, UInt32)
)
ENGINE = AggregatingMergeTree
ORDER BY (event_date, service);

CREATE MATERIALIZED VIEW service_daily_rollup_mv
TO service_daily_rollup
AS
SELECT
    toDate(event_time) AS event_date,
    service,
    countState() AS requests,
    sumState(latency_ms) AS latency_sum
FROM raw_events
WHERE status_code < 500
GROUP BY
    event_date,
    service;

INSERT INTO raw_events VALUES
    ('2026-09-01 00:00:01', 'api', 200, 100),
    ('2026-09-01 00:00:02', 'api', 200, 150),
    ('2026-09-01 00:00:03', 'web', 503, 80);

INSERT INTO raw_events VALUES
    ('2026-09-01 00:01:01', 'api', 200, 120),
    ('2026-09-01 00:01:02', 'web', 200, 90);
预期结果
各条 DDL 与两次 INSERT 均执行成功。两批数据都会触发视图;status_code=503 的 web 事件不会写入聚合目标表。查询目标表时仍然使用对应的 Merge 函数组合各数据 part 中的状态。不要依赖“后台 merge 已经刚好完成”来获得正确结果。
SELECT
    event_date,
    service,
    countMerge(requests) AS request_count,
    sumMerge(latency_sum) AS total_latency_ms
FROM service_daily_rollup
GROUP BY
    event_date,
    service
ORDER BY service;
预期输出
┌─event_date─┬─service─┬─request_count─┬─total_latency_ms─┐
│ 2026-09-01 │ api     │             3 │              370 │
│ 2026-09-01 │ web     │             1 │               90 │
└────────────┴─────────┴───────────────┴──────────────────┘
让排序键与聚合粒度一致
目标表的 ORDER BY (event_date, service) 对应物化视图的分组粒度,使相同业务分组的聚合状态具备可合并条件。如果目标排序键遗漏了真正决定粒度的维度,数据可能被错误合并;如果塞入与分组无关的高基数字段,又会阻止本应合并的状态归并。
对于简单 sum、count,可以把目标设计成 SummingMergeTree 并在读取时继续 sum 数值列,以避免依赖后台合并时机。对于平均值、去重计数、分位数等不能只靠最终数值相加的指标,应保存 AggregateFunction 状态,并成对使用 avgState/avgMerge、uniqState/uniqMerge 等函数。
处理历史数据和变更边界
创建增量物化视图不会自动把源表中已经存在的历史数据送进目标表。生产接入时需要单独做 backfill,并确保回填 SQL 与视图使用相同的过滤、分组和聚合状态表达式。为了避免实时写入与回填发生遗漏或重复,可以冻结写入后回填,也可以明确一个时间切点,让视图只接收切点之后的数据,历史部分单独回填。
若视图中 JOIN 一个会变化的维度表,还要接受另一条一致性边界:只有源表的新 INSERT 会触发视图,右侧维度更新不会主动重算已经写入目标表的结果。因此,频繁变化的维度更适合查询时 Dictionary 查找、定期可刷新结构,或者由上游保证事件时快照,而不是假设增量视图会自动追踪维度变化。
验收写入成本与查询收益
增量物化视图把计算从查询时搬到了写入时,因此验收不能只看报表变快了多少。应同时比较源表 INSERT 延迟、每秒写入吞吐、目标表新增 part 数量、后台 merge 压力,以及目标查询扫描行数、读取字节和延迟。一个源表挂太多视图时,每次 INSERT 都会触发额外工作,可能把读取优化变成写入瓶颈。
最稳妥的设计顺序是先固定高频查询的目标粒度,再选择目标表的合并语义,最后才写 Materialized View 的 SELECT。只要“插入块如何变换、跨批次如何合并、历史数据如何补齐”三件事都能明确回答,增量物化视图就能成为可持续维护的查询加速结构。