
大数据与流处理 / 系统课时
编写慢查询排障 Runbook
编写慢查询排障 Runbook
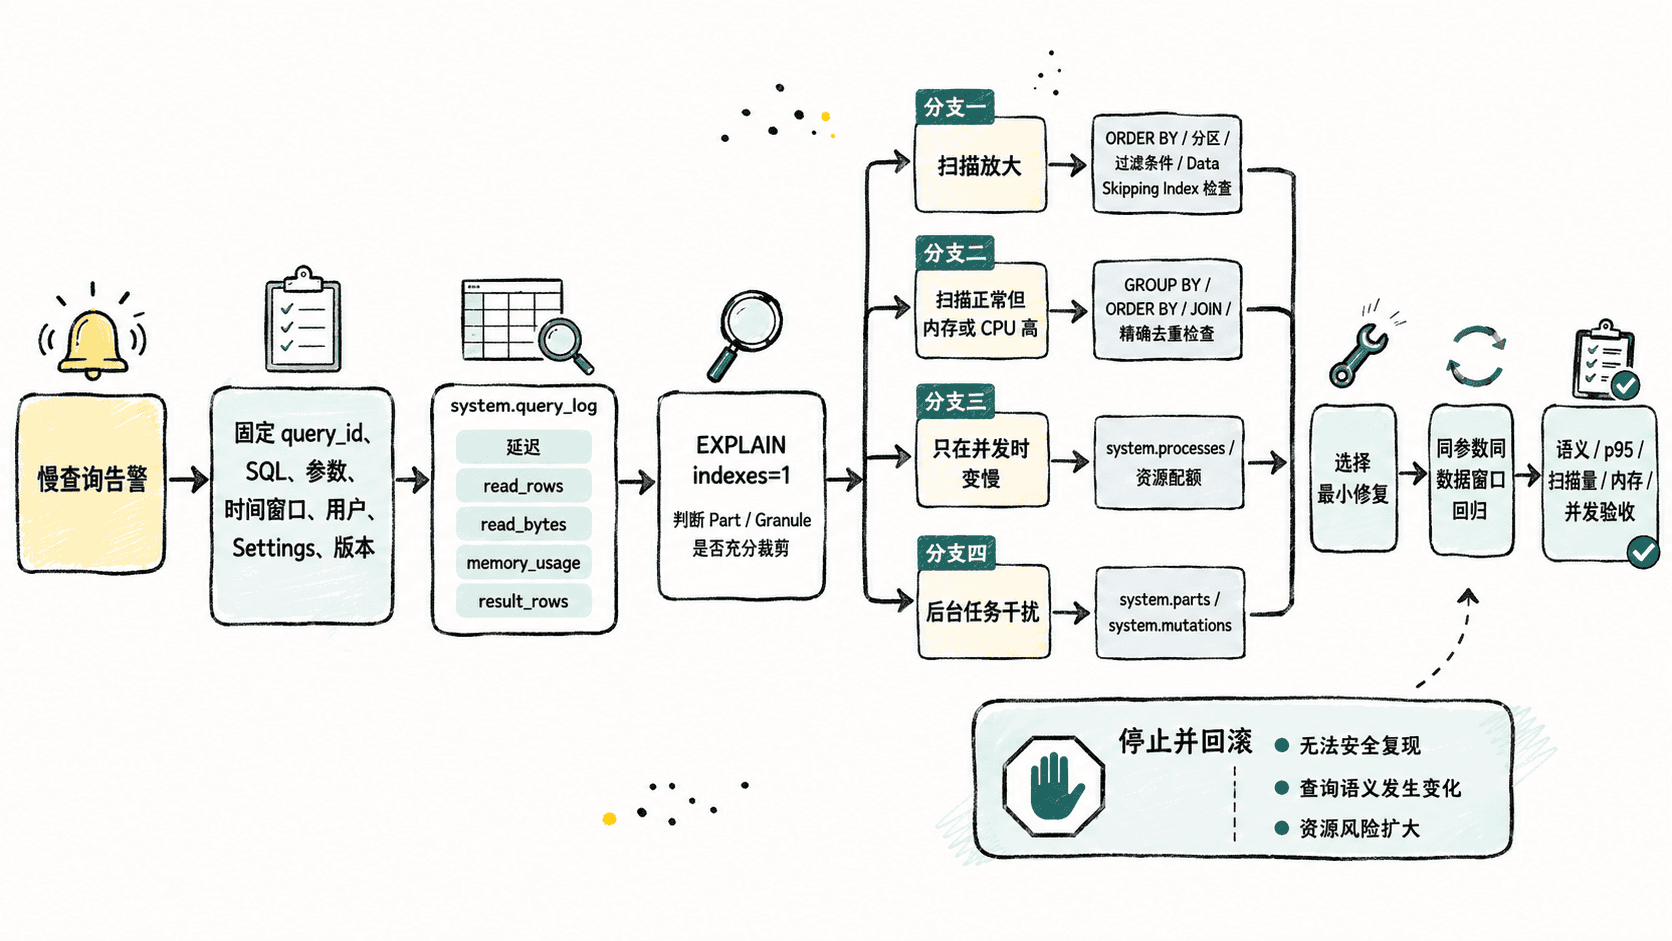
一份可用的慢查询 Runbook 要把“看到慢”转换成固定证据链:先锁定查询与现场,再用 query_log、EXPLAIN 和系统表判断是扫描放大、算子开销、后台任务还是并发竞争,最后按同一条件回归验证。
学习目标
- 按固定顺序收集慢查询证据,避免边猜边改
- 根据扫描、计划、Part、后台任务和并发信息归类根因
- 为修复动作定义停止条件和回归检查
先锁定查询与现场
第一步不是立即改 SQL,而是保存能复现问题的上下文:query_id、完整 SQL、绑定参数、时间窗口、用户、关键 Settings、ClickHouse 版本以及是否处在高并发或批量写入时段。没有这些信息,后续对比很容易把“环境变化”误判成“修复有效”。
先从最近的完成查询中找出最慢样本。
SELECT
    query_id,
    event_time,
    query_duration_ms,
    read_rows,
    read_bytes,
    memory_usage,
    result_rows,
    query
FROM system.query_log
WHERE type = 'QueryFinish'
  AND event_time >= now() - INTERVAL 15 MINUTE
  AND query_kind = 'Select'
ORDER BY query_duration_ms DESC
LIMIT 10;
预期输出
<QUERY_ID>    <TIME>    <DURATION_MS>    <READ_ROWS>    <READ_BYTES>    <MEMORY_USAGE>    <RESULT_ROWS>    <QUERY>
...
如果 system.query_log 中没有刚结束的查询,先确认服务器启用了 query log,并在必要时执行 SYSTEM FLUSH LOGS。不要为了“拿到现场”直接在高峰期反复重跑一条已知会占满 CPU 或内存的查询。
按证据链逐层缩小范围
拿到目标 SQL 后,先检查数据裁剪,再检查并发现场。EXPLAIN indexes = 1 适合判断读取是否利用主键、分区和跳数索引;它不会替你证明真实运行耗时,但能快速暴露明显的全量扫描。
EXPLAIN indexes = 1
SELECT
    customer_id,
    sum(amount)
FROM analytics.orders
WHERE event_date >= today() - 7
  AND region = 'east'
GROUP BY customer_id
ORDER BY sum(amount) DESC
LIMIT 100;
预期输出
<QUERY_PLAN>
Indexes:
  <INDEX_NAME>
    Parts: <VALUE>/<VALUE>
    Granules: <VALUE>/<VALUE>
片段示例依赖已有的 analytics.orders 表,生产排障时应替换为原始慢 SQL。若目标过滤条件长期高频出现,但 Part 或 Granule 几乎没有减少,应优先检查排序键与过滤条件是否匹配,而不是先调大 max_threads。
接着观察慢查询发生时是否存在资源竞争。
SELECT
    query_id,
    elapsed,
    read_rows,
    memory_usage,
    user,
    query
FROM system.processes
ORDER BY elapsed DESC;
预期输出
<QUERY_ID>    <ELAPSED>    <READ_ROWS>    <MEMORY_USAGE>    <USER>    <QUERY>
...
若单独执行很快、并发时明显变慢,同时 system.processes 中出现大量长时间查询,更可能是并发竞争而不是 SQL 结构本身。
用系统表判断结构与后台干扰
如果扫描计划看起来合理,但延迟在写入高峰抖动,继续检查 Part 数量和未完成 Mutation。大量小 Part 会增加读取和后台 Merge 压力;长时间 Mutation 也可能与前台查询竞争 I/O 与 CPU。
SELECT
    database,
    table,
    count() AS active_parts,
    sum(rows) AS rows,
    formatReadableSize(sum(bytes_on_disk)) AS bytes
FROM system.parts
WHERE active
GROUP BY database, table
ORDER BY active_parts DESC
LIMIT 20;
预期输出
<DATABASE>    <TABLE>    <ACTIVE_PARTS>    <ROWS>    <BYTES>
...
再检查未完成 Mutation。
SELECT
    database,
    table,
    mutation_id,
    command,
    create_time,
    parts_to_do,
    is_done
FROM system.mutations
WHERE is_done = 0
ORDER BY create_time;
预期输出
<DATABASE>    <TABLE>    <MUTATION_ID>    <COMMAND>    <TIME>    <PARTS_TO_DO>    0
...
没有未完成任务时,该查询返回 0 行。若 Mutation 长时间堆积,先确认它与慢查询时间窗口是否重合,再决定限流、错峰或处理后台任务;不要仅凭“系统里有 Mutation”就直接认定它是根因。
把根因映射到最小修复
排障时优先选择能直接消除已证明瓶颈的动作。扫描放大对应模型或过滤路径;算子耗时对应聚合、排序、JOIN 和数据类型;并发竞争对应用户配额、并发控制与线程资源;后台干扰对应写入批次、Part 合并和 Mutation 调度。
不要把 OPTIMIZE TABLE ... FINAL 当成通用慢查询修复。它可能非常重,只适合有明确 Part 合并目标并评估资源成本的场景。也不要把提高 max_threads 当成默认答案;单条查询可能变快,但整体并发吞吐反而会下降。
用同一条件做回归检查
修复后必须回到原始 SQL、参数、数据窗口和并发模型。给修复前后请求打不同的 log_comment,再统一比较 p95、扫描量和峰值内存。
SELECT
    log_comment,
    count() AS runs,
    quantileExact(0.95)(query_duration_ms) AS p95_ms,
    avg(read_rows) AS avg_read_rows,
    avg(read_bytes) AS avg_read_bytes,
    max(memory_usage) AS max_memory_usage
FROM system.query_log
WHERE type = 'QueryFinish'
  AND log_comment IN ('before-fix', 'after-fix')
GROUP BY log_comment
ORDER BY log_comment;
预期输出
after-fix     <RUNS>    <P95_MS>    <AVG_READ_ROWS>    <AVG_READ_BYTES>    <MAX_MEMORY_USAGE>
before-fix    <RUNS>    <P95_MS>    <AVG_READ_ROWS>    <AVG_READ_BYTES>    <MAX_MEMORY_USAGE>
只有根因证据、修复动作和回归指标三者能串成一条链时,Runbook 才真正可复用。下一次出现相似慢查询,值班人员应能按相同步骤快速判断“哪里慢、为什么慢、修完是否真的更好”。