
大数据与流处理 / 系统课时
理解并行 Pipeline
理解并行 Pipeline
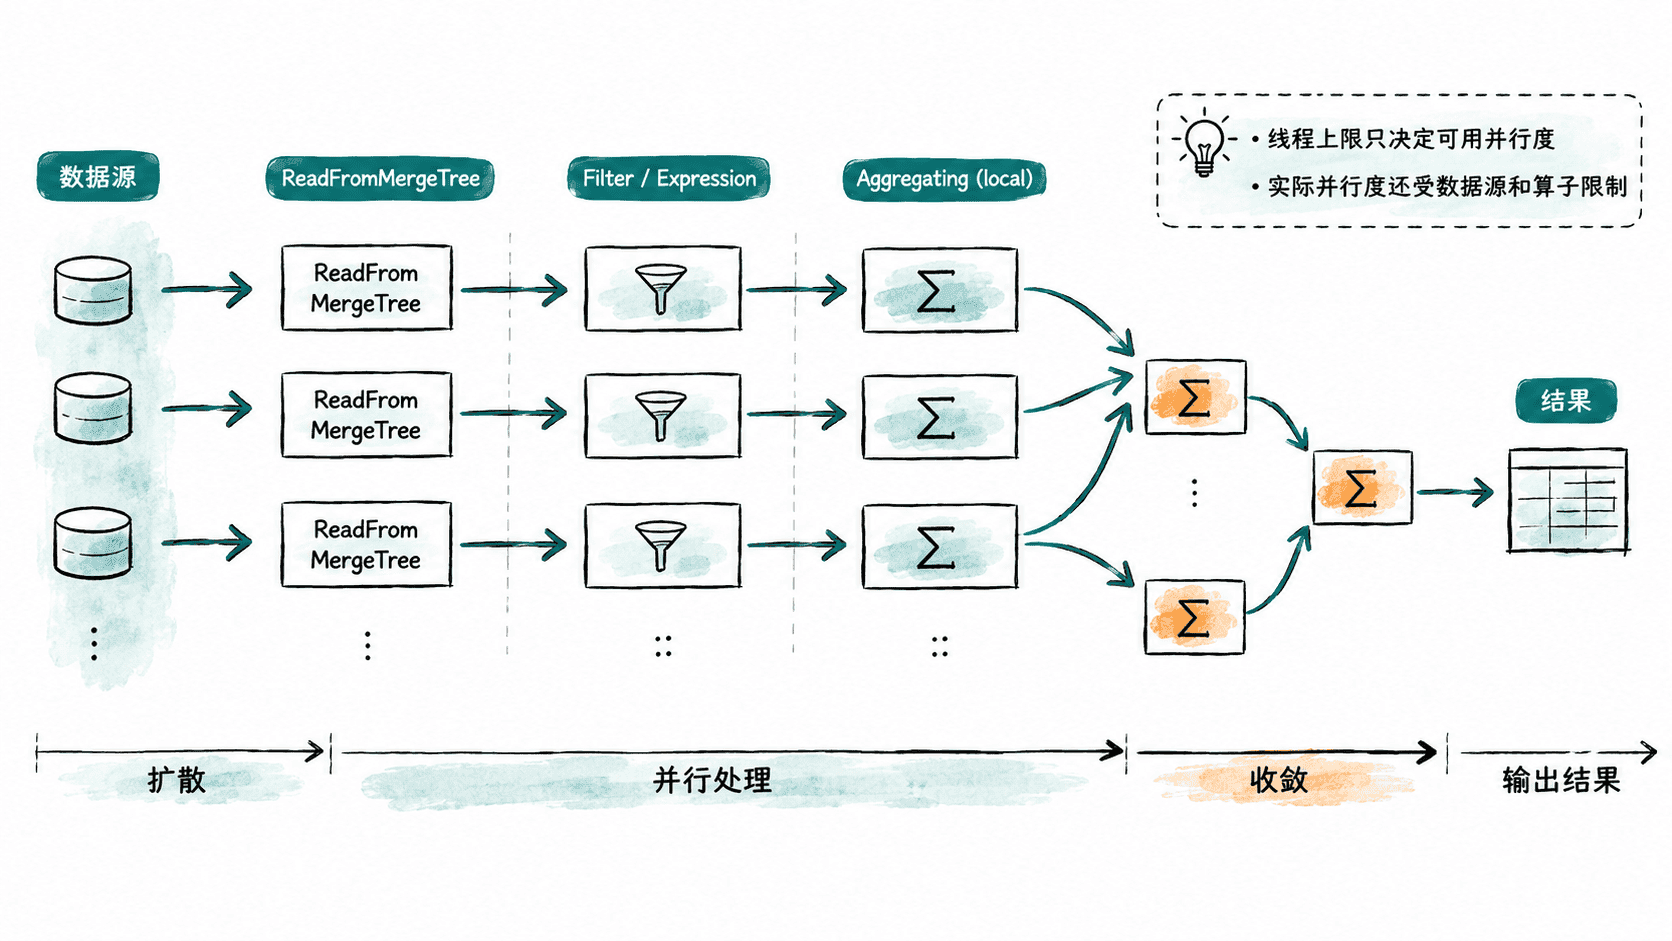
ClickHouse 会把查询拆成一串 Processor,并在可并行的阶段创建多个实例。线程越多并不等于越快:读取源数量、数据量、聚合汇总和最终排序都会限制有效并行度,过高并发还会争抢 CPU、内存和磁盘带宽。
学习目标
- 读懂 Processor Pipeline 中的并行实例与收敛阶段
- 判断并行度不足和并行度过高的典型表现
- 用
EXPLAIN PIPELINE与线程设置做最小验证
Pipeline 把查询拆成可执行 Processor
一个典型聚合查询可能经历并行读取、表达式计算、局部聚合,再在后部做汇总。能否并行取决于上游是否存在足够的数据流,以及某个 Processor 是否天然需要把多路结果合并。
用 EXPLAIN PIPELINE 观察实例数
sql
-- 观察读取、表达式与聚合 Processor 的并行实例数。
EXPLAIN PIPELINE
SELECT
    database,
    count()
FROM system.parts
WHERE active
GROUP BY database;
预期结果:
text
... AggregatingTransform × <VALUE>
... ExpressionTransform × <VALUE>
... ReadFromSystemParts × <VALUE>输出格式会随版本和计划变化,× <VALUE> 可以帮助你观察某个阶段被复制了多少份。若上游读取只有很少的数据源,即使 max_threads 很高,也无法凭空产生更多有效并行任务。
线程限制要结合数据量判断
可以在会话级临时限制线程,再比较同一查询的实际耗时和资源占用。
sql
-- 会话级限制线程,只改变执行资源,不改变查询语义。
SET max_threads = 2;

SELECT
    sum(bytes_on_disk)
FROM system.parts
WHERE active;
预期结果:
text
<VALUE>这个结果值与线程数无关,变化的是执行耗时和资源占用。对小查询,提高线程数可能只增加调度成本;对大扫描或大聚合,适度增加线程通常能缩短墙钟时间,直到 CPU、内存带宽、磁盘或网络成为新瓶颈。
识别并行度失衡
并行度不足常见于读取源太少、数据量太小、前后存在单路处理阶段,或者设置了过低的线程上限。并行度过高则可能表现为单条查询更快但系统整体吞吐下降、上下文切换增加、内存峰值升高,甚至并发查询互相抢资源。
按自己的节奏,确认真正理解。