
大数据与流处理 / 系统课时
验证分区与主键裁剪
验证分区与主键裁剪
查询写了分区键或排序键条件,并不等于 ClickHouse 一定少读了数据。本课用一张可复现实验表,把“Part 是否被排除、Granule 是否被跳过、实际读了多少行”串成一条证据链,避免只凭 SQL 形状判断优化是否生效。
学习目标
- 使用
EXPLAIN indexes = 1判断分区与主键裁剪是否发生 - 正确解读
Parts、Granules与Condition,区分 Part 级和 Granule 级收益 - 用
system.query_log的read_rows、read_bytes验证计划是否转化为真实读取下降
建立可复现的裁剪样本
下面创建 90 万行 MergeTree 数据。月份作为分区键,tenant_id、event_date、user_id 组成排序键;这样既能观察按月排除 Part,也能观察主键稀疏索引缩小 Granule 范围。
DROP TABLE IF EXISTS pruning_demo;

CREATE TABLE pruning_demo
(
    event_date Date,
    tenant_id UInt32,
    user_id UInt64,
    value UInt32
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(event_date)
ORDER BY (tenant_id, event_date, user_id)
SETTINGS index_granularity = 8192;

-- 每个 tenant 在 90 天内都有均匀数据,避免日期与租户意外相关。
INSERT INTO pruning_demo
SELECT
    toDate('2026-01-01') + toIntervalDay(number % 90) AS event_date,
    toUInt32(intDiv(number, 90) % 20) AS tenant_id,
    number AS user_id,
    toUInt32(number % 1000) AS value
FROM numbers(900000);

SELECT
    count() AS rows,
    min(event_date) AS min_date,
    max(event_date) AS max_date,
    uniqExact(tenant_id) AS tenants
FROM pruning_demo;
预期结果
rows    min_date    max_date    tenants
900000  2026-01-01  2026-03-31  20
从 EXPLAIN 看 Part 与 Granule
先看一个只过滤非键列的基线,再看同时带月份范围和排序键前缀的查询。EXPLAIN indexes = 1 不需要完整执行聚合,就能展示 MergeTree 读取阶段应用了哪些索引,以及每一步应用前后还剩多少 Part 和 Granule。
-- 基线:value 不在分区键或排序键中,通常无法靠这两层裁剪。
EXPLAIN indexes = 1
SELECT count()
FROM pruning_demo
WHERE value = 42;

-- 目标:日期限制月份范围,tenant_id 又约束排序键前缀。
EXPLAIN indexes = 1
SELECT count()
FROM pruning_demo
WHERE tenant_id = 7
  AND event_date >= '2026-03-10'
  AND event_date < '2026-03-13';
预期输出
基线查询的关键形态:
Partition
  Condition: true
  Parts: <VALUE>/<VALUE>
PrimaryKey
  Condition: true
  Granules: <VALUE>/<VALUE>

目标查询的关键形态:
Partition
  Condition: <PARTITION_CONDITION>
  Parts: <KEPT_PARTS>/<INPUT_PARTS>
PrimaryKey
  Keys: tenant_id, event_date, user_id
  Condition: <PRIMARY_KEY_CONDITION>
  Granules: <KEPT_GRANULES>/<INPUT_GRANULES>
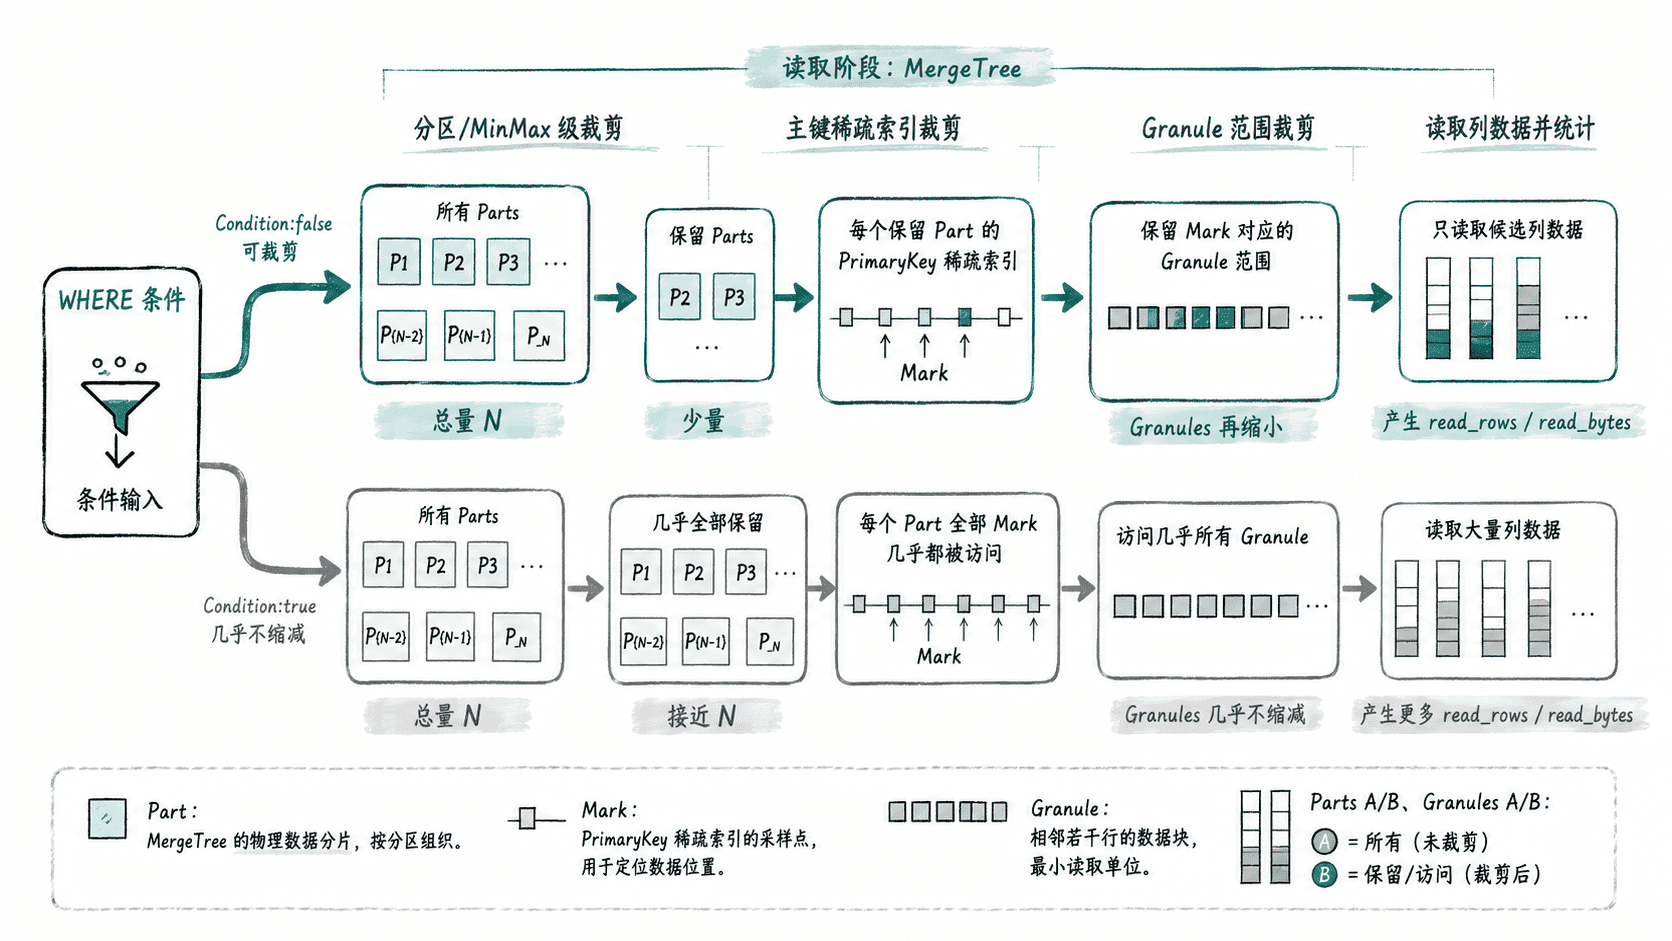
Parts: A/B、Granules: A/B 可以按“应用该层索引后保留 A、应用前有 B”来读。分区条件主要减少 Part;主键稀疏索引主要在保留下来的 Part 内减少 Granule。具体数字会受 ClickHouse 版本、Part 合并状态和索引粒度影响,因此判断重点是比例是否明显收缩,而不是背固定数值。
用查询日志核对真实读取
计划只能说明“预计会读哪些范围”,最终还要看实际扫描。先给两条查询写入不同 log_comment;结果行数可以精确验证查询语义没有被优化过程改变。
-- 非键列过滤:结果少,不代表物理扫描少。
SELECT count() AS matched_rows
FROM pruning_demo
WHERE value = 42
SETTINGS log_comment = 'pruning-baseline';

-- 分区范围 + 排序键前缀:目标是缩小实际扫描范围。
SELECT count() AS matched_rows
FROM pruning_demo
WHERE tenant_id = 7
  AND event_date >= '2026-03-10'
  AND event_date < '2026-03-13'
SETTINGS log_comment = 'pruning-target';
预期输出
pruning-baseline: matched_rows = 900
pruning-target: matched_rows = 1500随后刷新日志并取两个标签最近一次完成记录。argMax 避免重复执行实验后误读更早的记录。
SYSTEM FLUSH LOGS;

SELECT
    log_comment,
    argMax(read_rows, event_time_microseconds) AS read_rows,
    formatReadableSize(argMax(read_bytes, event_time_microseconds)) AS read_size
FROM system.query_log
WHERE type = 'QueryFinish'
  AND log_comment IN ('pruning-baseline', 'pruning-target')
GROUP BY log_comment
ORDER BY log_comment;
预期输出
log_comment       read_rows     read_size
pruning-baseline  <ROWS_A>      <SIZE_A>
pruning-target    <ROWS_B>      <SIZE_B>

其中 <ROWS_B> 应明显小于 <ROWS_A>;实际字节数随版本、压缩和 Part 状态变化。
如果 EXPLAIN 已显示 Parts、Granules 大幅缩小,但 read_rows 没有同步下降,先确认比较的是同一张本地 MergeTree 表、同样的过滤条件和最近一次查询记录;分布式表、投影、查询条件缓存等额外机制会改变读取路径。
用三层证据判断是否有效
验证裁剪时不要只看“用了索引”四个字。第一层看分区相关索引的 Parts 是否下降;第二层看 PrimaryKey 的 Granules 是否下降;第三层看执行后的 read_rows、read_bytes 是否同步减少。三层证据一致,才说明条件真正缩小了物理读取范围。
反过来,PrimaryKey Condition: true 或 Granules: N/N 通常意味着该层没有提供有效排除能力。此时应先检查过滤列与 ORDER BY 的关系,再考虑调整排序键、增加适合的跳数索引或改变查询形态,而不是为了减少扫描盲目增加高基数分区。