
大数据与流处理 / 系统课时
确定事实粒度与维度边界
确定事实粒度与维度边界
这节课解决两个最容易把分析模型做乱的问题:一行数据究竟代表什么,以及哪些属性应该留在事实表、哪些应该作为维度管理。最终你会得到一个能直接落到 ClickHouse 表结构和聚合 SQL 上的粒度判定方法。
学习目标
- 能用业务动作定义事实表的稳定行粒度
- 能区分可聚合事实、维度键与描述性属性
- 能识别重复计量和跨粒度聚合带来的口径错误
从查询口径反推一行代表什么
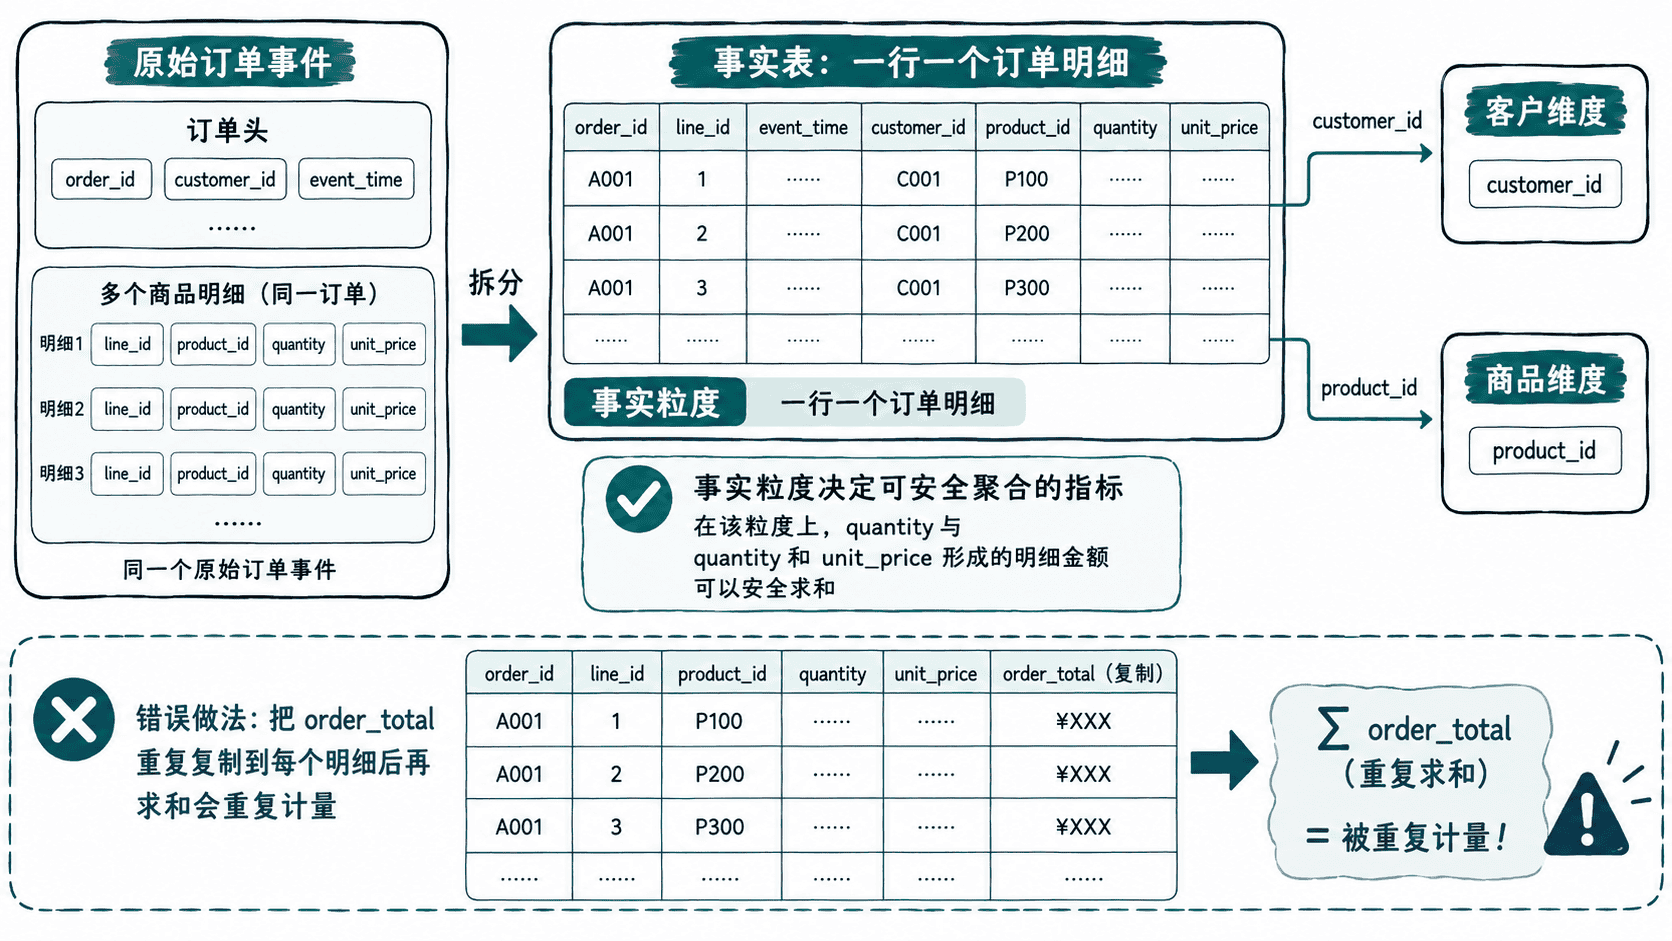
设计事实表时,先写一句不含数据库术语的话:事实表的一行代表什么。例如订单分析既可以是一行一订单,也可以是一行一订单明细。两种都合理,但不能在同一张事实表里混用,否则订单金额、商品数量和商品维度会处在不同粒度。
如果核心问题包含“哪个商品卖了多少件、贡献多少收入”,订单明细通常是更稳定的粒度:一行代表一个订单中的一个商品明细。订单级指标若重复写入每条明细,后续直接 sum 就会重复计算。
把事实和维度分开
事实描述发生了什么,通常包含时间、业务键、维度键以及可度量值;维度描述这些事实发生在什么上下文。对订单明细来说,quantity、unit_price 属于事实,customer_id、product_id 是维度关联键。
边界还取决于语义是否需要“当时值”。例如下单时的渠道、活动来源如果以后会变化,但报表必须还原下单当时的状态,可以直接记录为事实行上的快照属性。相反,“客户当前等级”这类持续变化且要求查询最新值的属性,更适合独立维护,再在查询或预处理阶段关联。
用一张事实表验证粒度
下面建立一张“一行一个订单明细”的演示表。三个明细分别属于两个订单,但聚合时只依赖明细级的数量和单价,因此不会重复计算订单级金额。
DROP TABLE IF EXISTS order_item_fact_demo;

CREATE TABLE order_item_fact_demo
(
    order_id UInt64,
    line_id UInt16,
    event_time DateTime,
    customer_id UInt64,
    product_id UInt64,
    quantity UInt32,
    unit_price Decimal64(2)
)
ENGINE = MergeTree
ORDER BY (toDate(event_time), product_id, order_id, line_id);

INSERT INTO order_item_fact_demo VALUES
(1001, 1, '2026-08-31 10:00:00', 10, 501, 2, 49.90),
(1001, 2, '2026-08-31 10:00:00', 10, 502, 1, 99.00),
(1002, 1, '2026-08-31 11:00:00', 11, 501, 1, 49.90);

SELECT
    toDate(event_time) AS day,
    sum(quantity) AS items,
    sum(quantity * unit_price) AS revenue
FROM order_item_fact_demo
GROUP BY day
ORDER BY day;
预期结果:
day         items  revenue
2026-08-31  4      248.70
这个结果的关键不是数值本身,而是每个可加指标都与“一行一个订单明细”处在同一粒度。若把订单 1001 的总额同时写入两条明细,再对该列直接求和,就会把同一订单重复计量。
在建表前做粒度检查
建表前至少回答三个问题:业务键能否唯一描述一行;所有可加指标是否都属于这个粒度;查询需要的维度是“事件发生时的快照”还是“查询时的当前状态”。只要其中一个答案含糊,就先不要决定列和排序键。
遇到订单、会话、请求、日志这类天然有层级的数据时,优先选择最常被过滤和聚合、同时又能稳定生成业务键的那一级作为事实粒度。粒度一旦稳定,后续是否做宽表、如何选择 ORDER BY、怎样预聚合才有可靠基础。