
大数据与流处理 / 系统课时
使用 Projection 加速查询
使用 Projection 加速查询
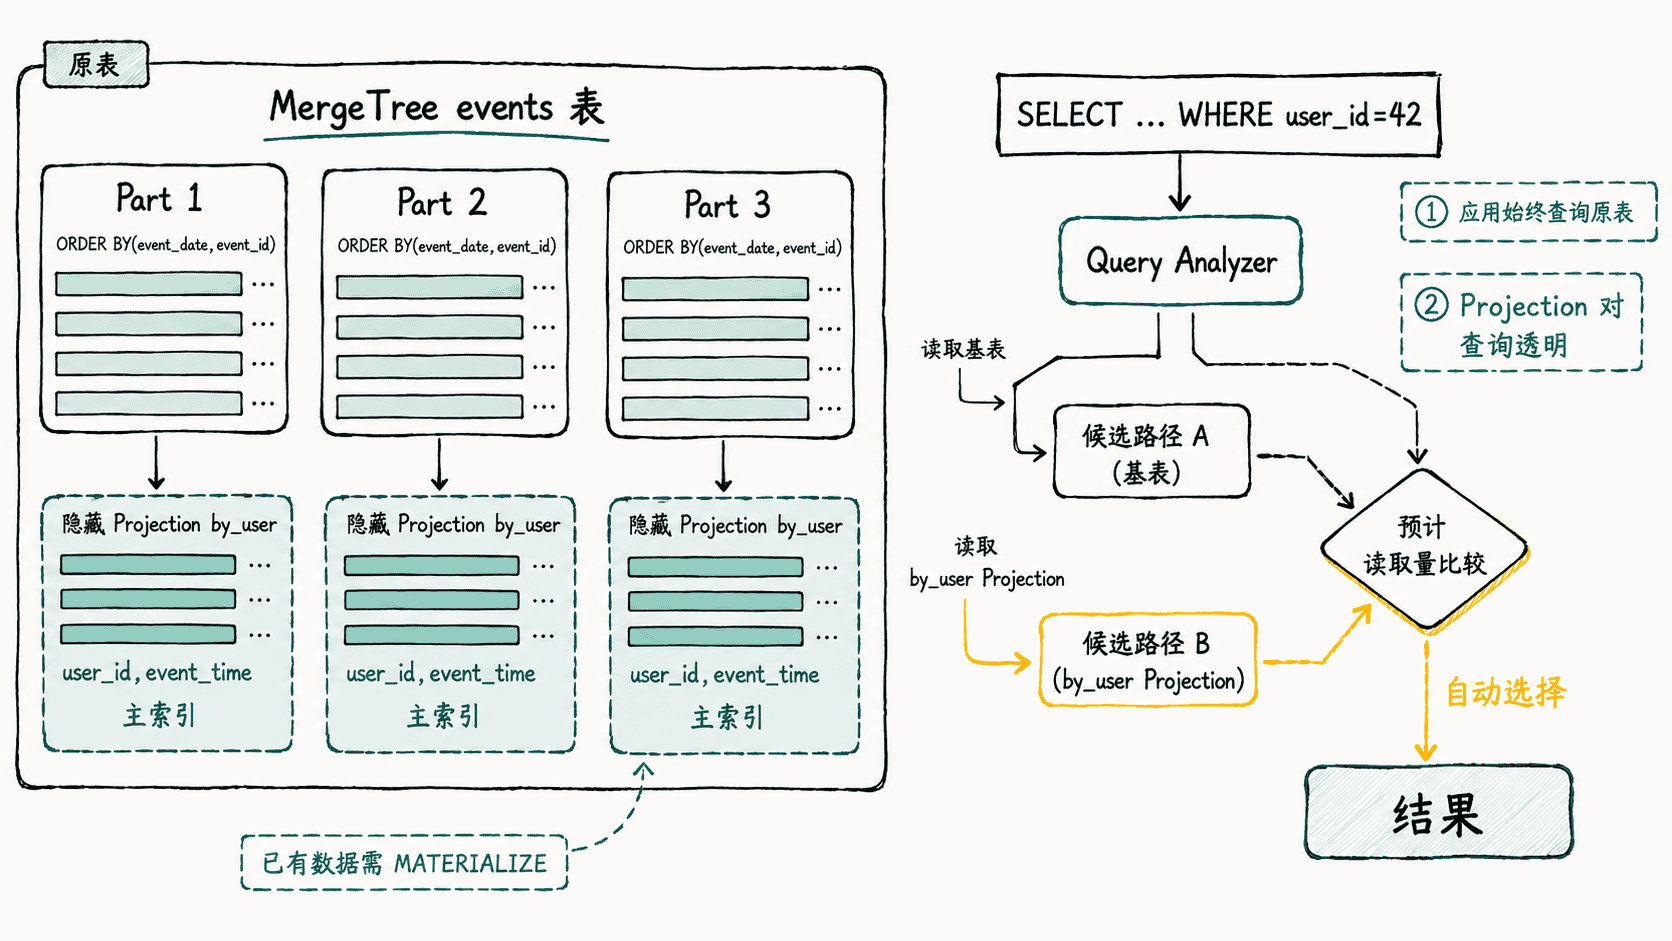
Projection 用来给同一张 MergeTree 表提供额外的数据布局,而应用仍然查询原表。查询分析器会在基表和可用 Projection 之间选择更省读取量的路径。本课通过“按用户查询事件”建立第二种排序,并验证分析器确实采用了它。
学习目标
- 判断什么查询模式适合用 Projection,而不是再建一张显式查询表。
- 为已有数据添加并物化 Projection,理解存量数据与新写入数据的差别。
- 用强制校验和
EXPLAIN验证 Projection 是否真正进入读取计划。
先找出第二种稳定访问模式
一张 MergeTree 表只能有一个主要 ORDER BY 布局。假设事件表按日期和事件 ID 排序,按时间范围扫描很合适,但业务又频繁按 user_id 查某个用户的事件,这个条件无法充分利用原排序键。Projection 可以在每个数据 Part 内保存一份隐藏的替代布局,例如按 (user_id, event_time) 排序。
查询 SQL 不需要改成读取另一个表。分析器会比较可行读取路径并自动选择 Projection;这也是它和“显式维护一张查询专用表”的关键区别。Projection 定义更适合单表重排或预聚合,不适合在定义里承载 JOIN,也不能用 WHERE 把它做成任意过滤后的子集。
为已有数据增加 Projection
下面先创建一张按日期排序的事件表并写入数据,再添加按用户排序的 Projection。因为 Projection 是在数据已经存在之后添加的,所以必须执行 MATERIALIZE PROJECTION 才能覆盖存量 Part。
DROP TABLE IF EXISTS events_projection_demo;

CREATE TABLE events_projection_demo
(
    event_id UInt64,
    event_date Date,
    event_time DateTime,
    user_id UInt64,
    event_type LowCardinality(String)
)
ENGINE = MergeTree
ORDER BY (event_date, event_id);

INSERT INTO events_projection_demo VALUES
    (1, '2026-08-31', '2026-08-31 09:00:00', 7,  'view'),
    (2, '2026-08-31', '2026-08-31 09:01:00', 42, 'view'),
    (3, '2026-08-31', '2026-08-31 09:02:00', 9,  'click'),
    (4, '2026-08-31', '2026-08-31 09:03:00', 42, 'purchase'),
    (5, '2026-08-31', '2026-08-31 09:04:00', 42, 'view'),
    (6, '2026-08-31', '2026-08-31 09:05:00', 7,  'click');

ALTER TABLE events_projection_demo
ADD PROJECTION by_user
(
    SELECT *
    ORDER BY (user_id, event_time)
);

ALTER TABLE events_projection_demo
MATERIALIZE PROJECTION by_user
SETTINGS mutations_sync = 1;

SELECT
    event_id,
    user_id,
    event_type
FROM events_projection_demo
WHERE user_id = 42
ORDER BY event_time
SETTINGS force_optimize_projection = 1;
预期输出:
2   42   view
4   42   purchase
5   42   view
force_optimize_projection = 1 很适合做验证:如果当前查询找不到可用 Projection,ClickHouse 会直接报错,而不是悄悄退回基表。正常业务查询通常不需要打开它,保留默认的自动选择即可。
用 EXPLAIN 看见分析器的选择
强制校验能证明“有用上”,EXPLAIN projections = 1 则能看到分析器如何分析 Projection。输出的完整树会随 ClickHouse 版本和数据 Part 布局变化,因此只核对稳定的关键信号。
EXPLAIN projections = 1
SELECT
    event_id,
    user_id,
    event_type
FROM events_projection_demo
WHERE user_id = 42
ORDER BY event_time
SETTINGS force_optimize_projection = 1;
预期输出中的关键片段:
Projections:
  Name: by_user
如果结果里完全没有 by_user,先确认存量数据已经执行 MATERIALIZE PROJECTION,再检查查询条件与 Projection 的排序或聚合表达式是否匹配。Projection 的存在本身不等于一定会被选中,分析器仍会选择预计读取成本更低的合法路径。
理解加速来自哪里
原表按 (event_date, event_id) 排序时,user_id = 42 对主索引帮助很小;by_user 把同一用户的数据聚到相邻范围后,主索引可以直接缩小读取区间。真正的收益不是“多了一个名字叫索引的对象”,而是为常用查询提供了更合适的物理顺序或预聚合结果。
代价同样存在:完整 Projection 会增加存储占用,也会给写入和后台维护增加工作。添加 Projection 前应先从真实慢查询中确认第二种稳定访问模式,并比较 read_rows、延迟和磁盘占用,而不是为每个可能的过滤列都创建一份。
知道什么时候换别的结构
如果你需要跨表 JOIN、独立 TTL、复杂过滤后的持久结果,物化视图通常比 Projection 更灵活;如果只需要在同一张表上增加另一种排序或透明预聚合,Projection 更省应用改造。对已经存在的大表,MATERIALIZE PROJECTION 本身会重写并计算存量数据,应当按变更窗口评估资源消耗,而不是把它当成零成本 DDL。