
大数据与流处理 / 系统课时
理解 ClickHouse 的查询性能链路
理解 ClickHouse 的查询性能链路
ClickHouse 查询快慢不是由某一个参数决定,而是由“能否少读数据、读哪些列、算多少内容、怎样并行执行”共同决定。本节把一次查询拆成可观察的性能链路,帮助你看到延迟究竟消耗在裁剪、读取还是计算阶段。
学习目标
- 说清 SQL 从解析到结果返回的主要性能阶段
- 理解分区、主键与跳数索引如何减少实际读取
- 用系统表建立“扫描量与延迟”之间的基本对应关系
从 SQL 到结果的性能链路
一条查询进入 ClickHouse 后,会先经过解析与优化,再根据表的分区、排序键和索引信息缩小候选数据范围。真正读取时只取查询需要的列,随后进入过滤、聚合、排序等算子,并由 Processor Pipeline 并行执行,最后汇总结果。
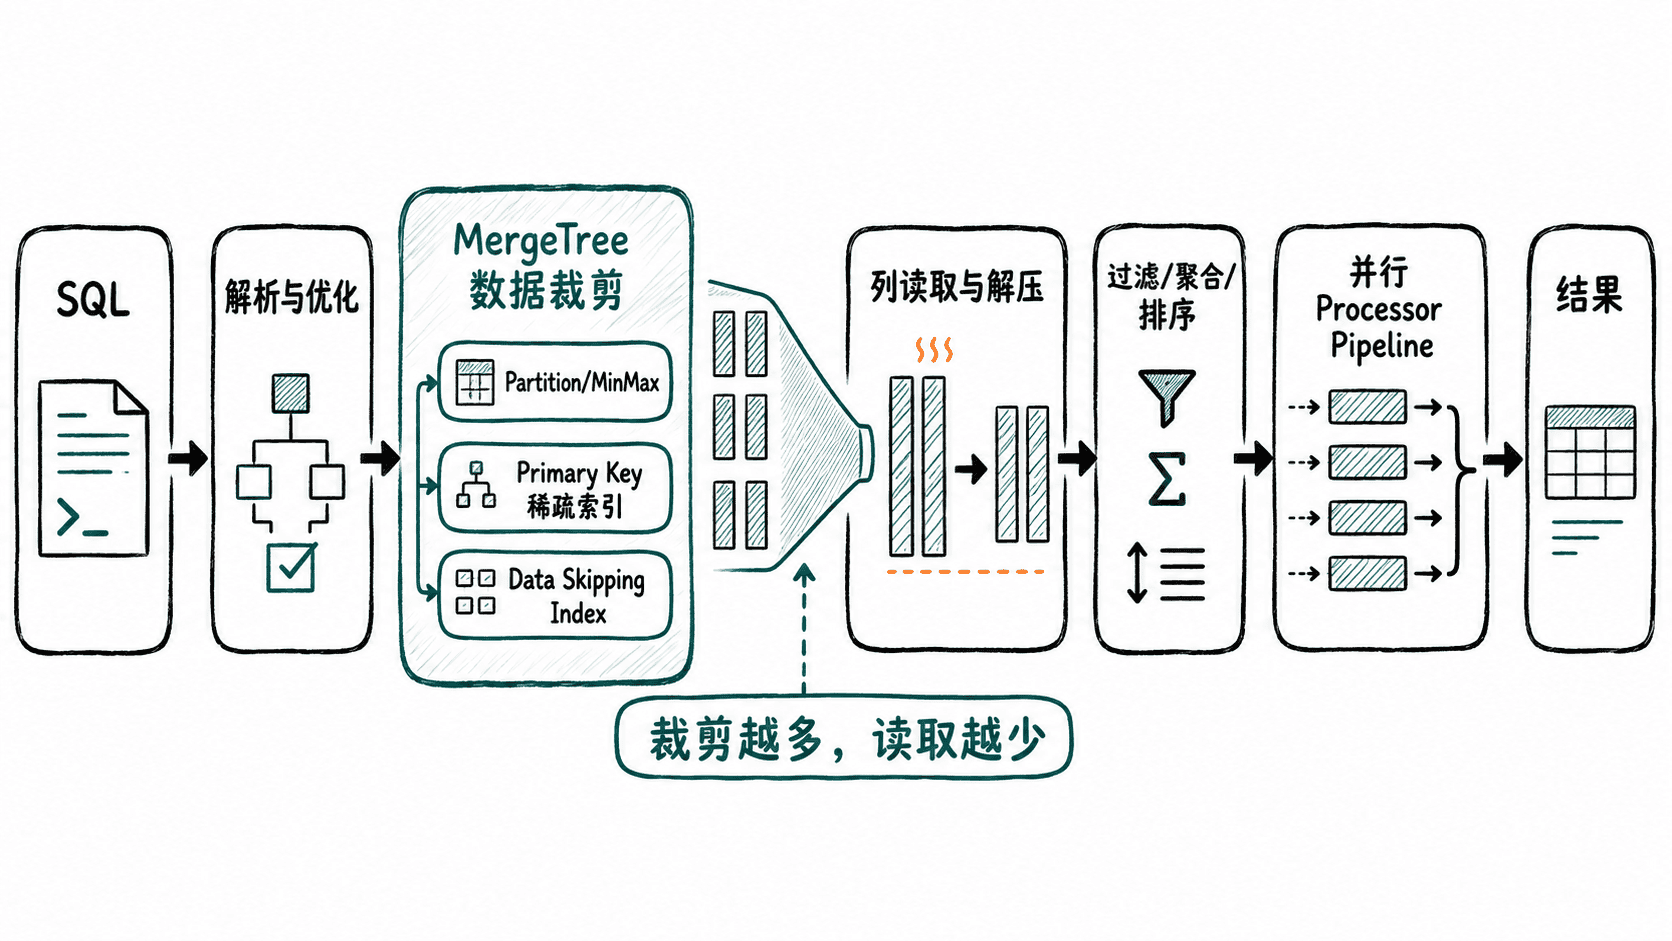
性能优化通常优先看前半段,因为少读一个 Part、一个 Granule 或一组列,往往比单纯增加线程更直接。只有扫描量已经合理后,再检查聚合、排序和并发配置是否成为主要瓶颈。
用查询日志观察扫描代价
system.query_log 可以把一次已完成查询的耗时、读取行数和读取字节数放在一起比较。下面只查看当前用户最近完成的查询,避免把内部查询混进分析样本。
sql
-- 先刷新异步系统日志,确保最近完成的查询可见。
-- 只比较当前用户的初始完成查询,避免内部子查询干扰样本。
SYSTEM FLUSH LOGS;

SELECT
    query_id,
    query_duration_ms,
    read_rows,
    read_bytes,
    memory_usage,
    query
FROM system.query_log
WHERE type = 'QueryFinish'
  AND is_initial_query = 1
  AND user = currentUser()
ORDER BY event_time DESC
LIMIT 5;
预期结果:
text
┌─query_id─┬─query_duration_ms─┬─read_rows─┬─read_bytes─┬─memory_usage─┬─query─┐
│ <ID>     │ <VALUE>           │ <VALUE>   │ <VALUE>    │ <VALUE>      │ ...   │
└──────────┴───────────────────┴───────────┴────────────┴──────────────┴───────┘
实际数值取决于工作负载。重点不是某个固定阈值,而是比较同一业务查询在改动前后的 read_rows、read_bytes 与 query_duration_ms 是否同时改善。
用扫描量判断优化方向
如果延迟高且扫描量也高,先检查分区裁剪、排序键、主键前缀和过滤条件;如果扫描量已经很小但延迟仍高,再看复杂聚合、排序、JOIN、单线程阶段或远程读取。如果读取字节明显大于预期,还要确认是否选择了过多宽列,或没有让高选择性过滤尽早发生。
建立可复用的性能判断顺序
面对慢查询,可以按“是否裁剪充分 → 是否少读列 → 是否尽早过滤 → 是否存在高成本算子 → 并行度是否合适”的顺序检查。这个顺序能把问题从模糊的“ClickHouse 变慢了”缩小成可以通过计划、系统表和配置验证的具体阶段。
按自己的节奏,确认真正理解。