
大数据与流处理 / 系统课时
理解 MergeTree 的数据组织
理解 MergeTree 的数据组织
MergeTree 的查询性能取决于数据如何落成 Part、如何按排序键切成 Granule,以及 Mark 与稀疏主键索引怎样帮助跳过无关范围。本节把这些结构连起来,建立“查询为什么只读一部分数据”的直觉。
学习目标
- 区分 Part、Granule、Mark 与主键索引条目的职责
- 理解排序键如何决定可裁剪的数据范围
- 用系统表观察 Part 数量和数据规模
Part 是不可变的数据片段
每次写入会形成一个或多个不可变 Part,后台 Merge 再把较小 Part 合并成更大的 Part。查询不会把整张逻辑表当成一个连续文件读取,而是在分区与索引判断后选择需要访问的 Part,再在 Part 内继续缩小范围。
-- 只统计当前数据库中目标表的 active Part。
-- 按分区和 Part 名排序,便于观察碎片是否集中。
SELECT
    partition,
    name,
    rows,
    bytes_on_disk,
    active
FROM system.parts
WHERE database = currentDatabase()
  AND table = '<TABLE>'
  AND active
ORDER BY partition, name
LIMIT 20;
预期结果:
┌─partition─┬─name──────┬─rows───┬─bytes_on_disk─┬─active─┐
│ <VALUE>   │ <VALUE>   │ <VALUE>│ <VALUE>       │ 1      │
└───────────┴───────────┴────────┴───────────────┴────────┘
把 <TABLE> 替换成实际 MergeTree 表名。若同一分区长期堆积大量很小的 active Part,通常意味着写入过碎或后台合并跟不上。
Granule、Mark 与稀疏索引怎样配合
Part 内部的数据按 ORDER BY 排序,并被划分为多个 Granule。ClickHouse 不为每一行建立 B-Tree 索引,而是在 Granule 边界保存稀疏的主键索引条目,同时通过列文件中的 Mark 记录可定位的读取位置。
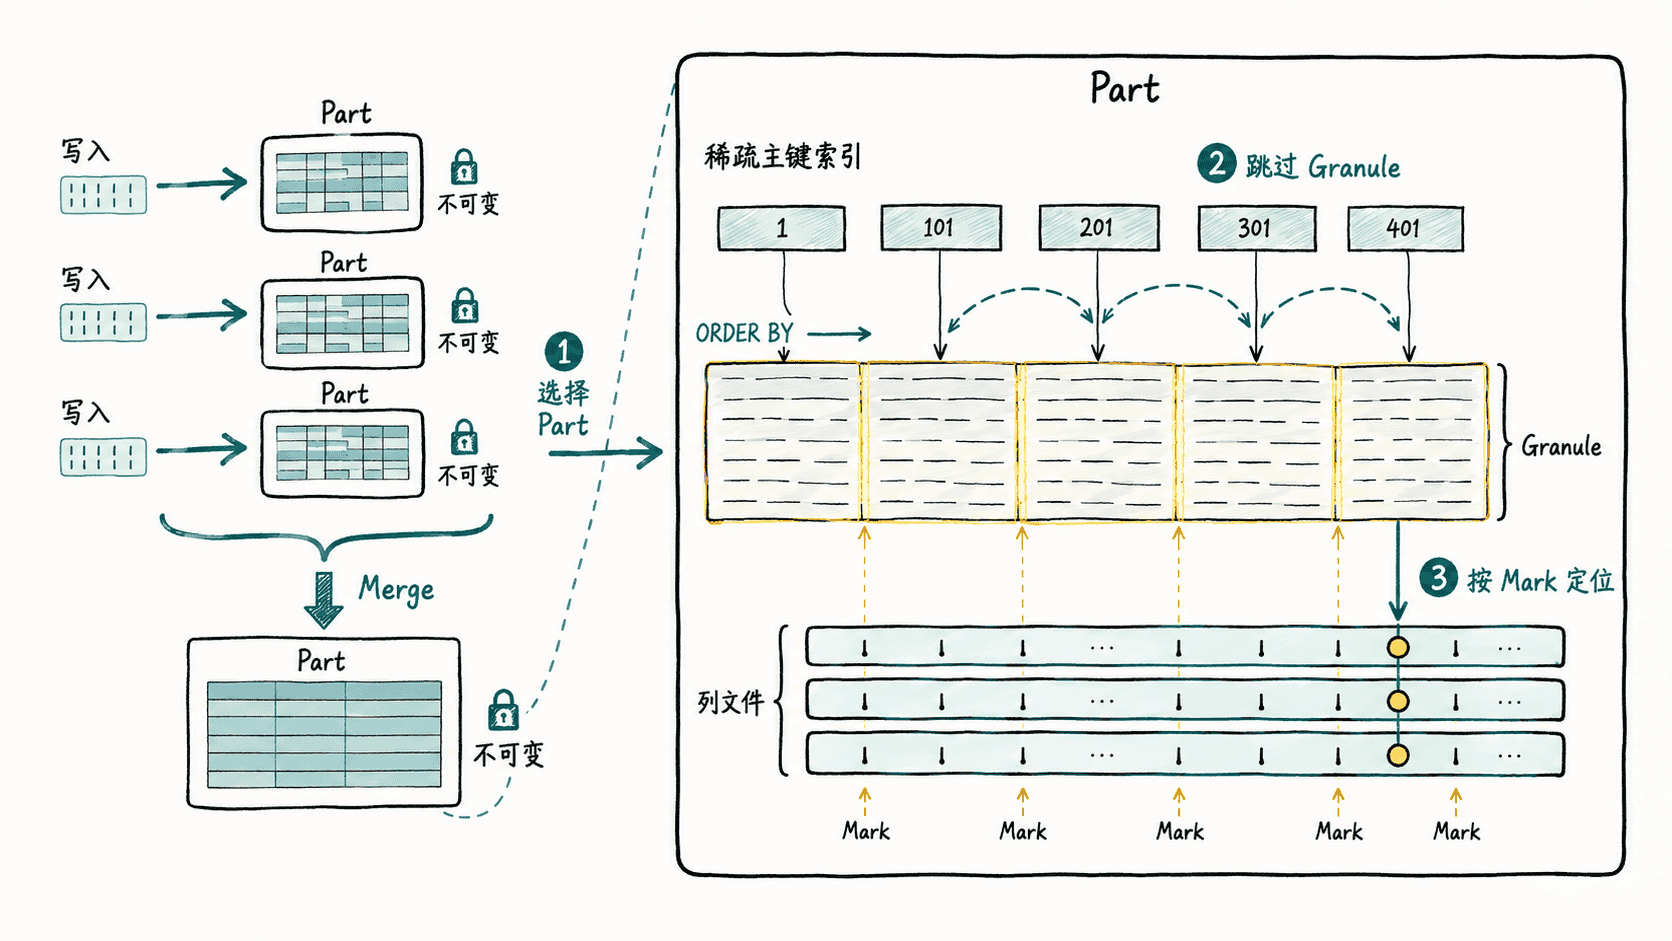
因此,主键索引更像“每隔一段记录一个导航点”,而不是“精确定位到某一行”。它特别擅长排除大段不可能命中的连续范围。
排序键决定索引是否有用
如果排序键是 (service, event_time),查询条件包含 service = 'api' 时,索引能先收窄到 service 连续区间;在此基础上再限定 event_time,可以进一步缩小区间。相反,只按排序键后部列过滤,前部列没有约束时,通常不能获得同样强的连续裁剪效果。
把结构映射到查询成本
Part 太多会增加元数据与调度开销;Granule 被裁剪得越多,读取越少;排序键与查询过滤越匹配,主键索引越容易形成连续范围。理解这四个对象后,很多“为什么明明有主键还扫描很多行”的问题,就能落到具体的数据组织层解释,而不是只看 SQL 表面。