
大数据与流处理 / 系统课时
诊断 Part 与 Merge 问题
诊断 Part 与 Merge 问题
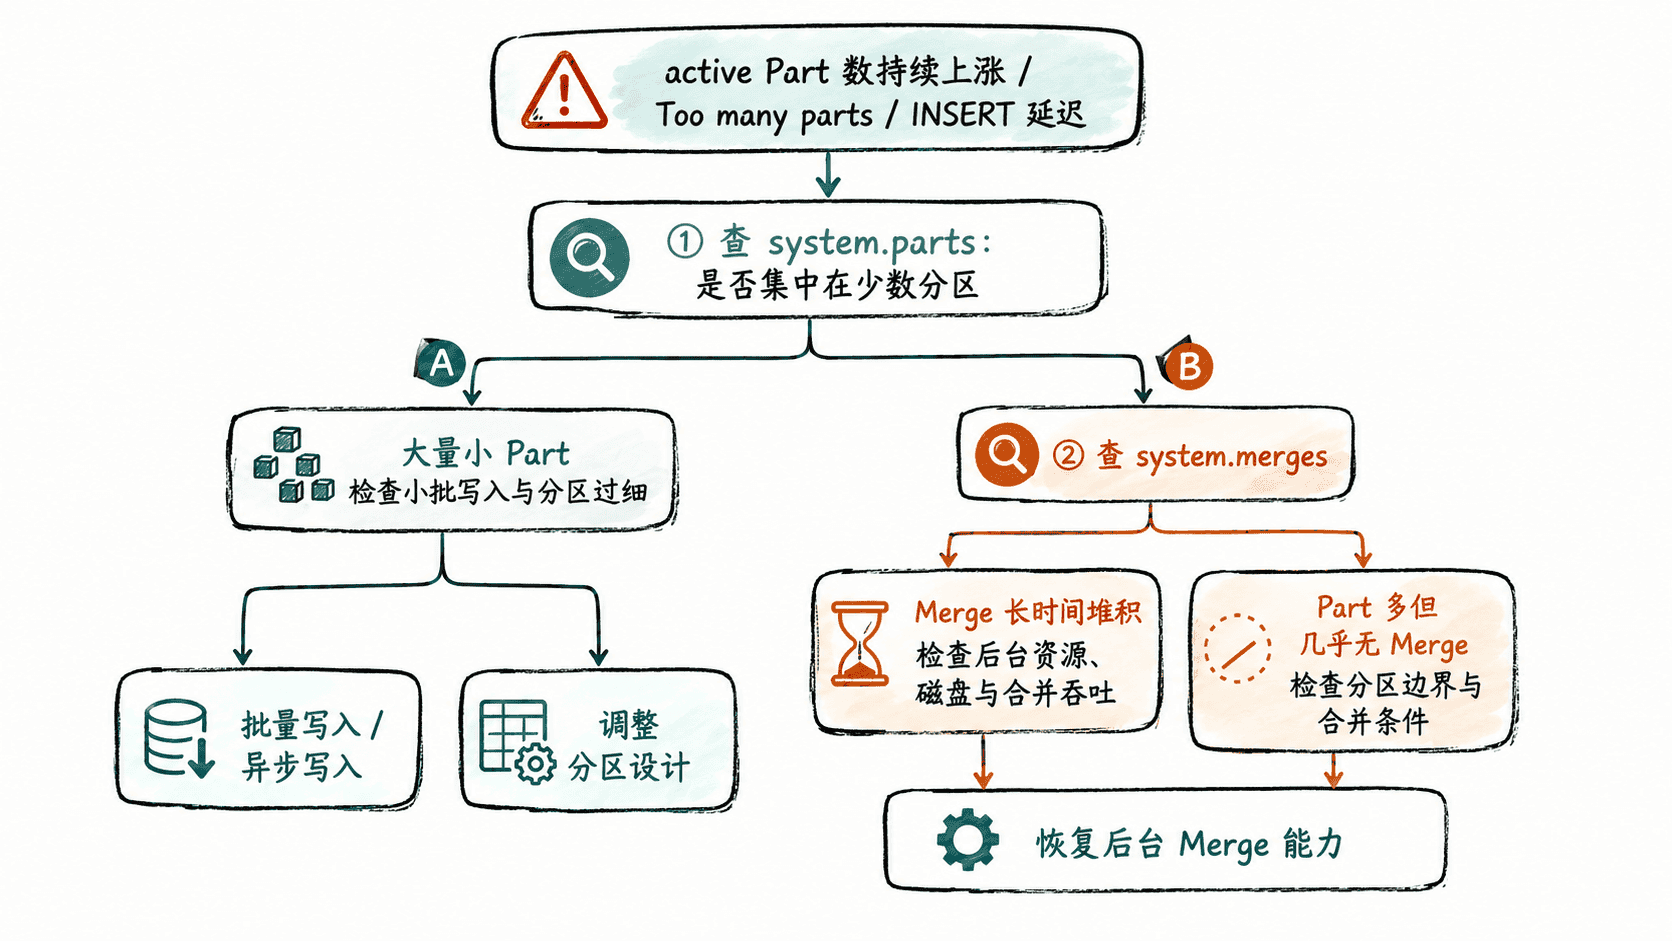
当 INSERT 延迟升高、出现 Too many parts,或同一分区的 active Part 数持续上涨时,问题通常落在“小批写入过多、后台 Merge 积压、分区过细或资源不足”之一。本节用 system.parts 与 system.merges 建立定位顺序。
学习目标
- 用
system.parts找出 Part 异常集中的表和分区 - 用
system.merges判断后台是否正在合并或出现积压 - 根据证据区分写入碎片、分区设计与资源瓶颈
先确认 Part 是否真的异常增长
sql
-- 按表和分区统计 active Part,优先暴露碎片最严重的位置。
-- 同时保留行数与磁盘大小,区分“小数据多 Part”和“大数据多 Part”。
SELECT
    database,
    table,
    partition,
    count() AS active_parts,
    sum(rows) AS rows,
    formatReadableSize(sum(bytes_on_disk)) AS disk_size
FROM system.parts
WHERE active
GROUP BY database, table, partition
ORDER BY active_parts DESC
LIMIT 20;
预期结果:
text
<DB> <TABLE> <VALUE> <VALUE> <VALUE> <VALUE>优先关注“数据量不大但 active Part 很多”的分区,因为这往往说明单次写入太小或分区键产生了过多碎片。
再看后台 Merge 是否正在消化
sql
-- 当前正在执行的 Merge 能说明后台是否在持续消化 Part。
SELECT
    database,
    table,
    elapsed,
    progress,
    num_parts,
    formatReadableSize(total_size_bytes_compressed) AS merge_size
FROM system.merges
ORDER BY elapsed DESC;
预期结果:
text
<DB> <TABLE> <VALUE> <VALUE> <VALUE> <VALUE>如果 Part 很多且 system.merges 持续有大量长时间任务,说明后台正在努力追赶;如果 Part 很多但几乎没有 Merge,则要继续检查分区边界、Merge 选择条件、后台线程池和磁盘空间等限制。
把现象对应到根因
如果新 Part 产生速度长期高于 Merge 消化速度,最常见的修复是增大批量、使用异步写入或在上游聚合小请求。如果 Part 被分散到大量高基数分区,即使单次批量不小,Merge 也只能在同一分区内进行,此时需要重新审视分区键。
如果 Merge 已经持续运行但进度很慢,则应检查磁盘吞吐、后台线程资源和同时发生的 mutation、TTL、复制等后台任务是否竞争资源。
修复后用趋势而不是瞬时值验收
一次 OPTIMIZE 把 Part 数降下来不代表问题解决。真正的验收标准是恢复正常写入后,active Part 的产生与合并达到稳定平衡,system.merges 不再长期积压,INSERT 延迟和查询读取 Part 数也回到可接受范围。
按自己的节奏,确认真正理解。