
大数据与流处理 / 系统课时
设计实时日志分析模型
设计实时日志分析模型
实时日志模型既要承受持续高吞吐写入,也要让“按服务与时间检索、按级别聚合、按 trace 定位”这类查询少扫描。本节从事实粒度、类型、分区和排序键出发,给出一个可直接验证的最小模型。
学习目标
- 为日志事件确定一行一事件的事实粒度
- 组合分区键、排序键与高频过滤字段
- 用典型检索和聚合查询验收模型
把一条日志事件定义为一行
一行代表一个发生在某时刻的日志事件,稳定且高频使用的字段直接建列:时间、服务、级别、trace ID、消息。可变属性放入 Map,避免为了低频键不断改表,但不能让所有高频过滤都藏在动态结构里。
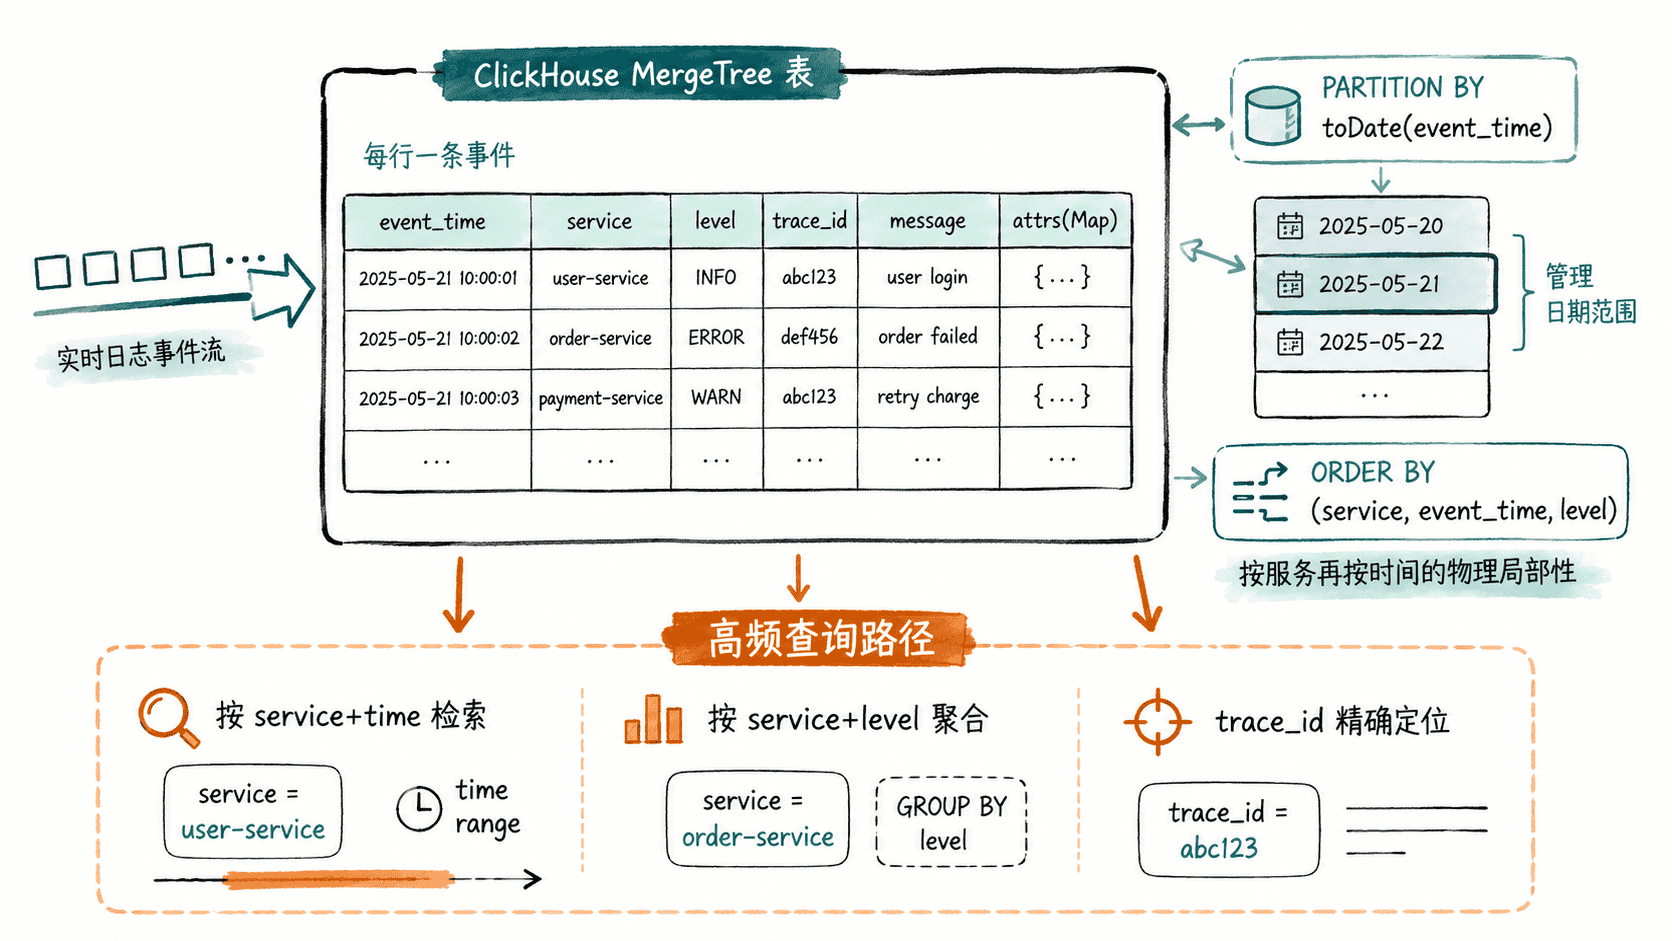
建立最小可用表结构
sql
-- 一行代表一条日志事件;稳定字段单独建列,动态属性放 Map。
-- 日期分区负责生命周期管理,排序键服务主要检索路径。
CREATE TABLE IF NOT EXISTS realtime_logs
(
    event_time DateTime64(3),
    service LowCardinality(String),
    level LowCardinality(String),
    trace_id String,
    message String,
    attrs Map(String, String)
)
ENGINE = MergeTree
PARTITION BY toDate(event_time)
ORDER BY (service, event_time, level);

INSERT INTO realtime_logs VALUES
('2026-09-02 10:00:00.123', 'checkout', 'ERROR', 't-1', 'payment failed', {'region':'us-west'}),
('2026-09-02 10:00:01.456', 'checkout', 'INFO', 't-2', 'retry started', {'region':'us-west'}),
('2026-09-02 10:00:02.000', 'catalog', 'INFO', 't-3', 'item loaded', {'region':'us-east'});
预期结果:
text
插入 3 行;表按日期分区,并在每个 Part 内按 service、event_time、level 排序。验证典型检索与聚合
sql
-- 用 service + 时间窗口命中排序键前缀,再按 level 聚合。
SELECT
    level,
    count() AS events
FROM realtime_logs
WHERE service = 'checkout'
  AND event_time >= '2026-09-02 10:00:00'
  AND event_time < '2026-09-02 10:01:00'
GROUP BY level
ORDER BY level;
预期结果:
text
ERROR    1
INFO     1
这个查询同时命中排序键前缀 service 与时间范围,适合作为主要检索路径的基线样本。
处理 trace 精确查询的边界
trace_id 如果基数很高且只占少量查询,不一定适合直接放在排序键前部,否则会破坏按服务与时间的局部性。可以先测普通扫描成本,再根据真实频率考虑数据跳过索引、投影或其他辅助结构。
模型是否合格要同时看写入吞吐、active Part 趋势、典型查询 read_rows/read_bytes 和延迟分布。只要主要业务查询少读、写入稳定、低频查询成本可接受,这个布局就是更均衡的生产起点。
按自己的节奏,确认真正理解。