
大数据与流处理 / 系统课时
排查查询性能回归
排查查询性能回归
查询从几十毫秒变成几秒时,最危险的做法是直接改 SQL 或加索引。本课建立一条可重复的回归排查链路:先固定基线与当前现场,再比较扫描量、裁剪效果、表结构和设置,最后从最早出现差异的位置确定根因。
学习目标
- 建立基线与当前现场之间可比较的查询证据
- 用
system.query_log与EXPLAIN找到首个性能分叉点 - 根据扫描、数据组织和执行资源差异选择最小修复并完成验证
固定真正可比的两个现场
性能回归首先要证明比较的是同一件事。至少固定 SQL 语义、绑定参数、时间范围、目标表、查询节点和关键设置。对于分布式查询,还应确保基线与当前样本来自相同协调方式,否则网络和副本差异会混入结果。
基线应选择业务确认正常的时间窗口,而不是拿一次偶然很快的执行做参照。当前窗口则尽量避开正在进行的 DDL、批量导入或集群扩缩容;如果这些变化本身就是怀疑对象,应明确记录,而不是让它们成为隐藏变量。
先用 normalized_query_hash 聚合同一类查询,比较耗时与扫描规模。下面的 <ID> 和 <TIME_...> 都要替换为现场真实值,实际指标会随数据量变化。
WITH
    toDateTime('<TIME_BASELINE_START>') AS baseline_start,
    toDateTime('<TIME_BASELINE_END>') AS baseline_end,
    toDateTime('<TIME_CURRENT_START>') AS current_start,
    toDateTime('<TIME_CURRENT_END>') AS current_end
SELECT
    if(event_time < current_start, 'baseline', 'current') AS phase,
    count() AS executions,
    round(quantile(0.50)(query_duration_ms), 1) AS p50_ms,
    round(quantile(0.95)(query_duration_ms), 1) AS p95_ms,
    round(avg(read_rows), 0) AS avg_read_rows,
    round(avg(read_bytes), 0) AS avg_read_bytes,
    max(memory_usage) AS max_memory
FROM system.query_log
WHERE type = 'QueryFinish'
  AND is_initial_query = 1
  AND normalized_query_hash = <ID>
  AND (
      (event_time >= baseline_start AND event_time < baseline_end)
      OR
      (event_time >= current_start AND event_time < current_end)
  )
GROUP BY phase
ORDER BY phase;
预期输出
phase    | executions | p50_ms  | p95_ms  | avg_read_rows | avg_read_bytes | max_memory
baseline | <VALUE>    | <VALUE> | <VALUE> | <VALUE>       | <VALUE>        | <VALUE>
current  | <VALUE>    | <VALUE> | <VALUE> | <VALUE>       | <VALUE>        | <VALUE>
如果 p95_ms 上升的同时 read_rows、read_bytes 也明显增加,优先调查数据裁剪与数据分布;如果扫描规模基本不变但耗时或内存显著升高,则应把注意力转向执行设置、并发、CPU、内存或磁盘压力。
对齐计划、数据和表结构证据
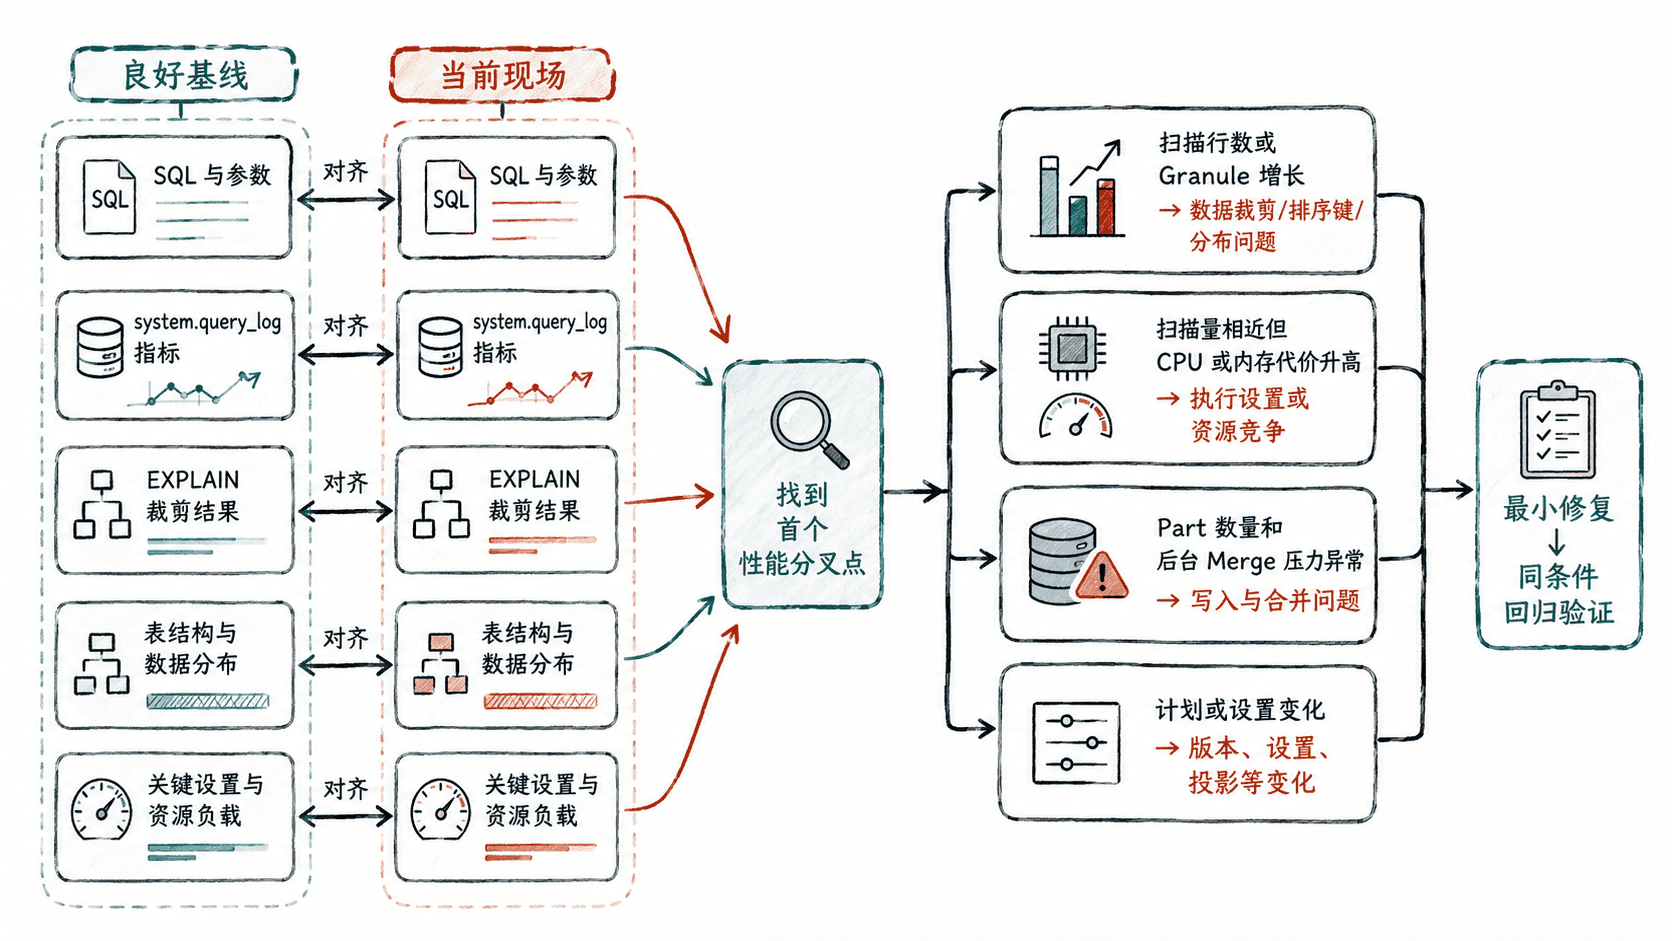
一次可靠的回归分析至少同时对齐四组证据:SQL 与参数决定要做什么,EXPLAIN 描述如何裁剪和执行,表结构决定数据如何组织,现场设置与数据分布决定同一计划实际要处理多少工作量。
- 查询输入:SQL、参数、时间范围以及是否发生函数或谓词改写。
- 裁剪路径:读取了多少 Part、Granule,排序键和跳数索引是否仍能排除数据。
- 数据组织:
PARTITION BY、ORDER BY、投影及索引是否改变,数据是否出现新的热点或倾斜。 - 执行环境:版本、关键查询设置、并发量以及节点资源是否与基线一致。
对怀疑的查询进一步运行索引分析。以下模板中的数据库、表名和时间必须先替换为现场值。
EXPLAIN indexes = 1
SELECT level, count()
FROM <DATABASE>.<TABLE>
WHERE service = 'checkout'
  AND event_time >= toDateTime64('<TIME_START>', 3, 'UTC')
  AND event_time < toDateTime64('<TIME_END>', 3, 'UTC')
GROUP BY level;
预期输出
... ReadFromMergeTree ...
Indexes:
  ...
  PrimaryKey
  ...
Parts: <READ>/<TOTAL>
Granules: <READ>/<TOTAL>
不同 ClickHouse 版本的文本排版可能不同,诊断重点不是逐字匹配输出,而是比较基线与当前查询最终需要读取的 Part、Granule 以及实际扫描行数是否发生明显变化。
从首个分叉点确定根因
不要从最显眼的慢节点开始猜原因,而要沿着因果链寻找第一个发生变化的指标。延迟只是结果,扫描规模、数据裁剪、Part 数量和执行资源通常更靠近原因。
如果当前查询首先出现 read_rows、read_bytes 或 Granule 数量上升,应检查谓词是否仍命中排序键前缀、数据分布是否漂移,以及表结构或查询写法是否改变。此时单纯增加线程往往只是让更多无效扫描并行发生。
如果扫描规模接近基线,但耗时和内存同时升高,则继续比较聚合、排序、JOIN 等算子的输入规模以及 max_threads、内存限制和机器负载。若只有高并发时回归,还要把单查询问题与资源竞争区分开。
如果延迟上升伴随大量小 Part、Merge 积压或读取文件数量增加,应先处理写入批次与合并压力。不要把长期执行 OPTIMIZE ... FINAL 当成常规修复,它可能制造额外的大规模 I/O。
用同一证据闭环验证修复
修复应针对首个分叉点,而不是针对最终的“慢”。排序键与访问模式不匹配时,可以评估新表结构或投影;查询条件失去裁剪能力时优先修正查询;设置或资源竞争引起回归时,则恢复正确设置或治理并发,而不是改动数据模型。
修复后重新使用完全相同的 SQL、参数、时间范围和统计方法。至少同时检查 p95_ms、read_rows、read_bytes、内存峰值以及 EXPLAIN 的裁剪结果。只有首个异常指标恢复,而且没有把成本转移到写入、合并或其他查询上,才能认为这次性能回归真正闭环。