
大数据与流处理 / 系统课时
设计数据跳过索引
设计数据跳过索引
数据跳过索引不是按“某一行在哪”定位记录,而是在读取 MergeTree 数据前判断“这一批 Granule 能否整体跳过”。本课会把 minmax、set 与 Bloom filter 类索引放到同一套判断框架中,并用 EXPLAIN indexes = 1 验证它们到底跳过了多少 Granule。
学习目标
- 说明数据跳过索引与主键稀疏索引的职责差异
- 根据数据分布和过滤条件选择
minmax、set或 Bloom filter - 使用
EXPLAIN indexes = 1判断索引是否真正减少了 Granule 读取
跳过索引工作在 Granule 层
MergeTree 会把每个 Part 划分为 Granule。数据跳过索引为一个或多个 Granule 保存额外摘要;查询命中相应表达式时,ClickHouse 先检查摘要,如果能证明这一块不可能包含目标值,就不读取对应数据。
这与传统 B-Tree 的“值到行位置”不同。跳过索引的收益取决于同一索引块里的值是否足够集中。即使某列全表选择性很高,只要每个 Granule 都混有目标值,索引仍然几乎跳不过任何数据。
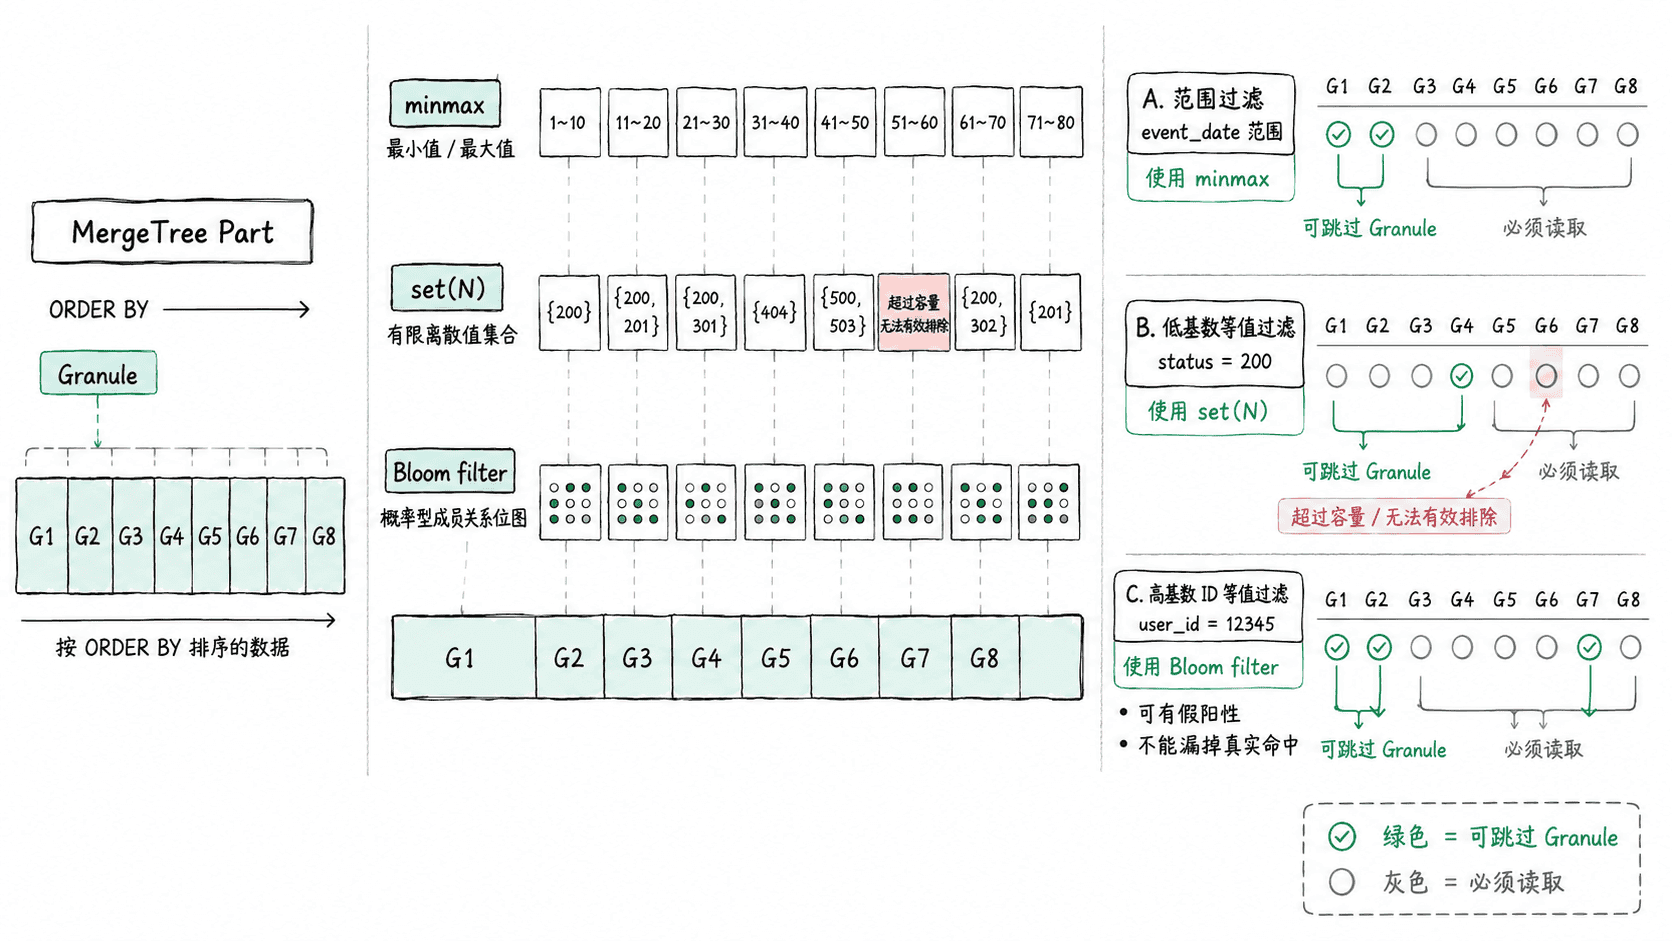
GRANULARITY 1 表示一个跳过索引块覆盖一个表 Granule;更大的值会让索引更小,但摘要覆盖的数据范围也更宽。默认一个 Granule 常接近 index_granularity=8192 行,不过自适应 Granularity 会受行宽等因素影响,因此不要把 8192 当成固定行数。
三类索引怎么选
| 类型 | 保存的信息 | 适合的条件 | 主要限制 |
|---|---|---|---|
minmax |
每个索引块的最小值与最大值 | 数值、日期的范围过滤;目标列与排序顺序有相关性 | 值在每块内跨度很大时难以跳过 |
set(N) |
每块最多 N 个不同值 | 块内离散值很少的等值或 IN 过滤 |
某块不同值超过 N 后,该块的 set 索引会失去排除能力 |
bloom_filter(p) |
概率型成员关系 | 高基数字符串、ID 的等值或集合查询 | 会有假阳性,并增加写入、存储与索引读取成本 |
文本搜索还可以使用 Bloom filter 家族中的 tokenbf_v1、ngrambf_v1。它们解决的是 token 或子串过滤,不应因为列是 String 就默认使用;如果查询只是精确 ID 等值判断,普通 bloom_filter 更直接。
建一个可验证的实验
下面创建 100 万行数据。amount 随时间近似单调,region 以较大的连续区间变化,request_id 高基数且唯一,这三种分布分别给 minmax、set 和 Bloom filter 制造了适合发挥的条件。
-- 清理旧实验表,保证脚本可重复执行。
DROP TABLE IF EXISTS skip_index_demo;

CREATE TABLE skip_index_demo
(
    event_time DateTime,
    tenant_id UInt16,
    region LowCardinality(String),
    request_id String,
    amount UInt32,
    -- 三个索引对应三种不同的数据分布与过滤方式。
    INDEX idx_amount amount TYPE minmax GRANULARITY 1,
    INDEX idx_region region TYPE set(10) GRANULARITY 1,
    INDEX idx_request request_id TYPE bloom_filter(0.01) GRANULARITY 1
)
ENGINE = MergeTree
ORDER BY (tenant_id, event_time);

-- 让 amount、region 与时间顺序具有可观察的局部相关性。
INSERT INTO skip_index_demo
SELECT
    toDateTime('2026-01-01 00:00:00') + number AS event_time,
    toUInt16(number % 10) AS tenant_id,
    arrayElement(
        ['us-east', 'us-west', 'eu'],
        toUInt32(intDiv(number, 300000) % 3) + 1
    ) AS region,
    concat('req-', toString(number)) AS request_id,
    toUInt32(intDiv(number, 100)) AS amount
FROM numbers(1000000);

SELECT count() AS rows
FROM skip_index_demo;
预期输出(最后一条查询):
1000000索引随新写入的 Part 一起生成。如果是在已有大表上执行 ALTER TABLE ... ADD INDEX,历史 Part 还需要通过 ALTER TABLE ... MATERIALIZE INDEX ... 回填;生产环境应先评估 mutation 的 I/O 与合并压力。
用 EXPLAIN 看跳过效果
不要用“查询好像快了”判断索引是否有效。先看执行计划里的 Skip 段,确认索引名称出现,再比较 Granules: <READ>/<TOTAL>。读取 Granule 明显少于总数,才说明索引确实完成了裁剪。
-- 分别验证范围、低基数等值和高基数等值过滤。
EXPLAIN indexes = 1
SELECT count()
FROM skip_index_demo
WHERE amount BETWEEN 4000 AND 4500;

EXPLAIN indexes = 1
SELECT count()
FROM skip_index_demo
WHERE region = 'eu';

EXPLAIN indexes = 1
SELECT count()
FROM skip_index_demo
WHERE request_id = 'req-654321';
预期输出会因 ClickHouse 版本、Part 数和 Granule 划分而变化,但三段计划应分别出现以下关键结构:
Skip
  Name: idx_amount
  Description: minmax GRANULARITY 1
  Granules: <READ>/<TOTAL>

Skip
  Name: idx_region
  Description: set GRANULARITY 1
  Granules: <READ>/<TOTAL>

Skip
  Name: idx_request
  Description: bloom_filter GRANULARITY 1
  Granules: <READ>/<TOTAL>
如果 Skip 完全没有出现,先检查过滤表达式是否与索引表达式匹配;如果出现了但 <READ> 几乎等于 <TOTAL>,问题通常不是“索引没开启”,而是数据在 Granule 中分布得太散、索引块过大,或所选索引类型与查询条件不匹配。
什么时候应该放弃这个索引
上线前至少比较相同查询在真实数据量下的读取 Granule、读取行数、延迟,以及写入和索引占用。minmax 往往成本最低;set 只有块内离散度小才值得;Bloom filter 则要用实际假阳性率与扫描减少量证明收益。
当索引不能稳定减少 Granule 读取时,应优先重新审视排序键、Projection 或物化视图,而不是继续叠加更多跳过索引。数据跳过索引真正优化的是“少读哪些块”,而不是把 ClickHouse 变成逐行索引数据库。