
大数据与流处理 / 系统课时
完成查询性能优化闭环
完成查询性能优化闭环
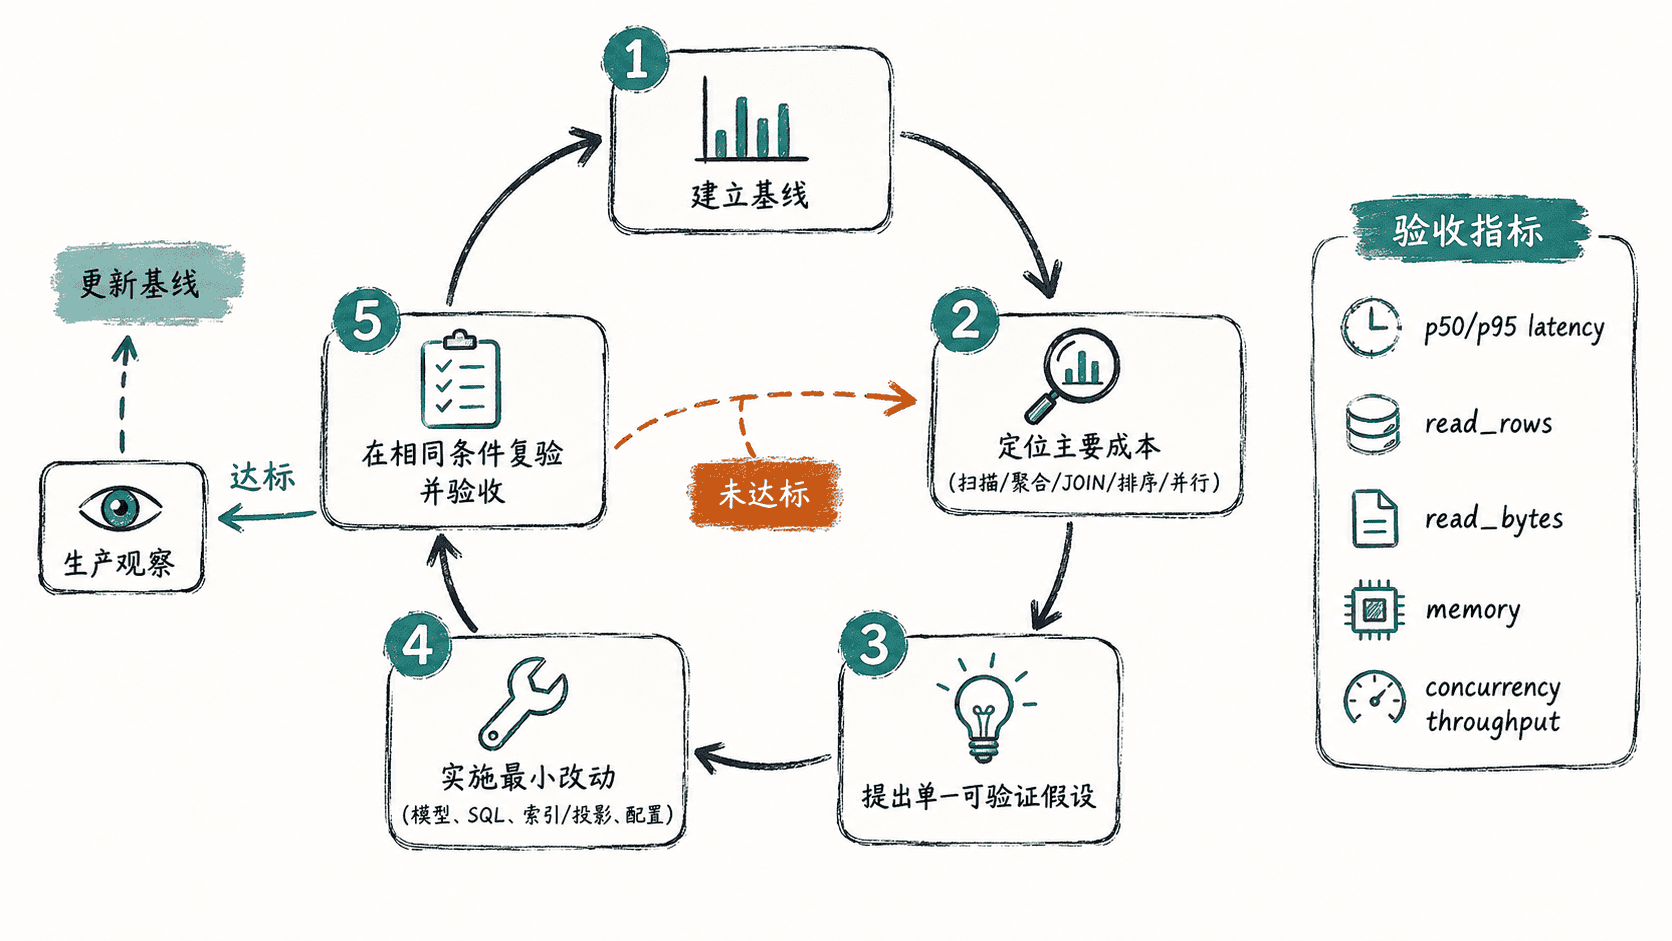
真正的性能优化不是“改完一条 SQL 就结束”,而是从基线出发,找到主要成本,选择最小改动,重新测量并决定是否继续。这个闭环可以避免多项改动同时上线后无法判断究竟是谁带来收益。
学习目标
- 建立基线、假设、改动、复验、验收的闭环流程
- 用扫描量、延迟、内存和并发共同评价优化
- 避免一次叠加多项改动导致因果关系失真
先冻结基线
基线至少包含固定查询集、数据快照、并发度、缓存条件和核心指标。对 ClickHouse 来说,建议记录 p50/p95 延迟、read_rows、read_bytes、memory_usage,同时标记是否发生异常、后台 Merge 或资源争用。
如果没有这份基线,后面的“变快了”只能是主观感受。
每次只验证一个主要假设
例如怀疑排序键不匹配,就先复制代表性数据到新表,仅改变 ORDER BY,保持 SQL 和其他配置不变。若扫描量明显下降,再继续判断延迟和写入成本;不要同时改 SQL、线程数、分区键和缓存设置,否则即使结果更快,也无法确定主要收益来源。
用查询日志做前后对照
下面把最近完成的查询按 query_id 拉出核心指标。实际测试时应给基线和优化后查询分别记录 ID。
sql
-- 用基线与优化后的 query_id 做一对一指标对照。
-- 先刷新系统日志,避免刚完成的查询尚未写入 query_log。
SYSTEM FLUSH LOGS;

SELECT
    query_id,
    query_duration_ms,
    read_rows,
    read_bytes,
    memory_usage,
    exception_code
FROM system.query_log
WHERE type = 'QueryFinish'
  AND query_id IN ('<BASELINE_QUERY_ID>', '<OPTIMIZED_QUERY_ID>')
ORDER BY event_time;
预期结果:
text
<BASELINE_QUERY_ID>     <VALUE>    <VALUE>    <VALUE>    <VALUE>    0
<OPTIMIZED_QUERY_ID>    <VALUE>    <VALUE>    <VALUE>    <VALUE>    0
如果优化后延迟下降但 read_rows、read_bytes 完全没变,收益可能来自缓存、并行度或执行环境;如果扫描量显著下降而延迟改善稳定,通常更能说明模型或裁剪策略真正生效。
以系统目标验收而不是单条最快
生产验收要同时看单查询延迟和系统吞吐。某项改动可能让一条重查询更快,却提高峰值内存,导致高并发下更多排队或 OOM。最终结论应明确收益、代价和适用查询范围,并保留回退方案。
完成一轮后,把验证过的最佳方案更新为新基线。这样下一次数据规模、查询模式或版本变化导致性能回退时,就能从可追溯的基准继续定位,而不是重新从猜测开始。
按自己的节奏,确认真正理解。