
大数据与流处理 / 系统课时
选择宽表与 JOIN 边界
选择宽表与 JOIN 边界
这节课把“ClickHouse 要不要做宽表”变成可执行的判断,而不是固定教条。你会根据维度变化频率、查询热度、读写成本和语义要求,决定哪些属性在写入时展开,哪些保留为独立维度并在查询时 JOIN。
学习目标
- 能判断稳定维度与高频变化维度的处理方式
- 能识别反范式化带来的回填与语义成本
- 能设计同时包含宽表字段和运行时 JOIN 的混合模型
先看读时成本和写时成本
宽表把关联工作提前到写入或物化阶段,查询时只扫描一张表,适合高频、稳定、延迟敏感的访问路径。代价是维度值被复制到大量事实行中,一旦定义变化,可能需要重放数据或回填历史分区。
运行时 JOIN 保留了维度的独立生命周期。它更适合经常变化、需要查询最新状态,或会被多个事实表复用的属性,但每次查询都要付出关联所需的 CPU、内存和中间数据成本。选择边界时要比较两边的总成本,而不是只比较单次查询速度。
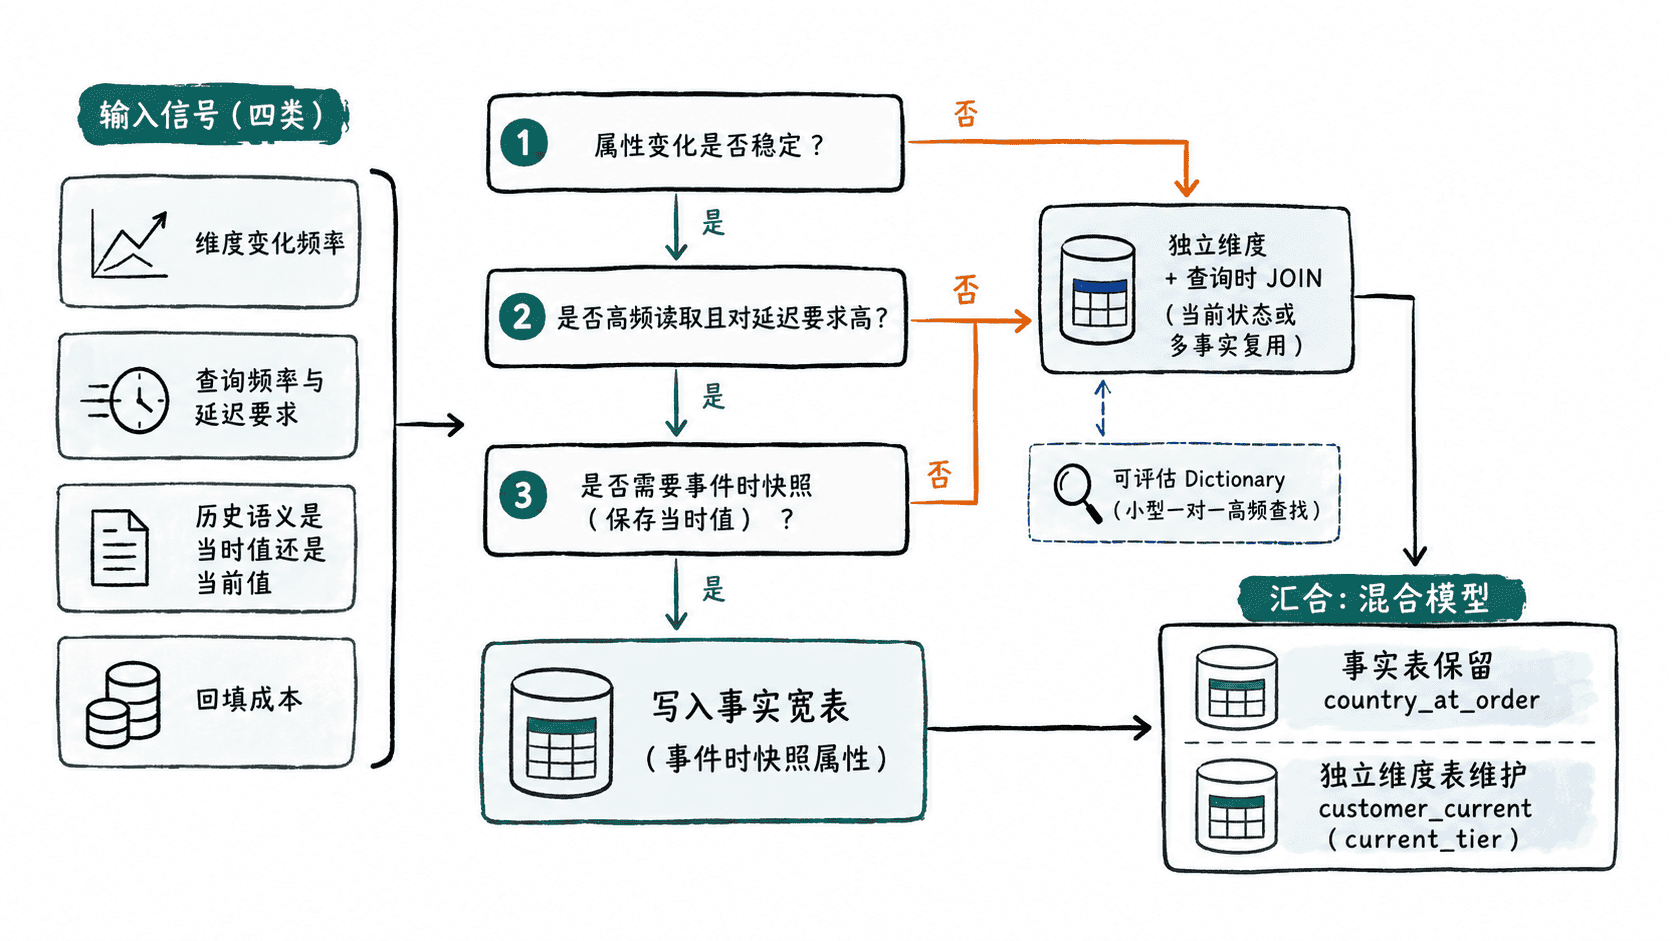
用四个信号决定是否展开
可以把决策压缩为四个问题。属性越稳定、读取越频繁、查询延迟越敏感、回填越容易,越适合在事实表中展开;属性越常变化、越强调“当前值”、越需要被多个模型复用,越适合独立维护。
| 信号 | 更偏向宽表 | 更偏向 JOIN |
|---|---|---|
| 维度变化 | 很少变化,或要求保留事件时快照 | 经常变化且查询要看最新值 |
| 查询模式 | 少数固定热路径反复读取 | 查询组合多、维度复用广 |
| 性能目标 | 尽量减少查询时关联工作 | 可接受关联成本换取灵活性 |
| 维护成本 | 历史回填简单、写入链路可控 | 回填事实表代价高 |
不要把“宽表”理解成把所有维度列永久复制进事实表。更实用的做法是只展开热路径需要且语义稳定的列,同时给易变维度保留关联键。
用混合模型保持两种语义
下面的事实表保存 country_at_order,表示下单当时的国家;客户等级则放在独立表中,查询时取最新值。这样历史事实不需要因为客户等级变化而重写。
DROP TABLE IF EXISTS sales_fact_demo;
DROP TABLE IF EXISTS customer_current_demo;

CREATE TABLE sales_fact_demo
(
    event_id UInt64,
    event_time DateTime,
    customer_id UInt64,
    country_at_order LowCardinality(String),
    amount Decimal64(2)
)
ENGINE = MergeTree
ORDER BY (toDate(event_time), customer_id, event_id);

CREATE TABLE customer_current_demo
(
    customer_id UInt64,
    tier LowCardinality(String),
    updated_at DateTime
)
ENGINE = MergeTree
ORDER BY (customer_id, updated_at);

INSERT INTO sales_fact_demo VALUES
(1, '2026-08-31 10:00:00', 10, 'US', 100.00),
(2, '2026-08-31 12:00:00', 10, 'US', 50.00);

INSERT INTO customer_current_demo VALUES
(10, 'basic', '2026-08-31 09:00:00'),
(10, 'pro',   '2026-08-31 11:00:00');

SELECT
    s.country_at_order,
    c.current_tier,
    sum(s.amount) AS revenue
FROM sales_fact_demo AS s
LEFT JOIN
(
    SELECT
        customer_id,
        argMax(tier, updated_at) AS current_tier
    FROM customer_current_demo
    GROUP BY customer_id
) AS c USING (customer_id)
GROUP BY
    s.country_at_order,
    c.current_tier
ORDER BY
    s.country_at_order,
    c.current_tier;
预期结果:
country_at_order  current_tier  revenue
US                pro           150.00
两笔销售都保留 US 这个事件时快照,但查询时看到的是客户最新等级 pro。如果把 tier 也直接复制进事实行,第一笔销售会永久保留 basic;若业务要求“当前等级口径”,就需要回填历史事实或接受语义不一致。
JOIN 前先保证维度键唯一
运行时 JOIN 最危险的问题不是语法,而是右侧一个业务键出现多条有效记录。如果事实行匹配到多条维度记录,结果会被放大,聚合金额也会随之重复。示例中先用 argMax 按 updated_at 收敛为每个 customer_id 一条当前记录,就是为了明确这个边界。
最终模型通常不是“全宽表”或“全星型模型”二选一:把稳定、热读、需要事件时快照的属性放进事实表,把高频变化或强调当前状态的维度留在独立对象中。这样才能同时控制查询延迟、回填成本和指标语义。