
大数据与流处理 / 系统课时
理解排序键与主键
理解排序键与主键
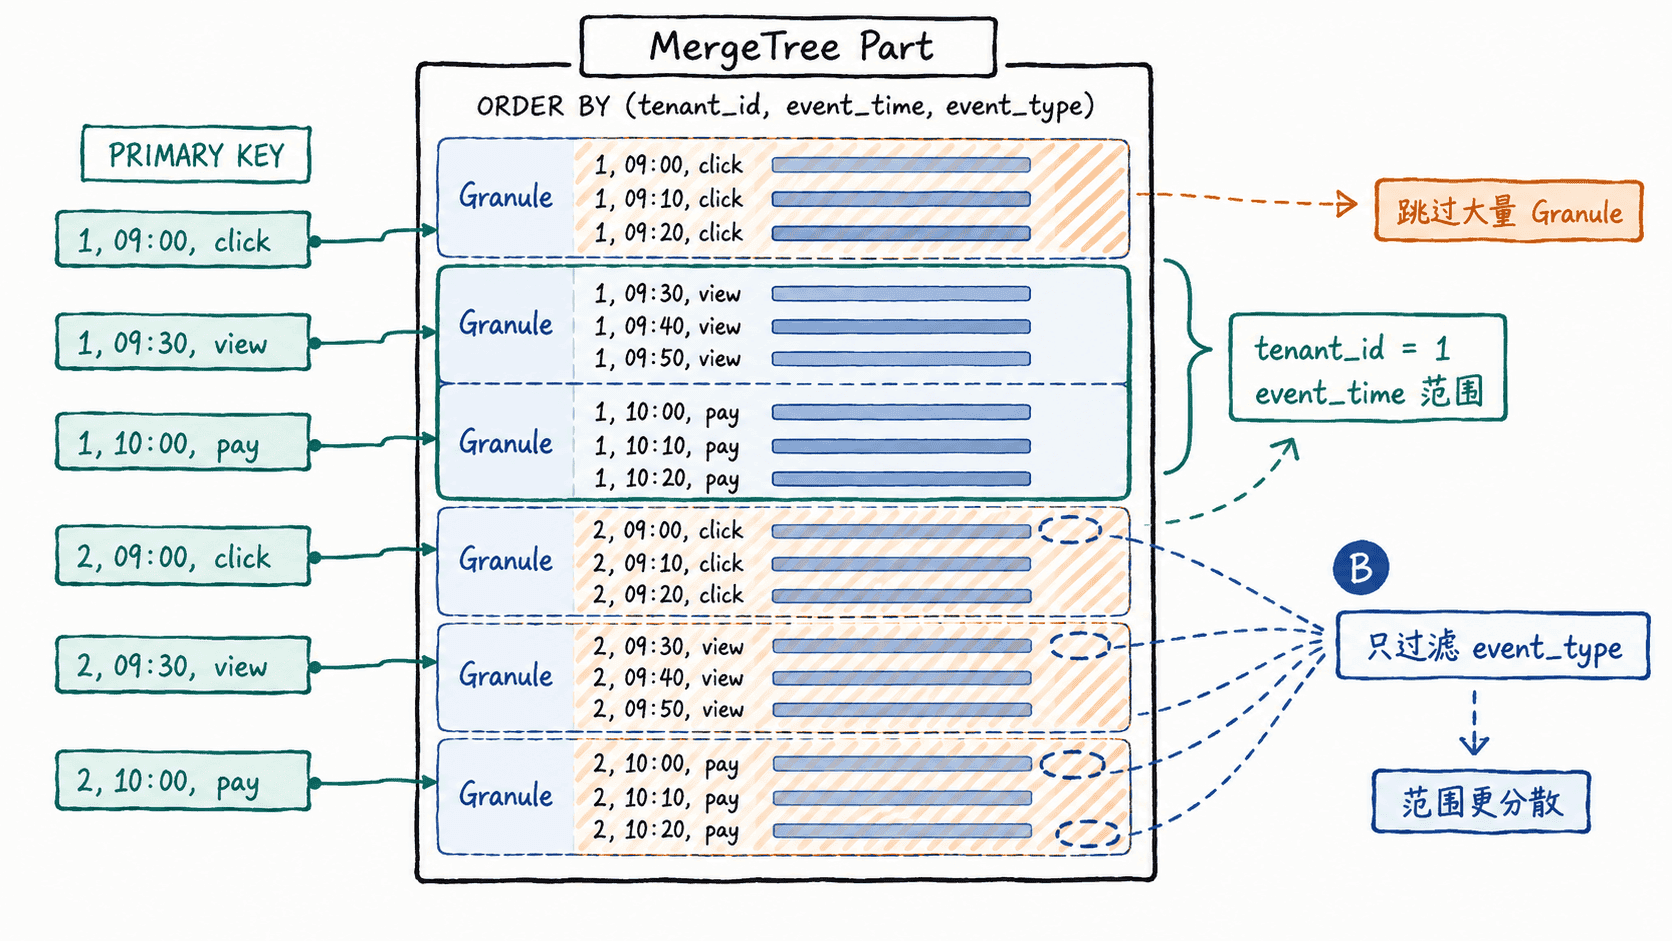
在 MergeTree 中,ORDER BY 决定数据在每个 Part 内的物理排序,PRIMARY KEY 决定稀疏索引保存什么前缀。两者共同影响 ClickHouse 能否把过滤条件转换成连续区间,从而跳过大量 Granule。
学习目标
- 区分排序键与主键在 MergeTree 中的职责
- 理解稀疏索引为何偏好排序键前缀条件
- 用
EXPLAIN验证主键裁剪是否发生
排序键先决定数据怎样排列
假设事件表按 (tenant_id, event_time, event_type) 排序,同一租户的数据会尽量连续,在租户内部再按时间排列。这样的布局特别适合“指定租户 + 时间范围”的查询,因为目标数据在物理上接近连续区间。
sql
-- 用复合排序键制造“租户内按时间连续”的物理布局。
-- 样例数据同时包含两个租户,便于验证前缀过滤。
CREATE TABLE IF NOT EXISTS events_order_demo
(
    tenant_id UInt32,
    event_time DateTime,
    event_type LowCardinality(String),
    value UInt64
)
ENGINE = MergeTree
ORDER BY (tenant_id, event_time, event_type);

INSERT INTO events_order_demo VALUES
(1, '2026-09-02 10:00:00', 'view', 10),
(1, '2026-09-02 10:05:00', 'buy', 20),
(2, '2026-09-02 10:00:00', 'view', 30);

SELECT *
FROM events_order_demo
WHERE tenant_id = 1
  AND event_time >= '2026-09-02 10:00:00'
ORDER BY event_time;
预期结果:
text
1    2026-09-02 10:00:00    view    10
1    2026-09-02 10:05:00    buy     20
主键索引保存稀疏导航点
默认情况下,MergeTree 的 PRIMARY KEY 与 ORDER BY 相同;也可以显式指定排序键表达式的前缀。主键索引不会为每一行建索引,而是在数据标记间隔上记录键值,所以它负责排除不可能命中的数据段,而不是保证唯一性。
前缀匹配决定裁剪强度
对于 (tenant_id, event_time, event_type),只约束 tenant_id 通常已经能形成较大范围裁剪;继续约束 event_time 会更精确。若不约束前面的 tenant_id,只按 event_type 查询,数据往往在整个 Part 中分散,主键索引难以形成同样紧凑的区间。
这不是说“后部列完全不能过滤”,而是它们对主键范围裁剪的贡献通常弱于前缀列。后部列仍可用于普通过滤、数据跳过索引或其他加速结构。
用 EXPLAIN 检查是否真正裁剪
sql
-- indexes = 1 用于显示主键等索引的裁剪信息。
EXPLAIN indexes = 1
SELECT count()
FROM events_order_demo
WHERE tenant_id = 1
  AND event_time >= '2026-09-02 10:00:00';
预期结果:
text
... PrimaryKey ...
... Keys: tenant_id, event_time ...
... Parts: <VALUE>/<VALUE> ...
... Granules: <VALUE>/<VALUE> ...
不同版本的具体文本可能略有差异,但应能看到 Primary Key 相关索引信息以及被选择的 Part、Granule 数量。若过滤条件看似合理却没有明显减少 Granule,就回到排序键前缀、数据分布和谓词写法检查。
按自己的节奏,确认真正理解。