
大数据与流处理 / 系统课时
利用 PREWHERE 减少读取
利用 PREWHERE 减少读取
宽表查询的瓶颈常常不是过滤计算,而是过早读取了大量最终会被丢弃的列。PREWHERE 的价值在于先读取较小的过滤列形成行掩码,再为命中的行读取其余列。本课用同一查询做 A/B 验证,直接观察读取字节量是否下降。
学习目标
- 解释
PREWHERE与普通WHERE在 MergeTree 列读取顺序上的差异 - 构造可重复的宽列实验,并隔离自动 PREWHERE 与懒物化的干扰
- 用执行计划和
system.query_log判断 PREWHERE 是否真的减少列读取
先看 PREWHERE 改变了什么
分区裁剪和主键裁剪决定“哪些 Granule 值得进入读取阶段”;PREWHERE 解决的是进入候选范围之后“先读哪些列”。显式 PREWHERE status = 1 时,ClickHouse 可以先读取 status,过滤掉不匹配的行,再只为存活行读取较大的 payload 列。
普通 WHERE 在现代 ClickHouse 中可能被优化器自动移动到 PREWHERE,因此做性能对比时不能把“写了 WHERE”直接当作无 PREWHERE 基线。要验证机制,应显式关闭自动移动;如果还要隔离懒物化带来的延迟列读取,则同时关闭对应优化。
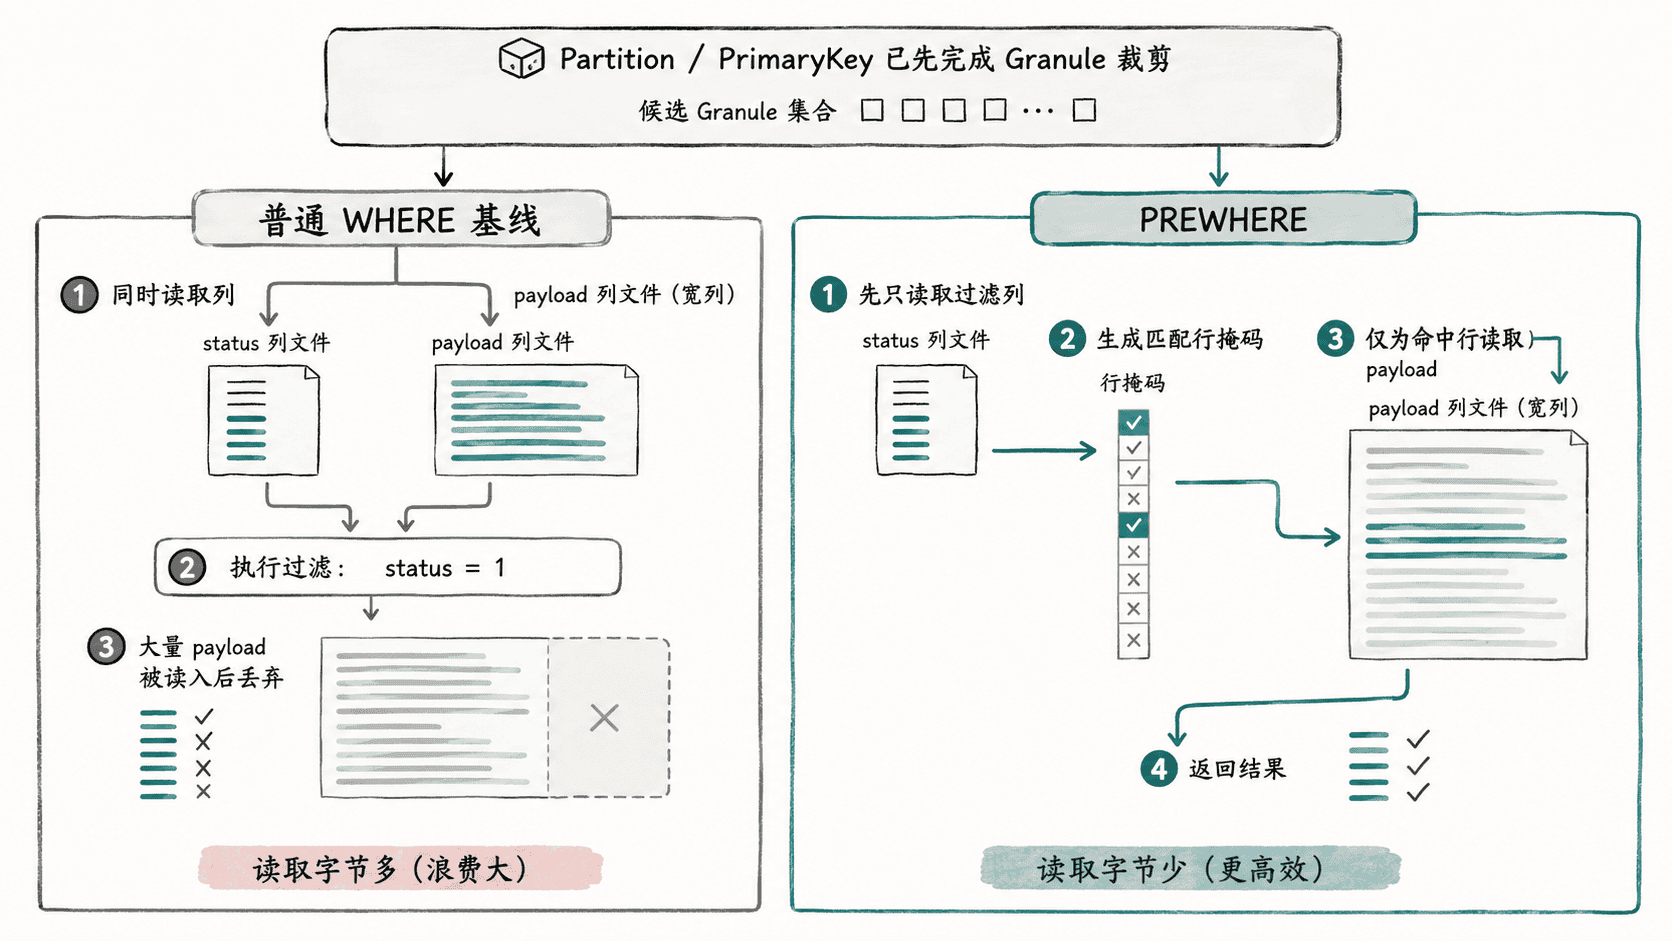
构造一个宽列实验
实验表只用日期排序,让 status 不依赖主键裁剪;payload 固定为 256 字节左右的字符串,只有 1% 的行满足 status = 1。这样更容易观察“先过滤再读宽列”的收益。
DROP TABLE IF EXISTS prewhere_demo;

CREATE TABLE prewhere_demo
(
    event_date Date,
    status UInt8,
    payload String
)
ENGINE = MergeTree
ORDER BY event_date;

-- 200000 行中恰好 2000 行命中 status=1。
INSERT INTO prewhere_demo
SELECT
    toDate('2026-06-01') + toIntervalDay(number % 30) AS event_date,
    toUInt8(number % 100 = 0) AS status,
    repeat(hex(MD5(toString(number))), 8) AS payload
FROM numbers(200000);

SELECT
    count() AS rows,
    countIf(status = 1) AS matched_rows,
    min(length(payload)) AS min_payload_bytes,
    max(length(payload)) AS max_payload_bytes
FROM prewhere_demo;
预期结果
rows    matched_rows  min_payload_bytes  max_payload_bytes
200000  2000          256                256
固定条件做 A/B 并测量读取
为了让差异来自 PREWHERE 本身,两条查询都关闭自动条件搬移和查询计划懒物化。第一条保留普通 WHERE,第二条显式使用 PREWHERE;两条语句必须返回相同聚合结果。
-- A:禁止自动搬到 PREWHERE,作为普通 WHERE 基线。
SELECT sum(length(payload)) AS payload_bytes
FROM prewhere_demo
WHERE status = 1
SETTINGS
    optimize_move_to_prewhere = 0,
    query_plan_optimize_lazy_materialization = 0,
    log_comment = 'where-baseline';

-- B:显式 PREWHERE,只让命中行继续读取 payload。
SELECT sum(length(payload)) AS payload_bytes
FROM prewhere_demo
PREWHERE status = 1
SETTINGS
    optimize_move_to_prewhere = 0,
    query_plan_optimize_lazy_materialization = 0,
    log_comment = 'prewhere-manual';
预期输出
A: payload_bytes = 512000
B: payload_bytes = 512000
这里 read_rows 不一定显著下降,因为两条查询可能仍要检查同一批候选行;PREWHERE 更直接的收益通常体现在 read_bytes,即没有必要为被过滤掉的行读取宽列数据。
执行 A/B 后刷新查询日志,并取两个标签最近一次完成记录。除 read_bytes 外同时看耗时,避免只凭单次时间波动下结论。
SYSTEM FLUSH LOGS;

SELECT
    log_comment,
    argMax(read_rows, event_time_microseconds) AS read_rows,
    formatReadableSize(argMax(read_bytes, event_time_microseconds)) AS read_size,
    argMax(query_duration_ms, event_time_microseconds) AS duration_ms
FROM system.query_log
WHERE type = 'QueryFinish'
  AND log_comment IN ('where-baseline', 'prewhere-manual')
GROUP BY log_comment
ORDER BY log_comment;
预期输出
log_comment      read_rows  read_size  duration_ms
prewhere-manual  <ROWS_B>   <SIZE_B>   <TIME_B>
where-baseline   <ROWS_A>   <SIZE_A>   <TIME_A>

核心验收:<SIZE_B> 应明显小于 <SIZE_A>;耗时受缓存与硬件影响,可能波动。
如果字节差异很小,先检查过滤选择性是否足够高、被延迟读取的列是否真的较宽,以及实验是否仍被其他优化改变。生产环境比较耗时时还应做多次运行,并区分冷热缓存。
确认自动 PREWHERE 是否生效
日常 SQL 不一定需要手写 PREWHERE。开启 optimize_move_to_prewhere 后,优化器会把合适的 WHERE 条件提前。可以用带 actions 的计划检查读取节点是否出现 PREWHERE 信息,而不是从 SQL 文本猜测。
EXPLAIN PLAN actions = 1
SELECT sum(length(payload))
FROM prewhere_demo
WHERE status = 1
SETTINGS
    optimize_move_to_prewhere = 1,
    query_plan_optimize_lazy_materialization = 0;
预期输出
<PLAN>
ReadFromMergeTree (default.prewhere_demo)
...
Prewhere info
...
Prewhere filter column: <PREWHERE_FILTER_EXPRESSION>
计划排版和表达式文字会随版本变化,但关键是读取节点出现 PREWHERE 信息。若没有,再检查表引擎、条件是否适合提前计算以及相关优化设置。
什么时候不该强行手写 PREWHERE
PREWHERE 最适合“小而便宜的过滤列 + 高过滤率 + 后续宽列或多列读取”的组合。如果条件几乎保留所有行,提前过滤省不了多少 I/O;如果主键已经把候选 Granule 缩得很小,额外收益也可能有限。
因此实际优化顺序应是:先确认分区与主键裁剪,再看 PREWHERE 是否减少剩余列读取,最后用 read_bytes 和稳定的多次耗时验证。只要自动优化已经选择了合适条件,就没有必要为了“看起来更快”把所有 WHERE 都改写成手工 PREWHERE。