
大数据与流处理 / 系统课时
设计分片键
设计分片键
分片键决定写入数据落到哪个 shard,也决定后续查询能否把请求限制在少量分片。本课用多租户事件表做例子,从查询路由、数据均衡和热点风险三个维度选择 sharding key,并用实际查询检查分片分布是否符合预期。
学习目标
- 能从高频过滤条件和数据分布中筛选合适的分片键候选
- 能为
Distributed表配置稳定的 sharding key,并理解它与ORDER BY的职责差异 - 能通过各分片行数验证均衡性并识别热点风险
先从查询路由决定候选键
分片键不是“基数越高越好”。更实用的顺序是先看最常见的查询入口,再检查这些键是否足够均匀、稳定。若大多数请求都带 tenant_id,把同一租户稳定映射到同一 shard,可以让按租户查询具备分片裁剪条件;若业务几乎只按时间范围查询,单独使用租户键就无法减少这类查询的 fan-out。
还要检查数据倾斜。高基数键经过哈希后通常更容易均匀,但如果一个超大租户占据大部分数据,即使使用 intHash64(tenant_id),这个租户的全部数据仍会集中到一个 shard。低基数且分布不均的 region、status 一类字段,更容易把写入和查询压力压到少数分片。
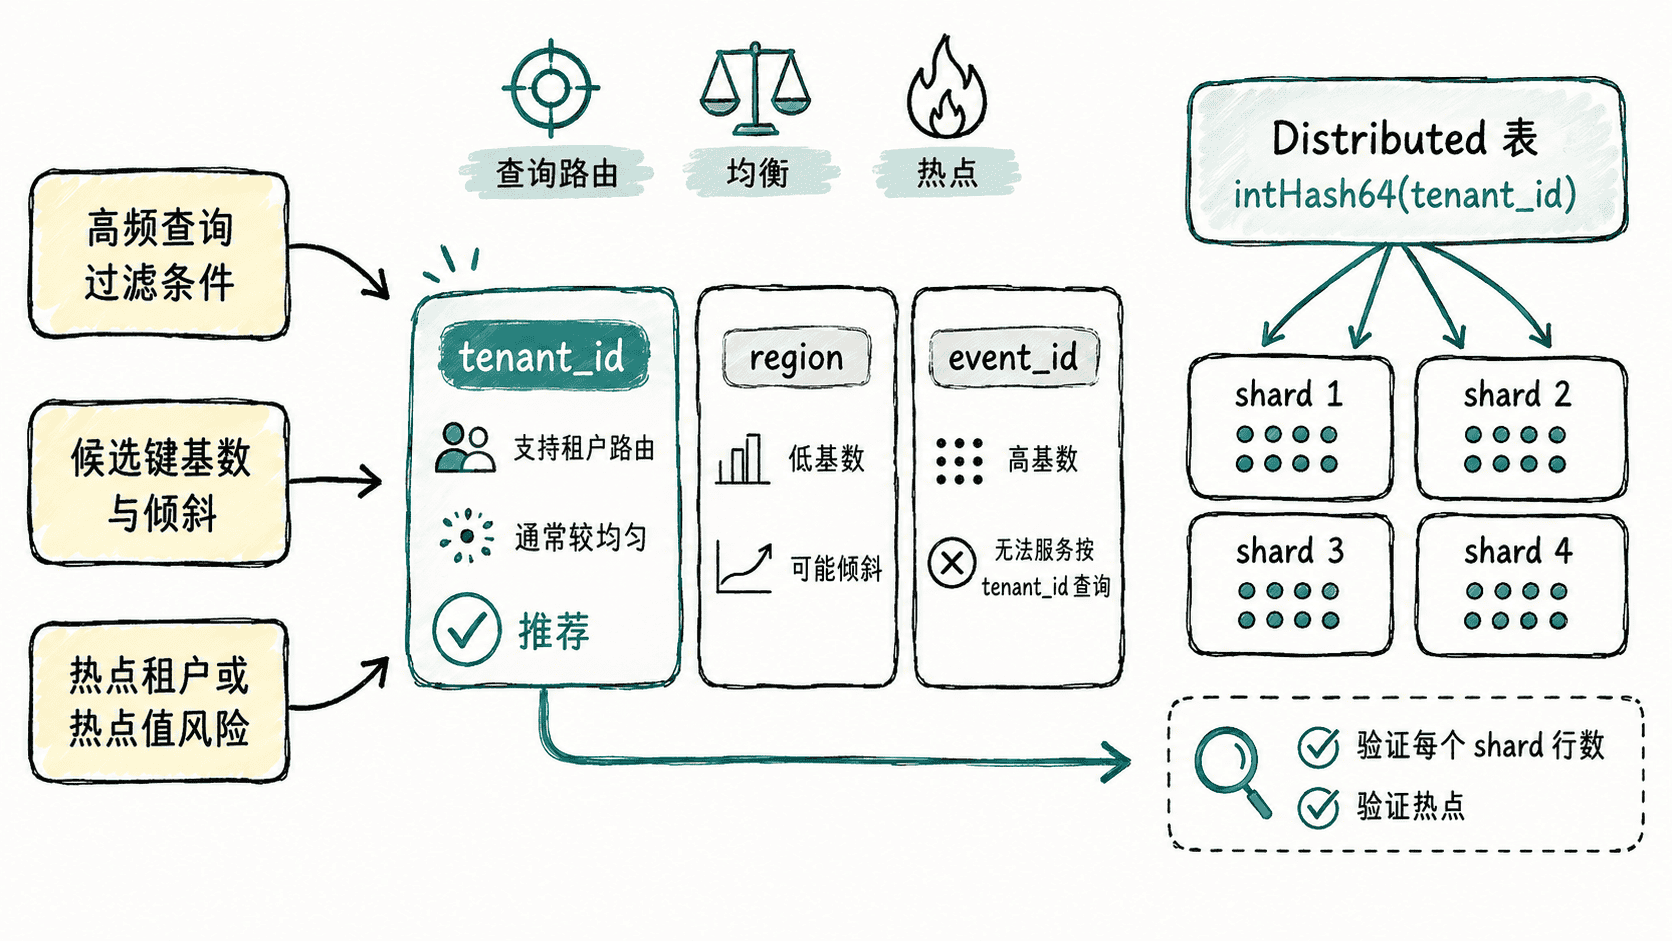
在 Distributed 表中固定路由表达式
下面是片段示例,假设已经存在一个 4 shard、每 shard 1 replica 的 analytics_cluster,并允许执行 ON CLUSTER DDL。先建立本地表,再让分布式表使用 intHash64(tenant_id) 作为 sharding key。
CREATE DATABASE IF NOT EXISTS analytics ON CLUSTER analytics_cluster;

CREATE TABLE IF NOT EXISTS analytics.events_local ON CLUSTER analytics_cluster
(
    tenant_id UInt64,
    event_time DateTime,
    event_type LowCardinality(String)
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(event_time)
ORDER BY (tenant_id, event_time);

CREATE TABLE IF NOT EXISTS analytics.events_all ON CLUSTER analytics_cluster
AS analytics.events_local
ENGINE = Distributed(
    'analytics_cluster',
    'analytics',
    'events_local',
    intHash64(tenant_id)
);
这段配置的生效行为是:向 events_all 写入时,协调节点计算 intHash64(tenant_id) 并据此选择 shard;同一 tenant_id 会得到稳定的路由结果。ORDER BY (tenant_id, event_time) 只负责单个 shard 内的数据排序和稀疏主索引裁剪,两者不要混为一谈。
可用 SHOW CREATE TABLE 检查分布式表是否保存了预期表达式。
SHOW CREATE TABLE analytics.events_all;预期输出中应包含下面的关键部分,实际换行和 UUID 等细节可能不同。
ENGINE = Distributed('analytics_cluster', 'analytics', 'events_local', intHash64(tenant_id))用数据分布验证而不是凭感觉判断
分片键上线前至少要灌入一批具有真实租户分布特征的数据,再从分布式表统计每个 shard 实际承载的行数。hostName() 在远端执行,因此在每个 shard 只有 1 个 replica 的测试集群中,可以直接看到各 shard 对应主机的行数。
SELECT
    hostName() AS host,
    count() AS rows
FROM analytics.events_all
GROUP BY host
ORDER BY host;
预期输出应出现 4 个主机,行数不要求完全一致,但不应有单个 shard 长期占据绝大多数数据。
<HOST_1>    <COUNT_1>
<HOST_2>    <COUNT_2>
<HOST_3>    <COUNT_3>
<HOST_4>    <COUNT_4>
实际值会随测试数据变化。除了看总行数,还应按天或小时重复统计,因为“总体均匀”可能掩盖某个时间窗口的写入热点。若最大 shard 长期是最小 shard 的数倍,应回到租户体量、热点值和业务查询模式重新评估。
处理热点与变更边界
如果少数大租户造成明显热点,不能只通过再套一层哈希解决,因为只要仍要求“一个租户只落一个 shard”,这个大租户就不会被拆开。真正的选择是接受单租户局部性,还是引入额外 bucket 把一个租户拆到多个 shard;后者会改善均衡,却会让按租户查询重新访问多个 shard。
分片键也应尽量选择稳定字段。修改 Distributed 表的 sharding key 只会影响之后按新表达式路由的数据,不会自动搬迁已经存在于各本地表的数据。如果此时直接按新 key 开启分片裁剪,旧数据还可能被错误跳过,造成结果不完整。生产环境需要把“重新分片”当作一次数据迁移:新建目标布局、回填历史数据、校验分布和查询结果,再切换读写入口;迁移完成前不要依据新 key 对旧布局做裁剪。
最终可用一个简单原则收敛选择:优先让高频查询能从过滤条件推导 shard,同时保证数据和写入压力足够均匀;当“查询局部性”和“热点拆分”冲突时,先用真实流量数据量化代价,再决定是否牺牲单 shard 路由。