
大数据与流处理 / 系统课时
分析聚合基数与状态大小
分析聚合基数与状态大小
聚合查询的内存并不只由输入行数决定。真正需要盯住的是分组后的唯一键数量、每个分组维护的聚合状态大小,以及并行线程在合并前保留多少份局部状态。本课用可复现实验把这三项和 CPU、峰值内存联系起来。
学习目标
- 根据分组基数判断哈希聚合的内存增长趋势。
- 区分固定小状态与随数据增长的聚合函数状态。
- 使用
system.query_log对比不同分组基数下的实际峰值内存。
聚合内存为什么会放大
执行 GROUP BY 时,ClickHouse 会把分组键映射到聚合状态。一个新键通常意味着新增一个哈希表条目,并为该组保存 count、sum、uniqExact 等函数需要的中间状态。输入行很多但分组很少时,状态集合可能仍然很小;输入行不变而唯一分组暴涨时,内存会明显上升。
并行执行还会让多个处理流先各自维护局部状态,再进入合并阶段。同一个分组可能暂时出现在多个局部哈希表中,因此峰值内存不能简单理解成“最终结果行数 × 单行大小”。线程越多通常能提高吞吐,但也可能增加尚未合并的中间状态和合并工作。
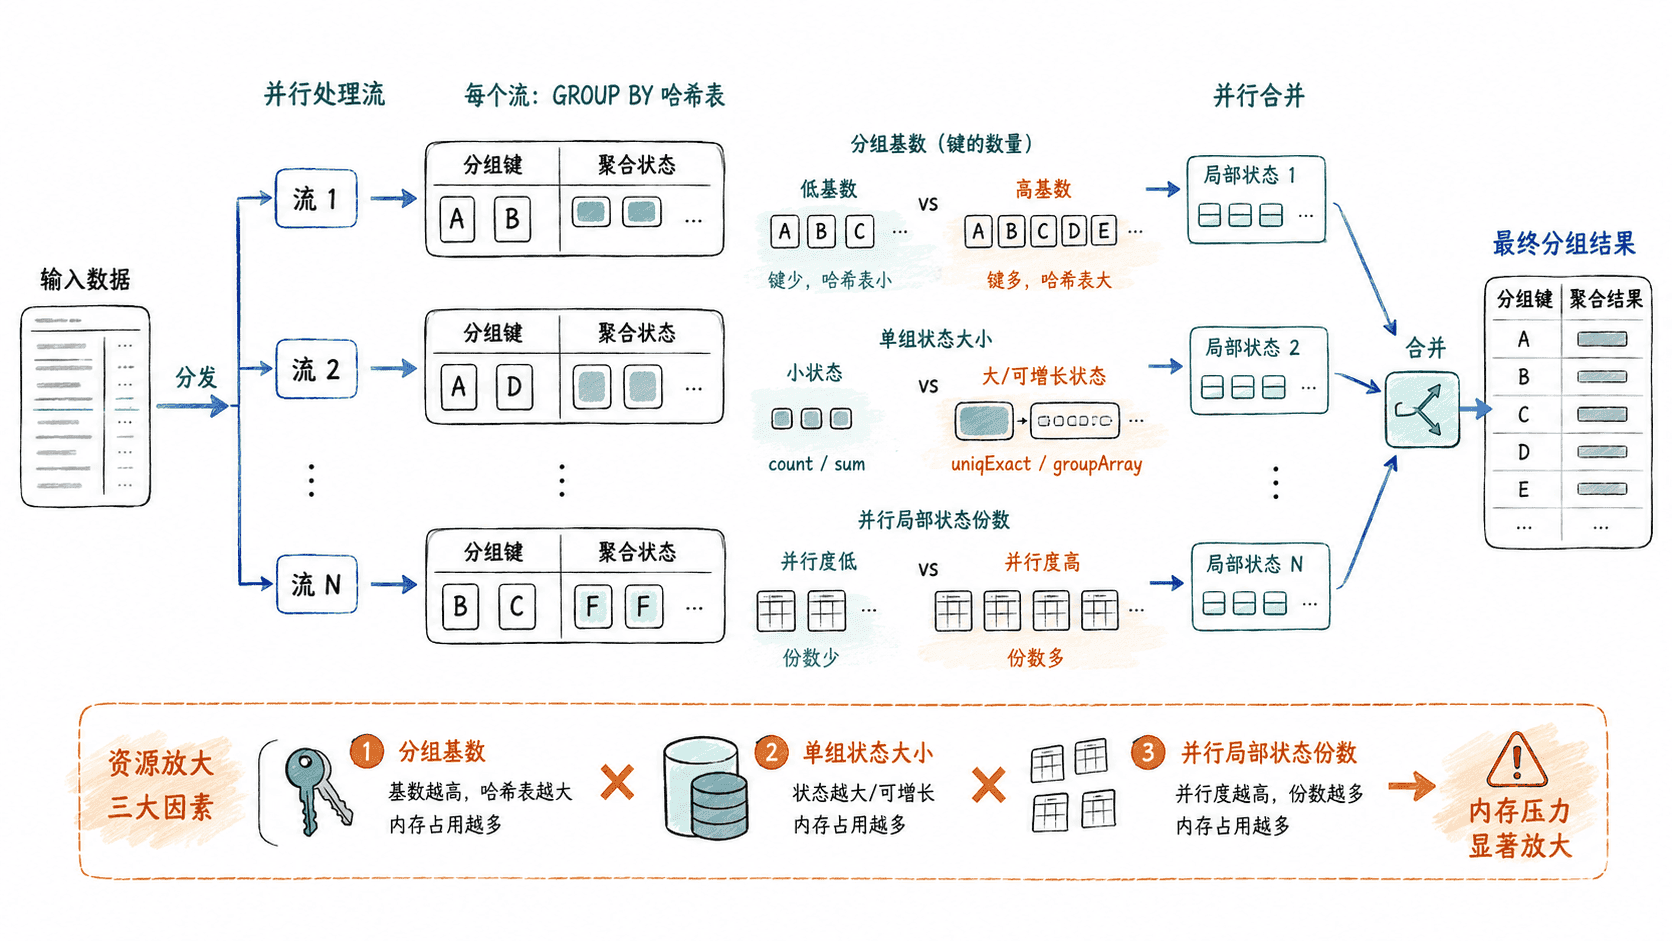
先看分组键,再看聚合函数
判断风险时不要只看 GROUP BY 列有几列,而要估计过滤后实际存在多少个唯一组合。两个各有 1 万个取值的维度,并不代表组合一定有 1 亿个;应以真实组合基数或抽样统计为准。
| 信号 | 状态特征 | 资源含义 |
|---|---|---|
count、sum、min、max |
每组状态较小且大小基本固定 | 主要压力来自分组键数量和哈希表 |
avg |
每组维护少量固定字段 | 通常仍属于轻量状态 |
uniq |
近似去重,状态相对紧凑 | 用精度换更可控的状态规模 |
uniqExact |
精确保存去重所需信息 | 状态会随组内不同值数量增长 |
groupArray |
保存组内元素 | 未限制大小时可能快速放大状态 |
因此,高基数分组配合 uniqExact 或大数组类聚合,比相同基数下的 count 更容易同时压高 CPU、内存和合并开销。若业务允许近似结果或有明确上限,应优先选择状态规模可控的函数,而不是等到内存不足后再补救。
用对照实验观察基数成本
下面两条查询都扫描 1000 万行并只做 count(),区别只有分组基数:第一条最多形成 10 个组,第二条最多形成 100 万个组。FORMAT Null 丢弃结果输出,避免终端渲染影响观察。
clickhouse-client --query_id agg-low --query "SELECT number % 10 AS k, count() FROM numbers_mt(10000000) GROUP BY k FORMAT Null"
clickhouse-client --query_id agg-high --query "SELECT number % 1000000 AS k, count() FROM numbers_mt(10000000) GROUP BY k FORMAT Null"
clickhouse-client --query "SYSTEM FLUSH LOGS"
clickhouse-client --query "SELECT query_id, read_rows, formatReadableSize(memory_usage) AS peak_memory FROM system.query_log WHERE type = 'QueryFinish' AND query_id IN ('agg-low', 'agg-high') AND event_time >= now() - INTERVAL 5 MINUTE ORDER BY query_id FORMAT PrettyCompact"
预期输出
┌─query_id─┬─read_rows─┬─peak_memory─┐
│ agg-high │  10000000 │ <VALUE>     │
│ agg-low  │  10000000 │ <VALUE>     │
└──────────┴───────────┴─────────────┘
<VALUE> 会随 ClickHouse 版本、线程数和内存分配器而变化;关键关系是两条查询读取行数相同,而 agg-high 通常占用明显更多峰值内存。若 system.query_log 未启用或当前账号无读取权限,应先解决观测权限,不能用一次执行耗时替代内存证据。
CPU 与内存要分开判断
高基数会增加哈希查找、插入和最终合并的工作量,因此它既可能提高内存,也可能提高 CPU。大状态函数还会增加每次状态更新和合并的成本。看到慢聚合时,应分别回答“组是不是太多”和“每组状态是不是太重”,否则很容易把两种问题混成一个。
降低 max_threads 有时能减少同时存在的局部状态,却也可能拉长扫描和聚合时间,所以它不是通用修复。更优先的顺序是:提前过滤无关数据、减少不必要的分组维度、选择更小的聚合状态、对固定报表预聚合,再在真实并发下调整线程和内存边界。
建立聚合容量判断顺序
评估一条新聚合查询时,可以按固定顺序收敛问题:
- 估计过滤后需要扫描的行数。
- 估计分组键的真实唯一组合数,而不是机械相乘各列 NDV。
- 判断每个聚合函数的状态是固定小状态,还是会随不同值或元素数量增长。
- 在目标
max_threads和真实并发下执行代表性查询。 - 用
system.query_log.memory_usage对比峰值,并把耗时与内存分别记录。
最终要控制的不是“允许多少输入行”,而是执行期间同时存活的分组键、聚合状态和局部副本。只要这三项能被量化,聚合内存就从不可预测的问题变成可以基准测试和容量规划的问题。