
大数据与流处理 / 系统课时
区分 CPU、内存与 I/O 瓶颈
区分 CPU、内存与 I/O 瓶颈
查询变慢时,CPU 高、内存大或磁盘繁忙都可能只是伴随现象。本课建立一条可复现的证据链,把执行 Pipeline、system.query_log 的 ProfileEvents 与节点资源指标对齐,再据此选择优化方向。
学习目标
- 用查询计划、查询日志和系统指标形成同一时间窗口的诊断证据。
- 区分 CPU 计算、内存压力与 I/O 等待的主要特征。
- 根据主瓶颈选择减少计算、降低中间状态或减少物理读取的优化动作。
建立三层证据链
单看一张 CPU 或磁盘曲线很容易误判。可靠诊断应同时回答三个问题:查询准备做什么、查询实际消耗了什么、节点当时是否真的饱和。
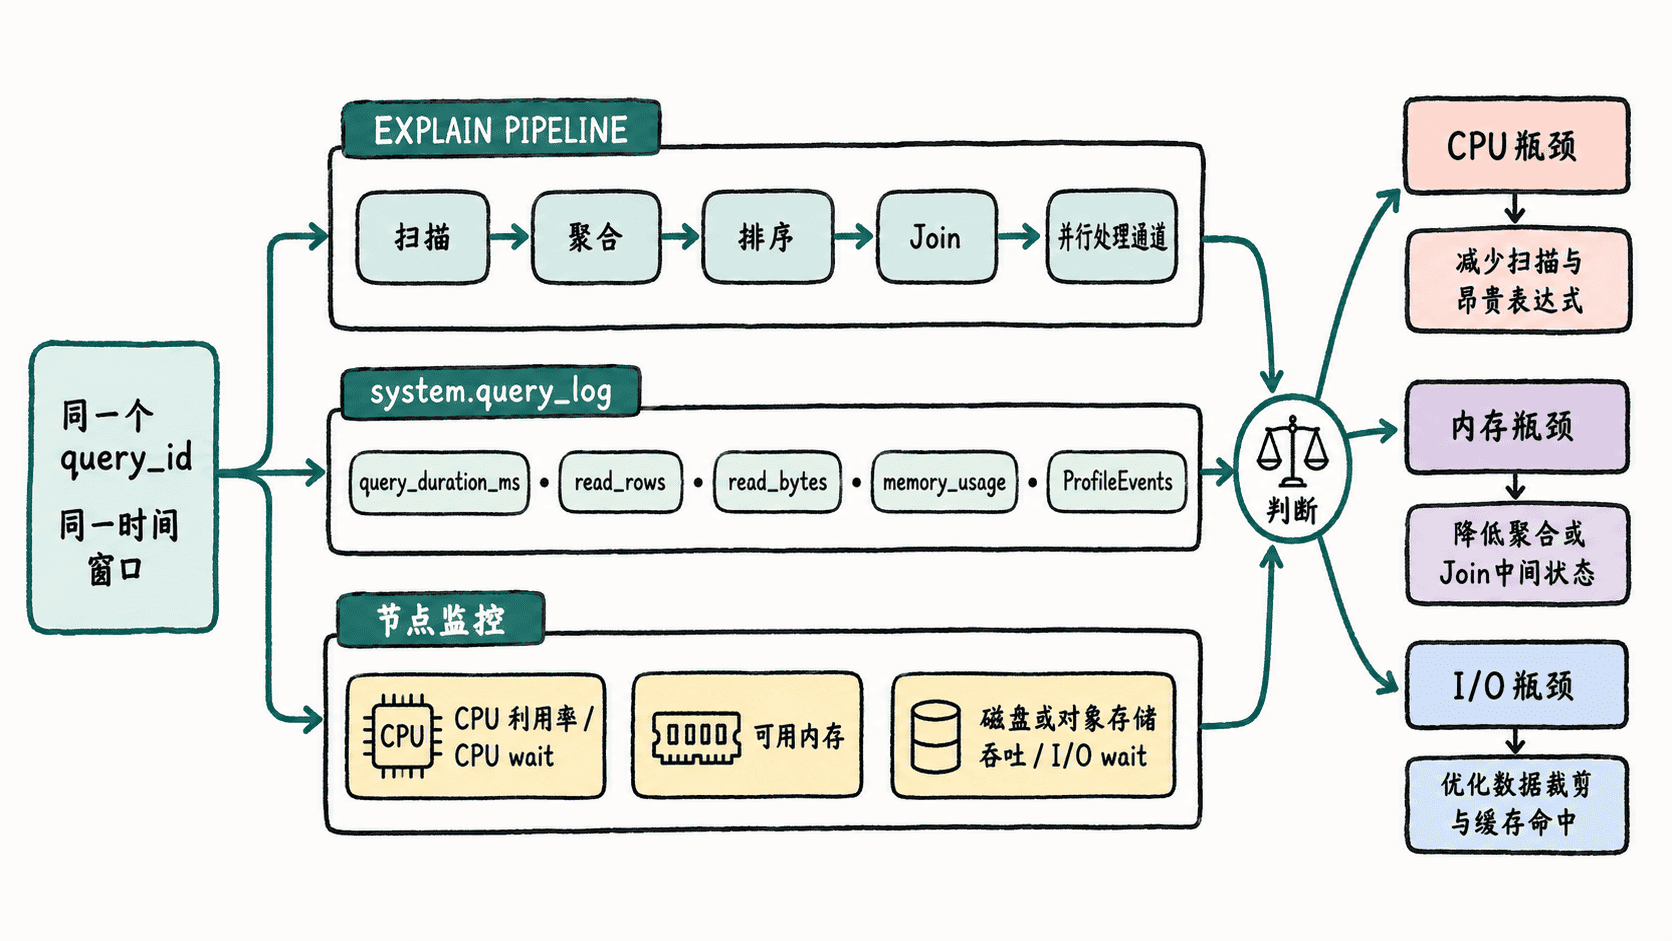
第一层看 EXPLAIN PIPELINE:它告诉你扫描、聚合、排序、Join 等算子如何组成处理链,以及并行通道大致在哪里出现。第二层看查询级计数器;第三层再看同一时间窗口的 CPU、内存、磁盘或对象存储指标。三层证据一致,才能把“资源使用高”升级为“资源是主要瓶颈”。
采集一次可复现的查询证据
下面用 numbers_mt 构造一条偏 CPU 的诊断查询,并显式设置 query_id。FORMAT Null 避免结果传输干扰,SYSTEM FLUSH LOGS 用于让查询日志尽快可查。
clickhouse-client --query "EXPLAIN PIPELINE SELECT sum(cityHash64(number)) FROM numbers_mt(10000000)"
clickhouse-client --query_id diag-cpu-001 --query "SELECT sum(cityHash64(number)) FROM numbers_mt(10000000) FORMAT Null"
clickhouse-client --query "SYSTEM FLUSH LOGS"
clickhouse-client --query "SELECT query_duration_ms, read_rows, formatReadableSize(read_bytes) AS read_bytes, formatReadableSize(memory_usage) AS peak_memory, ProfileEvents['UserTimeMicroseconds'] / 1e6 AS user_cpu_s, ProfileEvents['SystemTimeMicroseconds'] / 1e6 AS sys_cpu_s, ProfileEvents['OSCPUWaitMicroseconds'] / 1e6 AS cpu_wait_s, ProfileEvents['OSIOWaitMicroseconds'] / 1e6 AS io_wait_s, ProfileEvents['DiskReadElapsedMicroseconds'] / 1e6 AS disk_read_s, formatReadableSize(ProfileEvents['OSReadBytes']) AS os_read_bytes FROM system.query_log WHERE type = 'QueryFinish' AND query_id = 'diag-cpu-001' ORDER BY event_time DESC LIMIT 1 FORMAT Vertical"
预期输出中,Pipeline 的处理器数量会随 ClickHouse 版本与 max_threads 改变;性能值也与硬件有关,因此只核对字段是否出现。
<EXPLAIN PIPELINE 输出>

Row 1:
──────
query_duration_ms: <VALUE>
read_rows: <VALUE>
read_bytes: <VALUE>
peak_memory: <VALUE>
user_cpu_s: <VALUE>
sys_cpu_s: <VALUE>
cpu_wait_s: <VALUE>
io_wait_s: <VALUE>
disk_read_s: <VALUE>
os_read_bytes: <VALUE>UserTimeMicroseconds、SystemTimeMicroseconds 等计数可能跨多个执行线程累计,所以 CPU 秒数可以大于查询墙钟时间;DiskReadElapsedMicroseconds 也不能直接当成查询耗时。诊断要比较相对变化,并结合并行度与节点监控,而不是把单个计数器除以墙钟时间后机械下结论。
判定 CPU、内存与 I/O
| 主瓶颈 | 查询级证据 | 系统级证据 | 优先优化方向 |
|---|---|---|---|
| CPU | 用户态/内核态 CPU 时间高,扫描或表达式计算量大;CPU wait 上升时还可能存在调度竞争 | CPU 长时间接近饱和,load 或 CPU wait 同步升高 | 先减少读取行数与无效列,再处理昂贵函数、聚合和过高并行度 |
| 内存 | memory_usage 高,Join、GROUP BY、排序等需要维护大中间状态,或出现内存上限错误 |
可用内存下降、并发查询叠加后压力明显 | 降低基数与中间结果,缩小 Join 构建侧,控制并发和单查询资源 |
| I/O | read_bytes 大且磁盘读取等待、OS I/O wait 等指标明显,冷缓存时尤其突出 |
磁盘/对象存储吞吐接近上限,I/O wait 或远端读取延迟升高 | 优化 ORDER BY 与数据裁剪,只读必要列,检查缓存与存储带宽 |
read_bytes 表示查询读取的数据量,不等同于物理磁盘读取量:命中页缓存或 ClickHouse 文件系统缓存时,扫描很多字节也可能几乎不触发底层磁盘。反过来,在对象存储场景中,远端请求延迟和缓存命中率也要纳入 I/O 证据。
排除常见误判
CPU 利用率高不一定表示“CPU 算不动”。如果大量线程在等待调度,OSCPUWaitMicroseconds 与节点 CPU 饱和同时升高,更像是并发或 max_threads 过度争抢;此时再提高单查询并行度通常只会恶化尾延迟。
内存用得多也不等于内存瓶颈。高基数聚合本来就会占用较大内存,只要没有触顶、抖动、OOM 或明显的并发挤压,它可能仍是合理资源交换。不要把“调高 max_memory_usage”当成第一修复动作,否则只是把失败点向后推。
I/O 诊断尤其要区分冷热缓存。冷缓存慢、热缓存快,说明物理读取是关键变量;两者都慢且 CPU 已饱和,则问题更可能在计算。进行对比时必须保持数据范围、查询文本、并发度和后台负载一致。
把证据映射到优化动作
优化顺序应从减少工作量开始,而不是先给资源加上限。CPU 型查询优先检查是否能通过排序键、分区裁剪、跳数索引、Projection 或预计算减少进入算子的行数;随后再考虑表达式与并行度。内存型查询先缩小聚合状态、排序集合和 Join 构建侧,再决定是否调整资源限制。
I/O 型查询则先确认读了哪些列、多少 granule,以及冷缓存下的实际物理读取,再优化数据布局和缓存策略。完成修改后,用相同 query_id 规则、相同查询参数和相同负载重新采样;只有查询级计数器与系统资源曲线同时朝预期方向变化,才能说明优化真正命中了瓶颈。