
大数据与流处理 / 系统课时
理解本地表与 Distributed 表
理解本地表与 Distributed 表
在自建 ClickHouse 集群里,本地 MergeTree 表负责真正保存 Part、执行排序与索引裁剪;Distributed 表负责把同一个逻辑表映射到多个分片。理解这两层后,你就能判断一条 SELECT 在哪里扫描数据、一条 INSERT 又是怎样被路由到目标分片的。
学习目标
- 区分本地 MergeTree 表与
Distributed表的存储职责 - 读懂分布式查询从发起节点到各分片再汇总的链路
- 通过最小 DDL 和查询验证分片写入与全局读取
本地表负责存储,Distributed 负责路由
每个分片上的本地表通常使用 MergeTree 或 ReplicatedMergeTree 家族。真正的数据 Part、排序键、主键索引、跳过索引、TTL 和后台 Merge 都属于这一层。
Distributed 是一层逻辑路由。它通过 Distributed(cluster, database, table, sharding_key) 指向集群中的同名本地表,本身不拥有 MergeTree 数据 Part。异步写入时,发起节点可以暂存待发送批次,但最终数据仍落在远端本地表中。
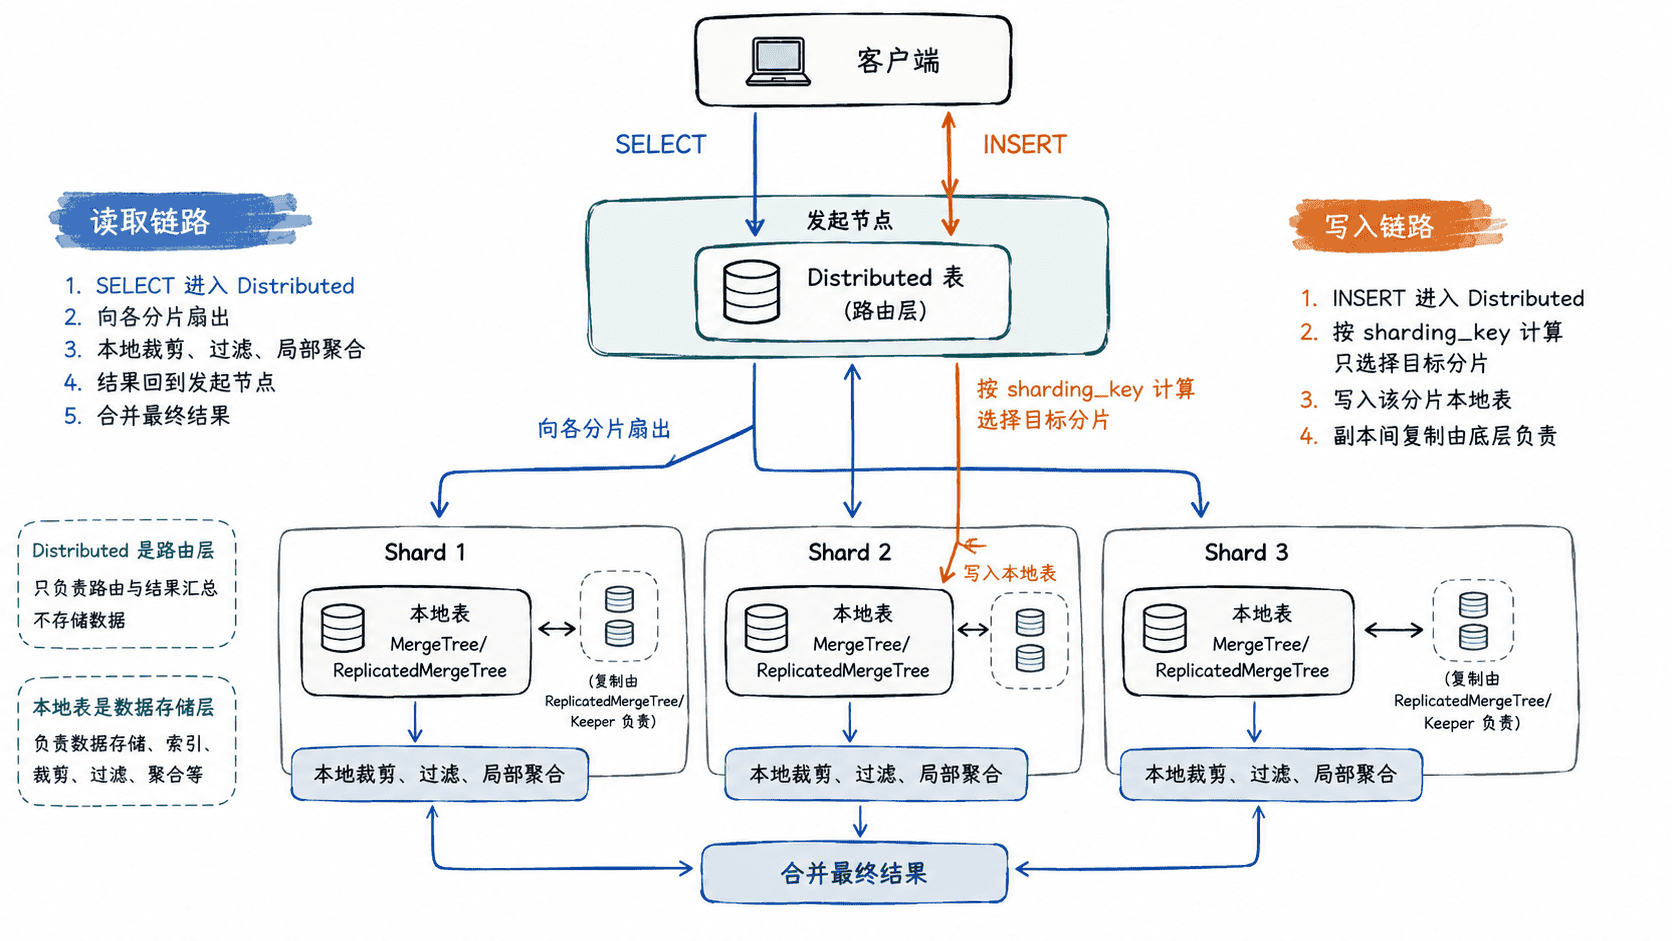
这个边界很重要:给 Distributed 表定义一个看似漂亮的名字,并不会替代本地表设计。决定单分片扫描效率的仍是本地表的 ORDER BY、分区、索引和数据组织。
读取为什么会跨分片
客户端在任意可访问节点查询 Distributed 表时,该节点成为查询发起者。它根据集群拓扑把子查询发到相关分片;每个远端节点读取自己的本地表,先完成可下推的过滤、局部聚合等工作,再把中间结果传回发起者完成最终合并。
有副本时,普通分布式读取通常会按负载均衡和可用性策略从分片副本中选择合适节点。分片解决“不同数据放到不同节点”,副本解决“同一份分片数据的冗余与读取容量”,两者不能混为一谈。
如果过滤条件能够约束分片键,并且启用了相应的 shard pruning 优化,ClickHouse 还可能跳过不相关分片;否则应按需要访问多个分片来理解网络和并行成本。
写入如何选中一个分片
向 Distributed 表执行 INSERT 时,ClickHouse 根据 sharding_key 为行选择目标分片。合理的分片键要同时考虑数据均匀性和常见查询:严重倾斜会让某个分片成为容量与 CPU 热点,而完全随机的键又可能让经常按业务实体过滤的查询无法减少分片访问。
默认写入可以经过 Distributed 的后台发送队列。需要实验后立刻读取并验证时,可以设置 insert_distributed_sync = 1,让本次写入等待远端发送完成。生产系统是否同步写,应按吞吐、延迟和故障语义权衡,而不是长期照搬实验设置。
如果一个分片内部使用 ReplicatedMergeTree,通常让复制层负责把数据扩散到该分片的其他副本;不要把“分片路由”和“副本复制”当成同一个动作。
用最小集群验证两层表
下面假设已经存在名为 <CLUSTER> 的 ClickHouse 集群配置,并使用“每个分片一个副本”的最小实验拓扑。示例在所有节点创建同结构的本地表,再创建一个指向它的 Distributed 表;把 <CLUSTER> 替换为 system.clusters 中的实际集群名后执行。生产集群若每个分片有多个副本,应把本地表换成相应的 ReplicatedMergeTree 设计并配置复制关系。
-- ON CLUSTER 只负责把 DDL 发送到集群节点。
CREATE DATABASE IF NOT EXISTS analytics
ON CLUSTER '<CLUSTER>';

CREATE TABLE IF NOT EXISTS analytics.events_local
ON CLUSTER '<CLUSTER>'
(
    event_time DateTime,
    user_id UInt64,
    event LowCardinality(String)
)
ENGINE = MergeTree
ORDER BY (event, event_time, user_id);

-- Distributed 表只保存路由定义,真正的数据仍写入 events_local。
CREATE TABLE IF NOT EXISTS analytics.events_all
ON CLUSTER '<CLUSTER>'
AS analytics.events_local
ENGINE = Distributed(
    '<CLUSTER>',
    analytics,
    events_local,
    cityHash64(user_id)
);

-- 实验中同步发送,确保 INSERT 返回后可以立即读取远端结果。
SET insert_distributed_sync = 1;

INSERT INTO analytics.events_all VALUES
('2026-09-01 00:00:00', 101, 'view'),
('2026-09-01 00:00:01', 202, 'click'),
('2026-09-01 00:00:02', 303, 'purchase');

SELECT
    count() AS rows,
    uniqExact(user_id) AS users
FROM analytics.events_all;
预期输出:
3 3这条结果证明 events_all 能作为全局入口看到三个用户,但还不能证明它们落在哪个分片。继续查询 Distributed 提供的虚拟列 _shard_num,可以直接观察全局结果来自哪些分片。
-- _shard_num 用来观察 Distributed 结果实际来自哪些分片。
SELECT
    _shard_num AS shard,
    count() AS rows
FROM analytics.events_all
GROUP BY _shard_num
ORDER BY shard;
预期输出的具体分片号和每个分片的行数取决于 <CLUSTER> 的分片数量、权重以及 cityHash64(user_id) 的计算结果,形态如下:
<SHARD>	<ROWS>
<SHARD>	<ROWS>
...
各行 <ROWS> 之和应为 3。若所有行都集中在一个分片,不一定说明 Distributed 失效;只有三条样本时很容易碰巧集中。验证真实分布时应扩大样本量,并检查 system.clusters 中的 shard/replica 配置。
读写问题应该去哪里查
查询 Distributed 表慢时,先区分“单分片本地扫描慢”还是“跨分片协调慢”。前者应在对应本地表检查读取行数、排序键和索引;后者再检查分片数量、网络、远端并发与最终聚合成本。
写入异常时也按层定位:本地表写不进去,检查表结构、磁盘与 MergeTree;Distributed 队列堆积,则检查目标节点可达性、后台发送和分片配置。只盯着 Distributed 表名,很容易把路由问题和存储问题混在一起。