
大数据与流处理 / 系统课时
用 Dictionary 加速维度查找
用 Dictionary 加速维度查找
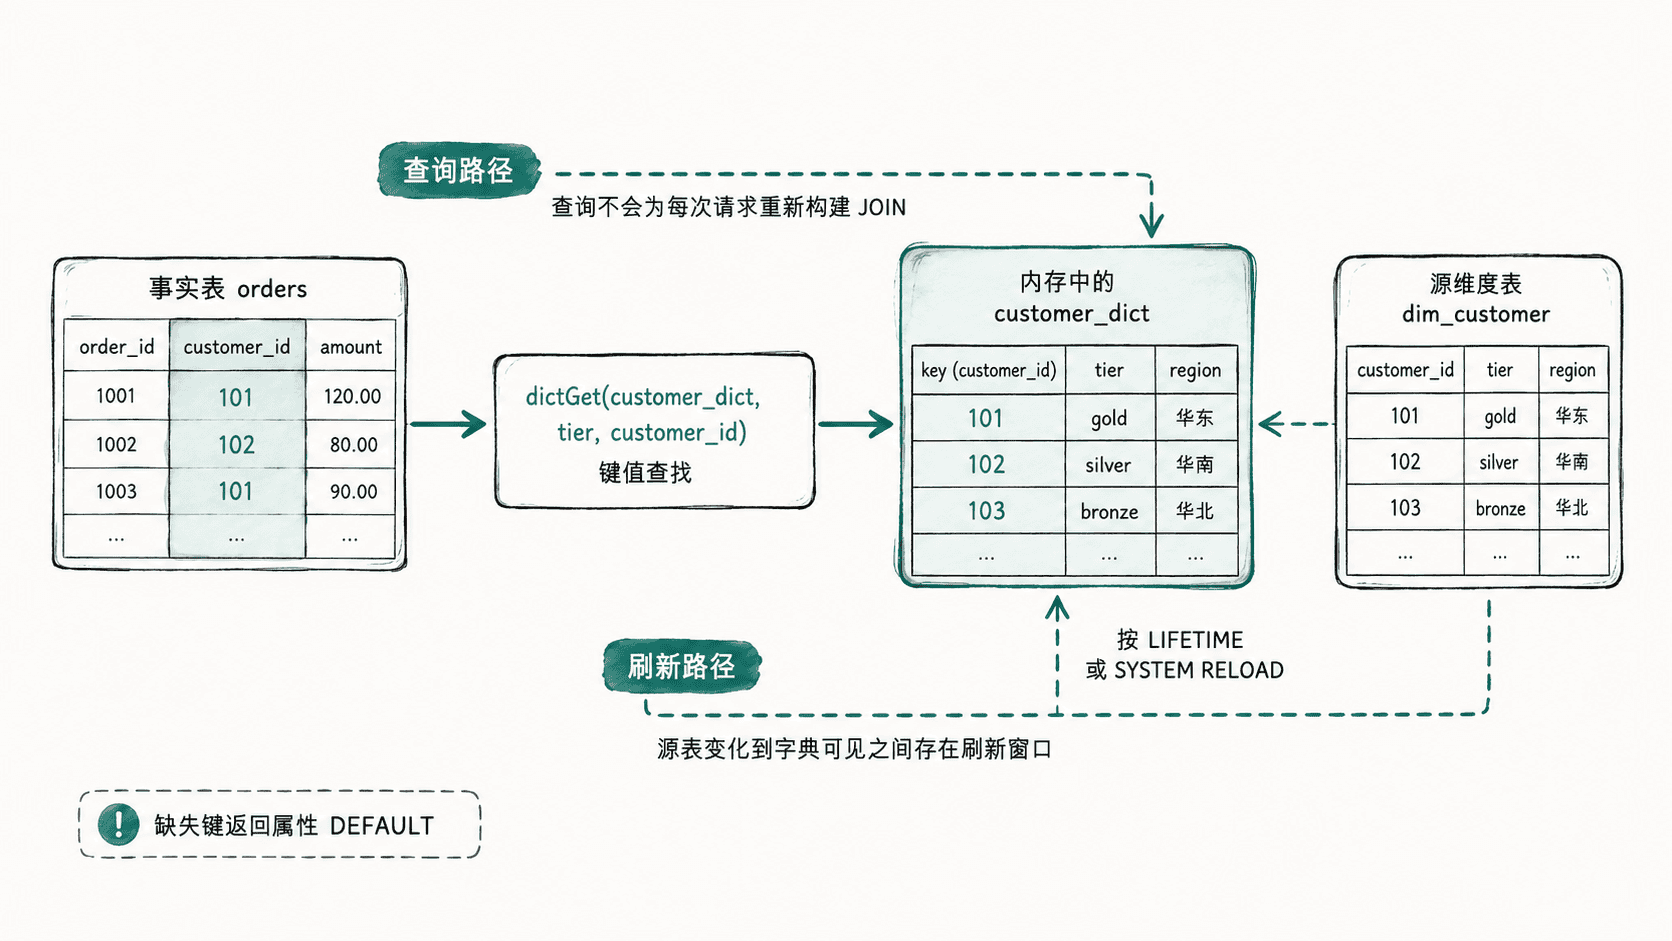
当事实表查询只需要按键补充客户等级、地区等单值维度时,Dictionary 可以把反复构建 JOIN 的成本改成键值查找。本课会完成一个可运行示例,并把布局、刷新、一致性和收益验证放在同一条设计链路中。
学习目标
- 判断一对一或多对一维度是否适合改成 Dictionary 查找
- 使用
CREATE DICTIONARY与dictGet完成查询,并验证缺失键行为 - 根据数据规模、刷新延迟和查询收益选择布局与刷新策略
先判断 Dictionary 是否匹配访问模式
Dictionary 的核心不是“把维表换一种语法”,而是为按唯一键取属性提供专用查找结构。典型场景是事实表有 customer_id,查询只需要得到该客户的 tier、region 等一个确定值;这类一对一或多对一关系很适合 Dictionary。
如果业务需要一对多明细、保留所有匹配行、复杂范围连接,或者维度值必须在每次查询时绝对读取最新版本,就不应为了消除 JOIN 强行改成 Dictionary。Dictionary 还会引入加载内存、刷新源和一致性窗口,需要一起计入成本。
建立一个可验证的维度字典
下面使用本机 ClickHouse 表作为 Dictionary 数据源。为了稳定演示刷新窗口,把自动刷新周期设为 3600 秒;生产环境应按可接受陈旧时间和源端负载重新设定。
DROP DICTIONARY IF EXISTS customer_dict;
DROP TABLE IF EXISTS dim_customer;
DROP TABLE IF EXISTS orders;

CREATE TABLE dim_customer
(
    customer_id UInt64,
    tier String,
    region String
)
ENGINE = Memory;

INSERT INTO dim_customer VALUES
    (1, 'gold', 'east'),
    (2, 'silver', 'west'),
    (3, 'bronze', 'east');

CREATE TABLE orders
(
    order_id UInt64,
    customer_id UInt64,
    amount Decimal(10, 2)
)
ENGINE = Memory;

INSERT INTO orders VALUES
    (1001, 1, 88.00),
    (1002, 3, 36.50),
    (1003, 99, 12.00);

CREATE DICTIONARY customer_dict
(
    customer_id UInt64,
    tier String DEFAULT 'unknown',
    region String DEFAULT 'unknown'
)
PRIMARY KEY customer_id
SOURCE(CLICKHOUSE(TABLE 'dim_customer'))
LIFETIME(MIN 3600 MAX 3600)
LAYOUT(HASHED());
预期结果
各条 DDL 与 INSERT 均执行成功,无异常。事实查询只携带维度键,通过 dictGet 读取属性。字典中不存在 customer_id=99 时,返回该属性在字典定义中的 DEFAULT,因此缺失键行为是可控的。
SELECT
    order_id,
    customer_id,
    dictGet('customer_dict', 'tier', customer_id) AS tier,
    dictGet('customer_dict', 'region', customer_id) AS region
FROM orders
ORDER BY order_id;
预期输出
┌─order_id─┬─customer_id─┬─tier────┬─region──┐
│     1001 │           1 │ gold    │ east    │
│     1002 │           3 │ bronze  │ east    │
│     1003 │          99 │ unknown │ unknown │
└──────────┴─────────────┴─────────┴─────────┘
把刷新窗口当成一致性契约
Dictionary 读取的是已经加载的字典内容,而不是每次 dictGet 都回源查询。源表发生变化后,在下一次自动刷新或手工重载前,查询可能继续看到旧值。下面先替换源数据,再观察重载前后的结果。
TRUNCATE TABLE dim_customer;

INSERT INTO dim_customer VALUES
    (1, 'gold', 'east'),
    (2, 'gold', 'west'),
    (3, 'bronze', 'east');

SELECT dictGet('customer_dict', 'tier', toUInt64(2)) AS before_reload;

SYSTEM RELOAD DICTIONARY customer_dict;

SELECT dictGet('customer_dict', 'tier', toUInt64(2)) AS after_reload;
预期输出
before_reload
silver

after_reload
gold
实际客户端还会显示每条语句的耗时等动态信息,本例只保留关键结果。生产环境不应频繁用手工重载替代刷新策略;应先定义“维度最多允许陈旧多久”,再设置 LIFETIME,并监控源端读取压力与字典加载失败。
选择布局并验证收益
HASHED 适合通用单键维度,通常以较可预测的内存换取快速查找;连续且范围受控的整数键可以评估 FLAT;复合键可选择对应的 complex-key 布局。缓存型布局只有在工作集命中率足够高、且源端能够承受 miss 回源时才值得采用,不能把它当作默认省内存方案。
上线前应使用同一批过滤条件、相同返回列和相近缓存状态,对 JOIN 方案与 Dictionary 方案分别测量查询耗时、CPU、峰值内存和并发稳定性。若维度很小且 JOIN 已被充分优化,收益可能有限;若高频查询反复按键补充少量属性,Dictionary 才更容易把查询成本从“构建并执行连接”收敛到“按键读取属性”。
最终设计应同时满足三件事:键到属性是单值关系,字典能在可接受内存内加载或稳定缓存,刷新窗口符合业务一致性要求。只有这三个条件同时成立,Dictionary 才是查询优化而不是把 JOIN 成本转移成新的运维成本。