
AI 与工程数学 / 系统课时
用链式法则求复合函数梯度
用链式法则求复合函数梯度
神经网络的输出通常由线性变换和非线性激活连续组成,不能只对最后一层求导。本篇以一个包含两个输入、一个神经元和平方损失的模型为例,拆开计算路径,推导每个参数的梯度,并用 Python 核对结果。
学习目标
- 理解复合函数求导时局部导数相乘的原因。
- 推导线性层、Sigmoid 激活和平方损失组成的完整梯度。
- 使用数值差分验证解析梯度,识别漏乘导数等常见错误。
从单变量链式法则开始
假设 ,先计算中间变量 ,再计算 。当 改变一个很小的量时, 的变化由 决定,而 对 的敏感程度由 决定。因此:
例如 。设 ,则 、,所以:
当 时,,梯度为 。直接展开 再求导,也得到 ,两条路径一致。
如果计算包含三个连续操作 ,就将三个局部导数依次相乘:
这里的 通常表示损失函数。反向传播就是沿着计算依赖关系,从损失开始逐层计算这种乘积。
拆解线性层与激活函数
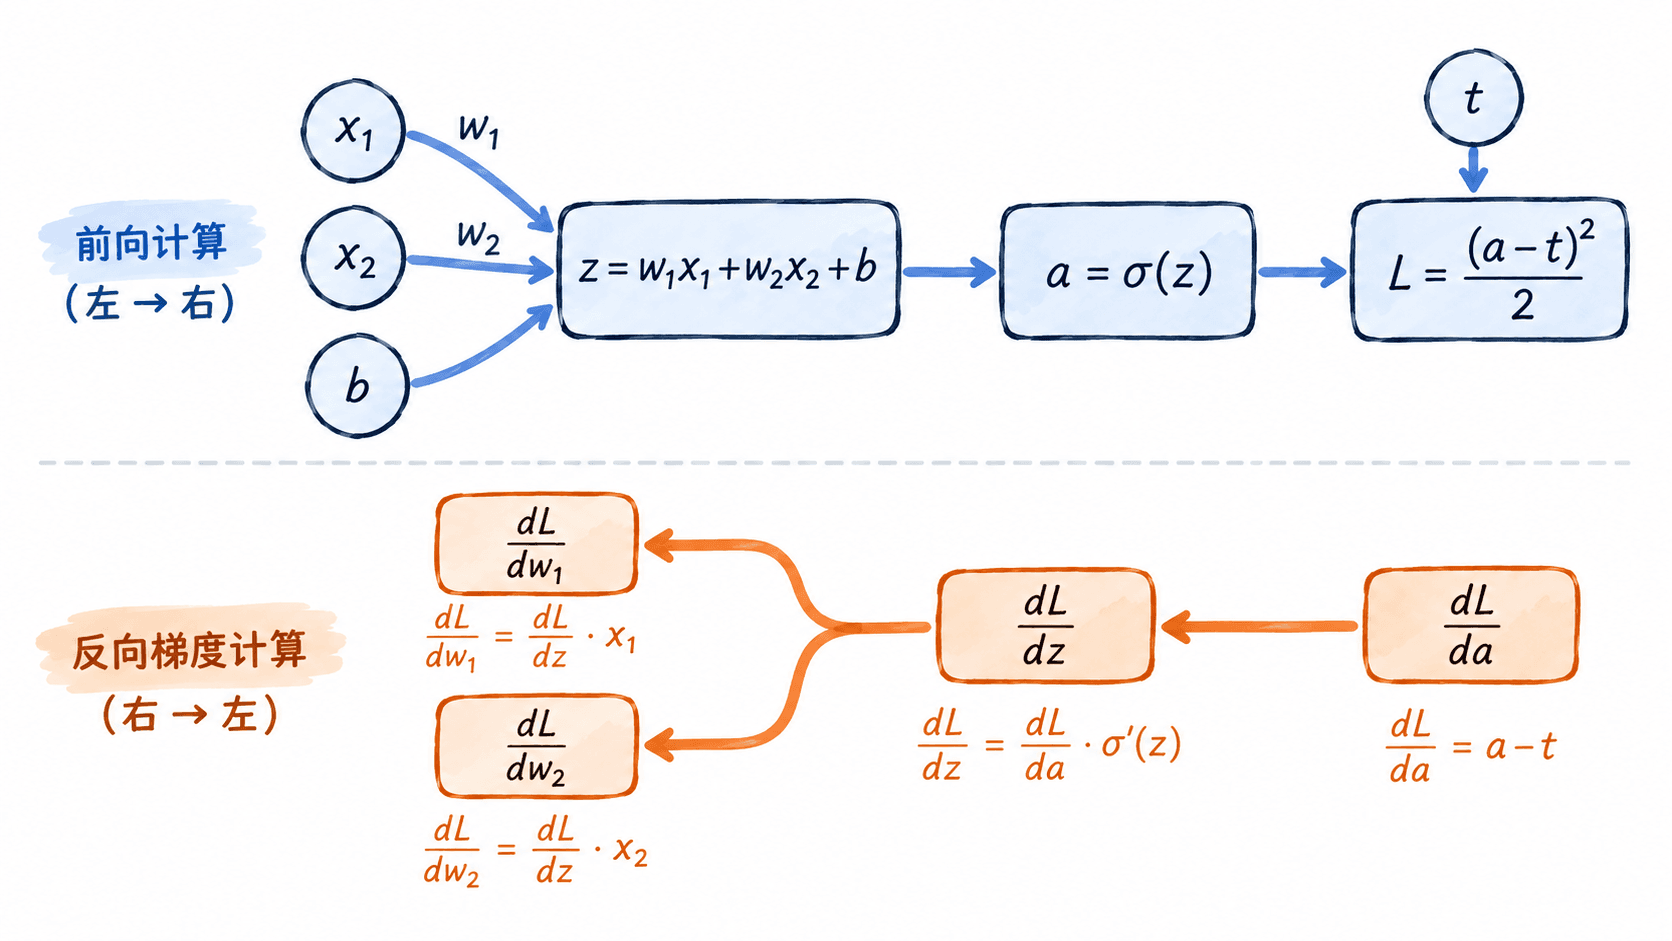
考虑只有一个神经元的模型,输入为 ,可训练参数为 :
其中 是线性层输出, 是 Sigmoid 激活值, 是目标值。系数 用来抵消平方求导产生的系数 。
取一组具体参数:
| 变量 | 数值 |
|---|---|
前向计算得到 ,因此 、。
注意,前向传播先算 、再算 、最后算 ;求梯度时则从 向参数反向计算。反向计算复用前向保存的 、 和输入,不需要重新展开整个函数。
逐层推导每个参数的梯度
先计算损失对激活输出的导数:
Sigmoid 的导数可以直接由其输出表示:
将两段相乘,得到损失对线性输出的梯度:
这里使用 表示线性层输出的梯度,方便继续向输入和参数传播。因为 ,所以:
如果还要向更早的网络层传播,对输入的梯度则为:
代入前面的数值,,,因此 。结果如下:
| 求导对象 | 计算过程 | 梯度 |
|---|---|---|
这里偏导数的含义是:计算某个变量的梯度时,暂时固定其余独立变量。例如求 的梯度时,、、、 都视为常量。
用 Python 核对解析梯度
解析求导容易在乘积中漏掉激活函数的导数。可以利用中心差分:分别将某个参数增加和减少一个很小的量,比较损失的变化率。
下列程序使用 Python 3 标准库,不依赖 NumPy。数值差分中的 ,适合本例双精度浮点计算。
import math

x1, x2, target = 1.0, 2.0, 1.0
w1, w2, bias = 0.2, -0.1, 0.0


def forward(p1, p2, b):
    z = p1 * x1 + p2 * x2 + b
    a = 1.0 / (1.0 + math.exp(-z))
    return a, 0.5 * (a - target) ** 2


# 解析梯度:沿损失、激活、线性层的顺序反向求导
a, loss = forward(w1, w2, bias)
delta = (a - target) * a * (1.0 - a)
analytic = [delta * x1, delta * x2, delta]

# 中心差分:只扰动当前待检查的参数
params = [w1, w2, bias]
h = 1e-5
for i, name in enumerate(("w1", "w2", "bias")):
    plus = params.copy()
    minus = params.copy()
    plus[i] += h
    minus[i] -= h
    numeric = (forward(*plus)[1] - forward(*minus)[1]) / (2 * h)
    error = abs(analytic[i] - numeric)
    print(f"{name}: analytic={analytic[i]:.6f}, "
          f"numeric={numeric:.6f}, error={error:.2e}")
预期输出(最后一列可能因浮点计算环境出现微小差异):
w1: analytic=-0.125000, numeric=-0.125000, error=<约1e-12>
w2: analytic=-0.250000, numeric=-0.250000, error=<约1e-11>
bias: analytic=-0.125000, numeric=-0.125000, error=<约1e-12>
最后一列的尖括号表示近似量级,并非程序实际打印的字面内容;运行时会显示具体科学计数法数值。验证时应以误差是否小于 为判断标准,而不是要求最后几位完全一致。
识别常见的求导错误
第一种错误是遗漏 Sigmoid 的导数,直接写成 。在本例中会得到 ,而正确结果是 ,相差四倍。
第二种错误是把参数梯度和输入梯度混淆。求 的导数要乘 ,求 的导数才乘 。在线性层中可以记为:参数梯度使用输入值,输入梯度使用权重值。
第三种错误是把多个路径的梯度直接相乘。当某个变量同时影响两个下游节点时,应该先计算每条路径贡献,再相加。例如 ,则 ,不是 。
还要注意数值差分的局限: 太大时截断误差明显,太小时浮点舍入误差增大。实际调试中可分别试 、 和 ,观察误差是否保持很小。
掌握这一推导后,面对更长的网络,只需为每个运算写出局部导数,并按计算图从损失向前传播;串行路径相乘,分支汇合处相加,就可以逐层得到参数梯度。