
AI 与工程数学 / 系统课时
在同一任务上比较优化器收敛
在同一任务上比较优化器收敛
SGD、Momentum 和 Adam 都能训练神经网络,但损失下降速度、震荡程度和最终结果可能不同。本篇使用同一份合成回归数据、相同模型初始化和固定训练预算,完成一次可复现的对照实验,绘制三条损失曲线,并判断观察到的差异是否真正来自优化器。
学习目标
- 固定数据、随机种子、模型初始参数和训练步数,设计公平的优化器对照实验。
- 使用 PyTorch 运行 SGD、Momentum 和 Adam,记录并绘制损失曲线。
- 区分收敛速度、最终损失、震荡与泛化表现,识别比较中的常见偏差。
明确比较对象与公平条件
实验使用二维线性回归任务。输入包含两个数值特征,目标值由线性关系和少量高斯噪声生成。模型为单层 nn.Linear(2, 1),损失函数为均方误差 MSELoss。
三种优化设置分别为:
| 优化器 | 学习率 | 其他参数 |
|---|---|---|
| SGD | 0.05 | momentum=0 |
| Momentum | 0.05 | momentum=0.9 |
| Adam | 0.05 | betas=(0.9, 0.999),eps=1e-8 |
这里的 Momentum 指 PyTorch 的 torch.optim.SGD 开启动量后的形式,而不是独立的优化器类。SGD 使用当前梯度更新参数;Momentum 累积历史更新方向;Adam 根据梯度的一阶矩和二阶矩估计调整更新幅度。
为了保证实验可比,固定以下条件:
- 数据:512 条训练样本、128 条验证样本,三组共享完全相同的张量。
- 初始模型:先保存一次初始化权重,再分别加载到三个新模型。
- 训练预算:每组执行 200 次参数更新,均使用全量训练数据。
- 评估方式:每一步更新后记录训练损失和验证损失,损失定义保持一致。
- 随机性:固定随机种子,暂不引入随机批次顺序、数据增强或学习率调度。
相同学习率数值并不意味着三种算法具有相同的有效更新尺度。因此,本实验首先比较指定配置在固定预算下的行为,而不是证明某种优化器在充分调参后必然更优。
实现可复现的对照实验
环境建议使用 Python 3.10 或以上版本,以及支持对应 Python 版本的 PyTorch、NumPy 和 Matplotlib。安装后可运行下面的完整脚本,脚本不需要下载外部数据集。
python -m pip install torch numpy matplotlib预期结果:命令正常结束,依赖可以导入。实际安装版本和下载日志取决于操作系统与 Python 环境。
将主程序保存为 compare_optimizers.py:
import copy
import random

import matplotlib.pyplot as plt
import numpy as np
import torch
from torch import nn

SEED = 42
STEPS = 200
LR = 0.05

random.seed(SEED)
np.random.seed(SEED)
torch.manual_seed(SEED)

# 固定数据,所有优化器共享同一训练集和验证集。
x = torch.randn(640, 2)
noise = 0.1 * torch.randn(640, 1)
y = 3.0 * x[:, :1] - 2.0 * x[:, 1:2] + 0.5 + noise
x_train, x_val = x[:512], x[512:]
y_train, y_val = y[:512], y[512:]

initial_model = nn.Linear(2, 1)
initial_state = copy.deepcopy(initial_model.state_dict())
loss_fn = nn.MSELoss()

optimizer_factories = {
    "SGD": lambda params: torch.optim.SGD(params, lr=LR),
    "Momentum": lambda params: torch.optim.SGD(
        params, lr=LR, momentum=0.9
    ),
    "Adam": lambda params: torch.optim.Adam(params, lr=LR),
}

history = {}

for name, make_optimizer in optimizer_factories.items():
    model = nn.Linear(2, 1)
    model.load_state_dict(initial_state)
    optimizer = make_optimizer(model.parameters())
    train_losses, val_losses = [], []

    for step in range(STEPS):
        model.train()
        optimizer.zero_grad()
        loss = loss_fn(model(x_train), y_train)
        loss.backward()
        optimizer.step()

        # 更新后统一评估,避免记录不同时间点的损失。
        model.eval()
        with torch.no_grad():
            train_loss = loss_fn(model(x_train), y_train).item()
            val_loss = loss_fn(model(x_val), y_val).item()
        train_losses.append(train_loss)
        val_losses.append(val_loss)

    history[name] = (train_losses, val_losses)
    print(
        f"{name}: train={train_losses[-1]:.4f}, "
        f"val={val_losses[-1]:.4f}"
    )

# 左右分图,同时检查优化速度和泛化表现。
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
for name, (train_losses, val_losses) in history.items():
    axes[0].plot(range(1, STEPS + 1), train_losses, label=name)
    axes[1].plot(range(1, STEPS + 1), val_losses, label=name)

for ax, title in zip(axes, ["Training loss", "Validation loss"]):
    ax.set_title(title)
    ax.set_xlabel("Optimizer steps")
    ax.set_ylabel("MSE")
    ax.set_yscale("log")
    ax.grid(True, alpha=0.3)
    ax.legend()

fig.tight_layout()
fig.savefig("optimizer_comparison.png", dpi=160)
plt.close(fig)
执行命令:
python compare_optimizers.py预期结果:控制台依次输出 SGD、Momentum、Adam 各自的最终训练和验证 MSE,并生成 optimizer_comparison.png。每行格式如下,具体数值应以本机执行结果为准:
SGD: train=<训练MSE>, val=<验证MSE>
Momentum: train=<训练MSE>, val=<验证MSE>
Adam: train=<训练MSE>, val=<验证MSE>
上面的尖括号表示待观察数值,不是程序实际打印的字符。正常收敛时,训练和验证损失通常会显著低于初始损失;由于目标包含随机噪声,最终 MSE 不应被要求恰好为零。
阅读损失曲线并解释差异
绘制出的图有左右两个面板:左侧训练损失,右侧验证损失;横轴为更新步数,纵轴为对数刻度的 MSE。对数坐标有助于同时观察早期快速下降和后期微小变化。
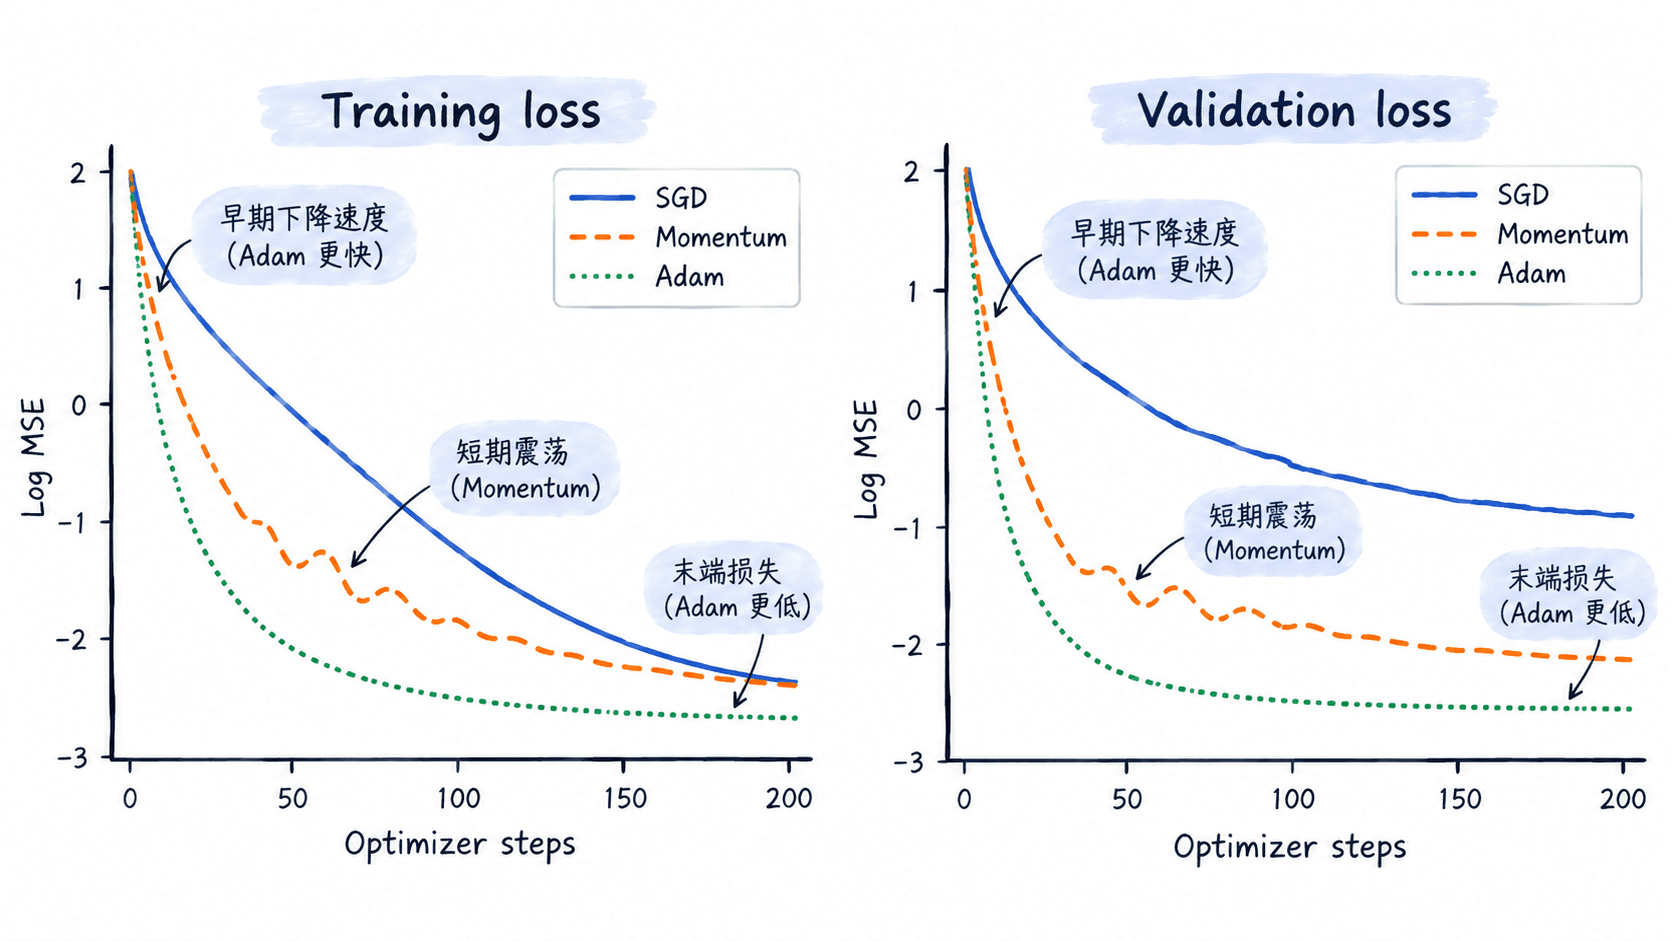
解释曲线时需要分开看三个指标:
| 观察指标 | 判断方法 | 可能的含义 |
|---|---|---|
| 早期收敛速度 | 对比第 10、20、50 步的 MSE | 更快降低当前任务的损失 |
| 震荡程度 | 检查连续若干步是否反复升降 | 步长偏大或动量导致越过低损失区域 |
| 最终损失 | 比较第 200 步训练及验证 MSE | 固定预算下的优化结果与泛化表现 |
SGD 在本任务中通常沿梯度方向逐步接近最小值。Momentum 利用历史更新方向,可能在前期加速,但接近最优点时也可能越过最优区域并短暂反弹。Adam 会按参数维度自适应缩放更新,在部分问题上初期进展明显,但不保证始终比 Momentum 快。
特别注意:本实验是低维凸二次优化问题,不代表深层神经网络上的通用排名。不同的特征尺度、损失曲率、批量大小和学习率,都会改变三条曲线的相对位置。
增加可量化的收敛判断
只看最终损失容易忽略训练预算。可以设定统一阈值,例如训练 MSE 首次低于 0.02 所需的更新次数。此阈值仅适用于当前噪声尺度和损失定义,不能跨任务直接比较。
将下面的片段示例添加在主程序保存图片之前;它依赖前面代码中的 history:
THRESHOLD = 0.02

for name, (train_losses, val_losses) in history.items():
    reached = next(
        (i for i, value in enumerate(train_losses, start=1)
         if value < THRESHOLD),
        None,
    )
    print(f"{name}: first_below={reached}, best_val={min(val_losses):.4f}")
预期结果:三行分别报告首次达到阈值的更新步数,以及 200 步内最低的验证 MSE:
SGD: first_below=<步数或None>, best_val=<最低验证MSE>
Momentum: first_below=<步数或None>, best_val=<最低验证MSE>
Adam: first_below=<步数或None>, best_val=<最低验证MSE>程序实际输出为整数、None 或四位小数,上面的占位说明数值格式。None 表示该优化器在 200 步内从未达到严格小于阈值的条件,并不意味着训练失败。
还需要区分两个比较目标:固定步数衡量的是参数更新效率,固定实际时间衡量的是计算资源使用效率。Adam 每步通常需要额外维护一阶和二阶矩状态,因此不能仅凭更新次数得出运行速度更快的结论。正式性能实验应同时记录墙钟时间,并在相同设备上预热和重复测量。
修正实验中的常见不公平做法
最容易犯的错误是依次创建三个随机初始化的模型。即使使用相同随机种子,如果没有恢复同一份初始参数,不同起点也会干扰比较。脚本中的 initial_state 就是为了解决这一问题。
第二个错误是只比较相同学习率。0.05 对 SGD 可能合适,对 Adam 却可能偏大。要比较经过调参后的算法能力,可以给每个优化器独立搜索学习率,例如 SGD 和 Momentum 尝试 0.001、0.01、0.05、0.1,Adam 尝试 0.0003、0.001、0.01、0.05。所有候选都使用相同的验证集、训练预算和搜索规则,再根据验证损失选择配置。测试集只用于最终一次评估,不能参与选参。
第三个错误是把单次结果当作稳定规律。实际神经网络实验建议至少测试 3~5 个随机种子,报告均值和标准差。随机种子必须成组配对:每个种子下,各优化器使用相同的数据划分和初始化,而不同种子之间允许数据及初始参数变化。
可以做两项检查:先把训练步数从 200 改成 20,观察哪一种优化器在短预算内下降更快;再分别调整三组学习率,检验原来的排名是否改变。如果学习率改变后排名逆转,就应把结论限定为特定超参数配置,而不是宣称某个优化器天然更好。
对于这次实验,合理的结论应同时说明任务、初始化控制方式、优化器参数、更新预算、达到阈值的步数以及最终验证损失。这样得到的比较才具备可复现性,也能为后续神经网络训练选择优化器提供依据。