
AI 与工程数学 / 系统课时
用网格搜索定位损失最低点
用网格搜索定位损失最低点
训练一个简单线性模型时,我们可以先不使用梯度下降,而是枚举一组候选参数,计算每组参数的损失,再选出损失最小的一组。本篇使用 Python 和 NumPy 实现一维参数网格搜索,绘制损失曲线,验证搜索结果,并分析搜索精度与计算成本之间的关系。
学习目标
- 使用均方误差构造线性模型的损失函数,并计算候选参数的损失。
- 使用 NumPy 扫描参数网格,通过 Matplotlib 绘制损失曲线并定位最低点。
- 通过调整搜索范围和步长,理解网格搜索的精度、边界风险与计算开销。
将模型训练转化为参数搜索
假设模型只有一个待训练参数 ,预测公式为:
给定三个训练样本:
| 样本 | 输入 | 真实值 |
|---|---|---|
| A | 1 | 2 |
| B | 2 | 4 |
| C | 3 | 6 |
使用均方误差(MSE)衡量预测误差:
代入数据后,可以化简为:
这说明当前实验的理论最优参数是 ,对应损失 。实际使用网格搜索时,即使不知道这个答案,也能通过逐个计算候选参数的损失来寻找最低点。
例如,选择四个候选值:
| 参数 | 损失 |
|---|---|
| 0 | 18.6667 |
| 1 | 4.6667 |
| 2 | 0.0000 |
| 3 | 4.6667 |
网格搜索的规则非常直接:预先确定候选参数集合,计算每一个候选点的损失,再返回损失最小的参数。这里的网格是离散的参数取值集合,不代表模型参数本身只能取这些值。
使用 Python 扫描候选参数
实验使用 Python 3.10 或更新版本,以及 NumPy、Matplotlib。先在终端安装依赖:
python -m pip install numpy matplotlib预期结果:命令成功完成且没有安装错误;已安装依赖时可能显示 Requirement already satisfied。不同环境的版本号和安装路径会不同。
创建 grid_search.py,输入以下完整代码:
import numpy as np
import matplotlib.pyplot as plt

# 三个训练样本,模型不包含偏置项
x = np.array([1.0, 2.0, 3.0])
y = np.array([2.0, 4.0, 6.0])


def mse(w):
    # 每个候选参数都在全部样本上计算平均平方误差
    predictions = w * x
    return float(np.mean((predictions - y) ** 2))


# 在闭区间 [0, 4] 内等距生成 9 个候选参数
weights = np.linspace(0.0, 4.0, 9)
losses = np.array([mse(w) for w in weights])

# argmin 返回最小损失所在的数组下标
best_index = int(np.argmin(losses))
best_weight = weights[best_index]
best_loss = losses[best_index]

for w, loss in zip(weights, losses):
    print(f"w={w:.1f}, loss={loss:.4f}")

print(f"best_w={best_weight:.1f}")
print(f"best_loss={best_loss:.4f}")

plt.plot(weights, losses, marker="o", label="Grid loss")
plt.scatter([best_weight], [best_loss], color="red", zorder=3,
            label="Best grid point")
plt.xlabel("Weight w")
plt.ylabel("Mean squared error")
plt.title("Grid Search for Linear Model")
plt.grid(True)
plt.legend()
plt.tight_layout()
plt.savefig("grid_search.png", dpi=150)
plt.close()
在脚本所在目录执行:
python grid_search.py预期输出:
w=0.0, loss=18.6667
w=0.5, loss=10.5000
w=1.0, loss=4.6667
w=1.5, loss=1.1667
w=2.0, loss=0.0000
w=2.5, loss=1.1667
w=3.0, loss=4.6667
w=3.5, loss=10.5000
w=4.0, loss=18.6667
best_w=2.0
best_loss=0.0000
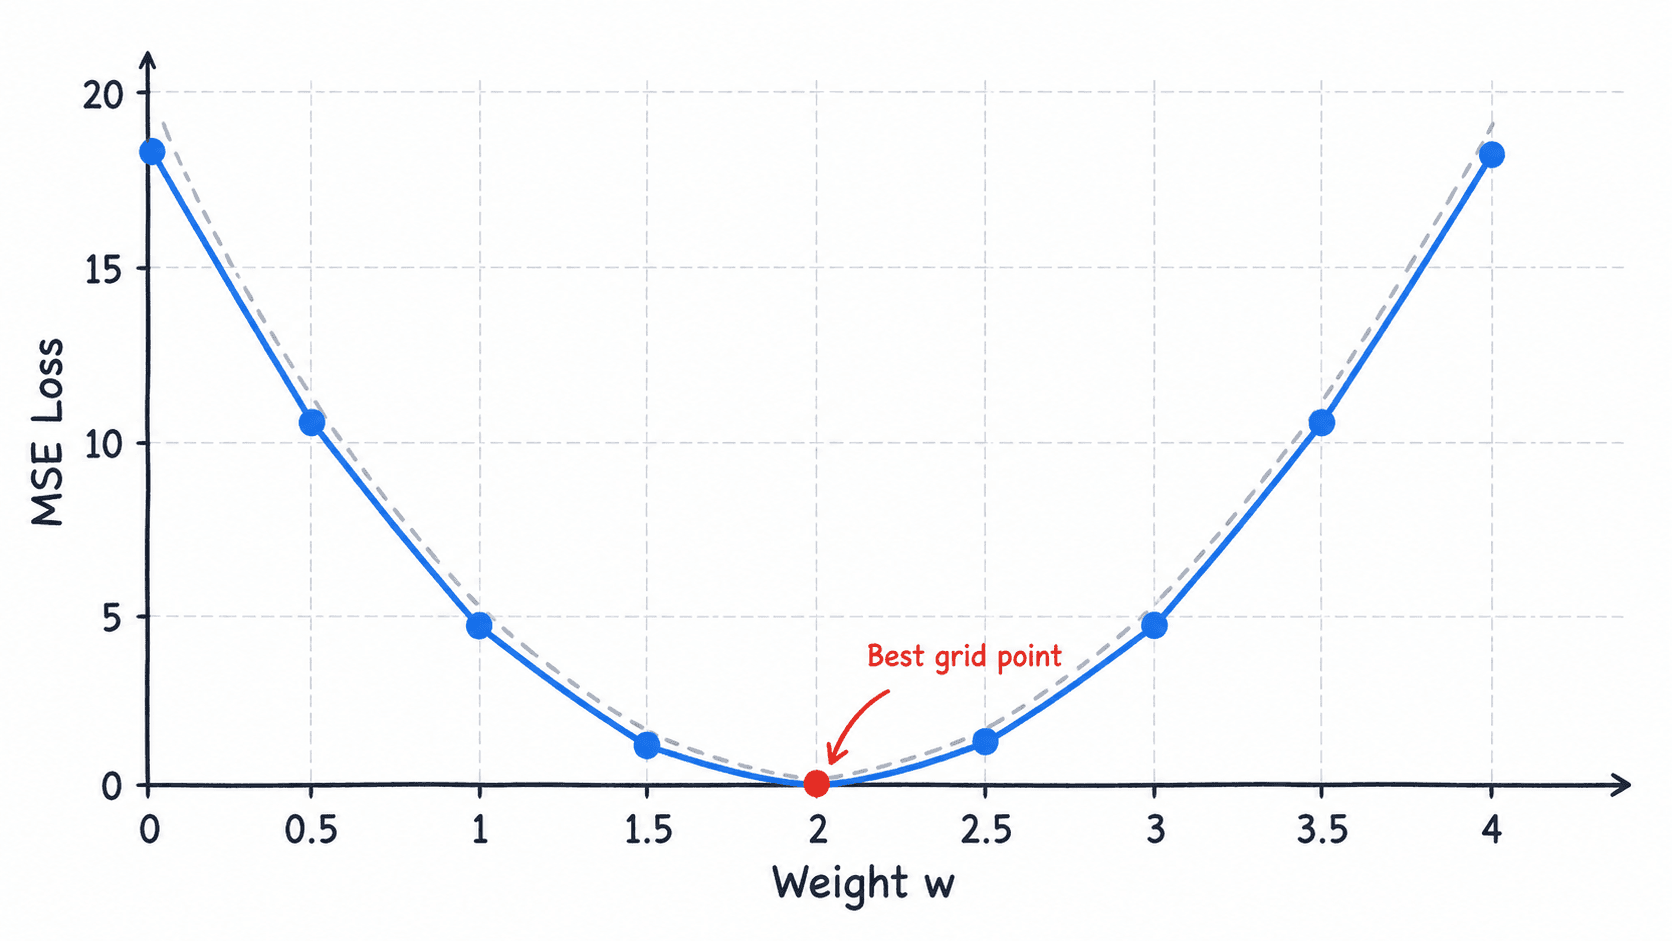
运行成功后,当前目录还会生成 grid_search.png。横轴表示候选参数,纵轴表示均方误差。九个采样点连接成一条向上开口的折线,最低点在 ,红色标记突出显示了找到的最佳候选值。
改变网格密度观察搜索误差
刚才恰好扫描到了真实最优参数 。如果最优点不在网格上,结果会发生什么?
将搜索范围改为 ,使用不同数量的等距候选点。以下比较的是同一个损失函数,不改变训练数据。
| 候选点数量 | 网格间距 | 找到的 | 最小损失约为 |
|---|---|---|---|
| 3 | 1.90 | 1.90 | 0.046667 |
| 5 | 0.95 | 1.90 | 0.046667 |
| 20 | 0.20 | 2.00 | 0.000000 |
| 39 | 0.10 | 2.00 | 0.000000 |
前两组虽然候选点数量不同,但都没有包含 ,因此只能返回 。后两组包含最优点,损失下降到零。
对于等距一维网格,如果真正的最优参数位于搜索区间内,且距离最近网格点的误差按参数距离衡量,则最近网格点与最优参数的距离至多为半个网格间距。对于本例这种凸二次损失,网格搜索选出的点就是距离 最近的候选点。
不过,增加采样点并不保证每次都严格改善结果:新网格未必包含旧网格的最优候选点。缩小步长通常能提高逼近能力,但是否改善仍取决于采样位置。
理解搜索范围与计算成本
网格搜索不依赖梯度,但计算次数与候选参数组合数量直接相关。对于每个维度都使用 个候选值、总共 个独立参数的情况,完整笛卡尔积网格需要评估:
假设每次损失计算需要 2 毫秒:
| 参数维度 | 每维候选数 | 总评估次数 | 理论计算时间 |
|---|---|---|---|
| 1 | 100 | 100 | 0.2 秒 |
| 2 | 100 | 10000 | 20 秒 |
| 3 | 100 | 1000000 | 约 33.3 分钟 |
| 5 | 100 | 10000000000 | 约 231.5 天 |
这里假设串行执行,每次评估成本固定,不计调度、数据加载和其他开销。实际模型训练的单次损失计算时间也可能随样本量变化。
搜索范围还会影响结果。例如把本例网格设置为 ,无论将步长缩小到多细,都找不到真正的最优参数 。搜索结果会停在右侧边界 ,损失仍为约 4.6667。
因此需要同时检查两个条件:搜索范围是否覆盖合理参数值,以及网格密度是否足以达到目标精度。仅增加候选点数量并不能修复错误的范围。
验证搜索结果并选择合适方法
完成实验后,可以按下面的顺序检查:
- 查看终端输出,确认最低损失为 0,最佳参数为 2.0。
- 打开
grid_search.png,确认曲线最低点与终端输出一致。 - 将
np.linspace(0.0, 4.0, 9)改为np.linspace(0.0, 1.0, 11),重新运行,验证最低损失约为 4.6667。 - 恢复原范围,再将采样点数量改为 8,观察离散候选点没有恰好落在最优参数时的结果。
特别注意区分训练损失和泛化能力。本例使用训练数据计算 MSE,只能证明候选参数在这三个样本上的拟合误差;实际模型还需要使用独立验证数据评价表现,不能直接把训练损失最低理解为泛化效果最好。
网格搜索适合参数维度少、范围明确、单次损失计算便宜的实验,也常用于为更复杂的优化方法建立基准。当参数维度较高或模型需要反复训练时,完整网格的组合数量会迅速膨胀,可以考虑随机搜索、贝叶斯优化,或者在可微目标上使用梯度下降等方法。
通过这个实验,可以直观看到优化问题的基本形式:定义损失函数,产生候选参数,评估并比较损失,最终返回当前搜索集合中的最优解。网格搜索给出的只是所扫描候选集合内的最优值,并不自动保证连续参数空间中的全局最优值。