
AI 与工程数学 / 系统课时
用 PyTorch 训练二分类模型
用 PyTorch 训练二分类模型
本课使用 PyTorch 从零训练一个逻辑回归二分类模型,让模型根据两个数值特征预测样本属于正类的概率。你将完成数据准备、损失计算、反向传播和参数更新,并通过损失变化、准确率及测试样本验证训练是否真正生效。
学习目标
- 使用
nn.Linear和BCEWithLogitsLoss构建二分类训练任务。 - 理解
zero_grad()、backward()、step()的作用与执行顺序。 - 通过参数变化、损失曲线和分类指标检查训练结果。
明确任务与训练数据
假设需要根据两个数值特征判断一个样本是否属于正类。为了聚焦优化过程,使用人工构造的二维数据:当两个特征之和大于零时标记为 1,否则标记为 0。这是一个线性可分的二分类问题,适合用逻辑回归验证梯度下降。
模型学习的形式为:
其中 、 为权重, 为偏置。通过 Sigmoid 函数把 转换为正类概率:
当 时预测为正类,否则预测为负类。训练时不需要手动实现 Sigmoid,而是直接把模型输出的原始分数 logits 交给 BCEWithLogitsLoss,它在内部以数值更稳定的方式完成相应计算。
本例采用如下设置:
| 项目 | 设置 | 作用 |
|---|---|---|
| 输入维度 | 2 | 每个样本包含两个特征 |
| 输出维度 | 1 | 每个样本输出一个 logit |
| 样本数量 | 1000 | 固定随机种子生成 |
| 训练集与测试集 | 800 / 200 | 分开训练与评估 |
| 优化器 | SGD | 使用梯度下降更新参数 |
| 学习率 | 0.1 | 控制每次参数更新幅度 |
| 训练轮数 | 200 | 遍历训练集 200 次 |
编写完整训练程序
准备 Python 3.10 或更新版本,以及可用的 PyTorch 环境。没有安装 PyTorch 时,应按操作系统和计算设备选择官方安装命令;本例只使用 CPU,不依赖 CUDA。
将下面代码保存为 train_binary.py。代码适用于 PyTorch 2.x,包含固定随机种子、数据拆分、完整训练循环和测试评估。
import torch
from torch import nn

# 固定随机状态,方便重复实验
torch.manual_seed(42)

# 构造线性可分数据;训练集与测试集不重叠
x = torch.randn(1000, 2)
y = ((x[:, 0] + x[:, 1]) > 0).float().unsqueeze(1)
indices = torch.randperm(1000)
train_idx, test_idx = indices[:800], indices[800:]
x_train, y_train = x[train_idx], y[train_idx]
x_test, y_test = x[test_idx], y[test_idx]

model = nn.Linear(2, 1)
criterion = nn.BCEWithLogitsLoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

initial_weight = model.weight.detach().clone()

for epoch in range(1, 201):
    model.train()
    optimizer.zero_grad()  # 清除上一轮累积的梯度
    logits = model(x_train)
    loss = criterion(logits, y_train)
    loss.backward()  # 计算参数梯度
    optimizer.step()  # 根据梯度更新权重和偏置

    if epoch in (1, 50, 100, 200):
        print(f"epoch={epoch}, loss={loss.item():.4f}")

# 评估阶段关闭梯度记录,避免额外计算
model.eval()
with torch.no_grad():
    test_logits = model(x_test)
    probabilities = torch.sigmoid(test_logits)
    predictions = (probabilities >= 0.5).float()
    accuracy = (predictions == y_test).float().mean().item()
    weight_change = (model.weight - initial_weight).abs().max().item()

print(f"weight_changed={weight_change > 0}")
print(f"test_accuracy={accuracy:.4f}")
print(f"sample_probability={probabilities[0].item():.4f}")
print(f"sample_prediction={int(predictions[0].item())}")
执行命令:
python train_binary.py预期结果:控制台会输出第 1、50、100、200 轮的损失,以及权重变化和测试指标。正常运行时应看到类似趋势,具体浮点数以实际运行结果为准:
epoch=1, loss=<初始损失>
epoch=50, loss=<更低的损失>
epoch=100, loss=<继续下降的损失>
epoch=200, loss=<最终损失>
weight_changed=True
test_accuracy=<测试集准确率>
sample_probability=<0到1之间的概率>
sample_prediction=<0或1>
上面尖括号内容表示结果格式,不是程序实际打印的字面值。固定种子有助于复现,但 PyTorch 版本和计算环境差异仍可能带来细微数值变化。对这组线性可分数据,通常可以获得较高的测试准确率,不应把某个精确数值作为唯一验收标准。
理解每轮参数如何更新
每轮训练必须按照清除梯度、前向传播、计算损失、反向传播和更新参数的顺序执行。loss.backward() 只负责计算梯度,不会自动修改参数;真正更新参数的是 optimizer.step()。
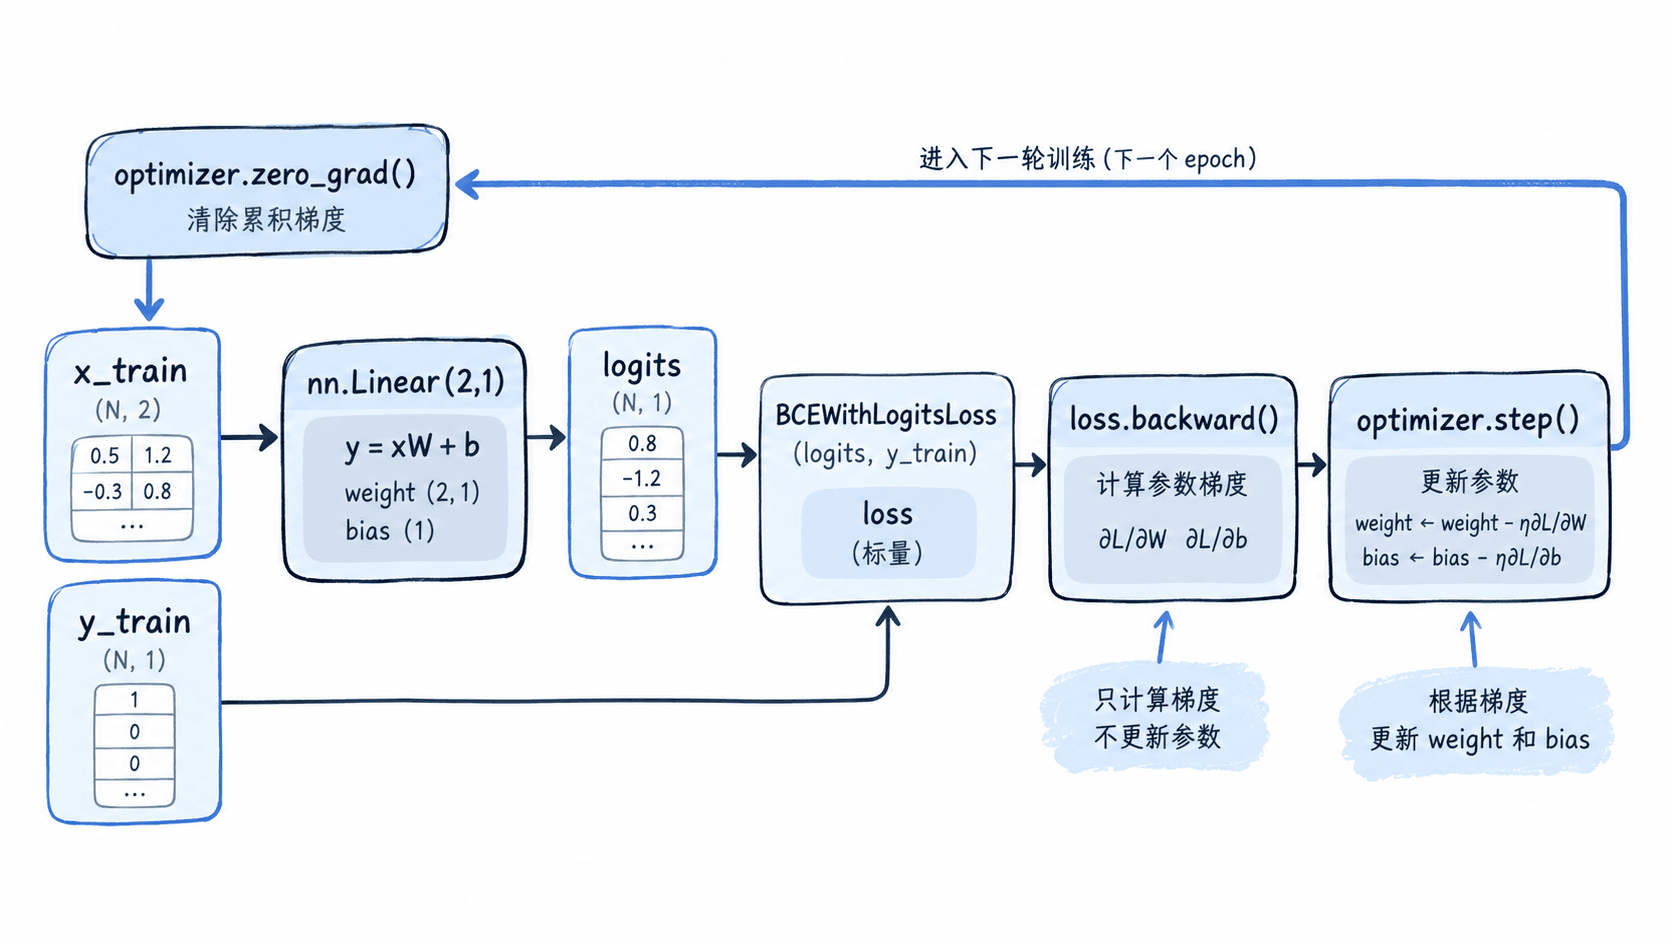
对于普通 SGD,单个参数的更新关系为:
其中 是学习率。假设某次更新前权重为 0.5,梯度为 0.8,学习率为 0.1,则更新后权重为 。负梯度方向通常对应局部损失下降方向,但实际损失是否下降,还受学习率和目标函数影响。
本例采用全批量训练,每轮使用全部 800 条训练样本。若以后改用小批量训练,应把清除梯度、前向传播、反向传播和参数更新放到每个批次内部,而不是只在整个 epoch 结束时更新一次。
验证分类效果与训练状态
验证训练不能只看最后一次损失。至少需要检查三个互相独立的信号:
| 检查项 | 正常现象 | 异常时优先检查 |
|---|---|---|
| 训练损失 | 整体下降 | 标签、学习率、梯度更新 |
| 权重变化 | weight_changed=True |
是否调用 backward() 和 step() |
| 测试准确率 | 显著高于随机基线 50% | 数据划分、阈值、模型表达能力 |
准确率的定义为:
例如 200 条测试样本中有 194 条预测正确,准确率就是 97%。但准确率较高并不自动说明模型适用于所有数据。如果正类占比达到 95%,始终预测正类也能获得 95% 的准确率,因此真实项目还需要检查混淆矩阵、精确率和召回率。
model.eval() 将模型切换到评估模式;torch.no_grad() 则关闭该代码块内的自动求导记录。这两者作用不同。本例的线性层没有 Dropout 或 BatchNorm,切换评估模式不会改变其前向计算结果,但保留这些操作是正确的评估习惯。
排查训练不收敛与维度错误
最常见的错误是标签与模型输出形状不匹配。本例 nn.Linear(2,1) 对 800 条样本输出 [800, 1],因此通过 unsqueeze(1) 把标签也变为 [800, 1]。标签还必须是浮点类型且取值在 0 到 1 之间;不要直接把整数类别标签以不匹配的形状传入损失函数。
另外几种问题可以按下面的方法定位:
- 损失基本不变:检查是否漏掉
loss.backward()或optimizer.step();先确认权重确实变化,再检查学习率与数据。 - 损失震荡甚至上升:把
lr=0.1改为lr=0.01重新运行,比较相同轮数下的变化,不要直接断定模型结构有问题。 - 梯度意外累积:确认每次反向传播前执行
optimizer.zero_grad();默认的梯度累积行为可能导致更新幅度偏离预期。 - 概率使用错误:
BCEWithLogitsLoss接收未经 Sigmoid 的 logits;只在推理或指标计算时调用torch.sigmoid(),否则会重复应用 Sigmoid。 - 训练准确率高、测试效果差:确认测试集未参与参数更新,并检查训练集与实际业务数据的分布差异。
可以做一个对照实验:分别使用学习率 0.1 和 0.01 训练 200 轮,记录第 1、50、100、200 轮损失和测试准确率。由于学习率改变了每步更新幅度,两组模型在固定训练轮数下可能得到不同结果。判断哪组更好时,应优先比较独立验证集上的表现,而不是只挑训练损失最低的一组。
当损失总体下降、参数发生变化、测试准确率明显优于基线,而且预测概率处于合法范围时,这条 PyTorch 二分类训练链路就通过了基本验收。