
AI 与工程数学 / 系统课时
L1 与 L2 正则怎样改变参数解
L1 与 L2 正则怎样改变参数解
同一组回归数据即使训练误差接近,也可能得到幅度很大的系数或大量微小但非零的系数。L1 和 L2 都通过在损失中惩罚参数来限制解,但前者更容易把系数压到 0,后者通常让所有系数平滑缩小。
学习目标
- 写出带 L1、L2 正则的回归目标,并理解正则强度 的作用。
- 用一个可计算案例比较两种正则对参数幅度和稀疏性的影响。
- 根据特征选择、共线性和预测稳定性判断该优先使用哪种正则。
把惩罚项加入回归损失
以平方误差为基础,设参数向量为 ,样本数为 。L1 正则的目标为:
L2 正则的目标为:
时两者都退化为普通最小二乘。 越大,模型越不愿意使用大系数。例如原始解为 ,第二个参数本来就很小;当 时,L1 有机会直接把它压成 0,而 L2 更常得到两个仍非零但整体更小的参数。
为什么 L1 更容易产生零系数
从二维参数空间看,固定正则预算时,L1 约束 的边界是带尖角的菱形,L2 约束 的边界则是圆形。损失等高线不断向较小区域收缩时,L1 的尖角更容易与等高线首先相切,而尖角恰好位于某个参数为 0 的坐标轴上。
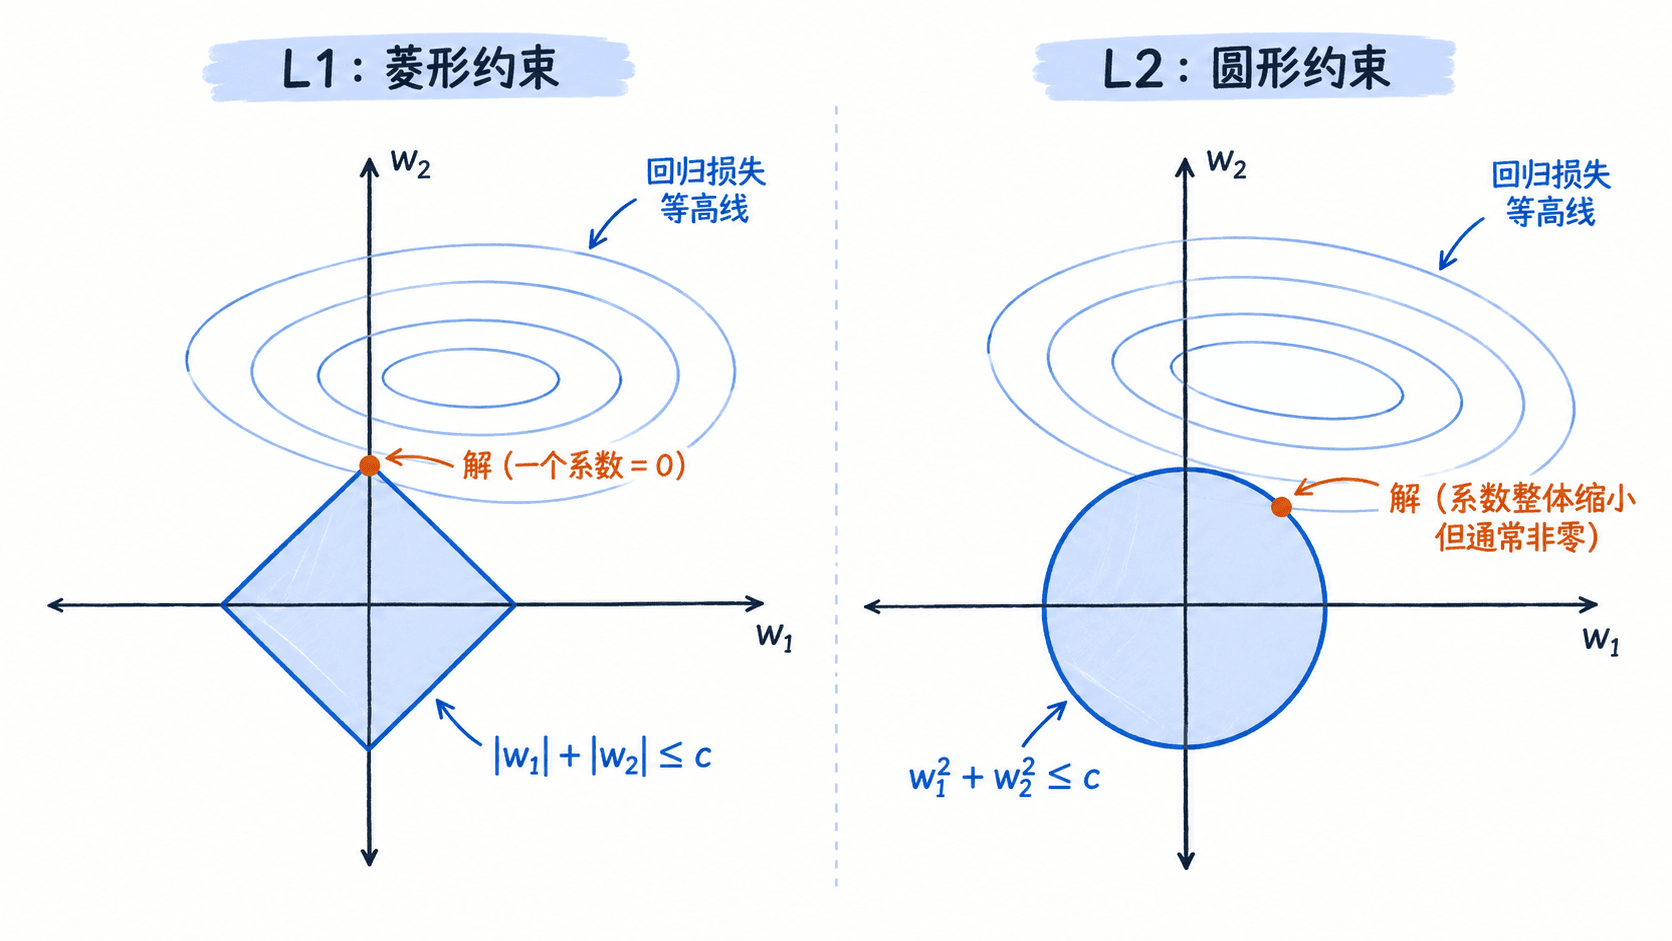
这并不意味着 L1 一定产生零系数。是否归零取决于数据梯度与 的大小;当某个特征提供的误差下降足够大时,它仍会保留非零权重。L2 的梯度则连续地随 增长,因此更像对大参数持续施加回拉力。
用数值实验观察参数变化
下面使用两个互相独立的特征构造一个最小回归例子。无正则时最优参数正好为 。代码使用近端梯度:L1 在普通梯度更新后执行 soft-threshold,L2 则执行对应的二次惩罚更新,因此不依赖机器学习库。
import numpy as np

X = np.eye(2)
y = np.array([2.0, 0.15])


def fit(kind, lam, lr=0.1, steps=1000):
    w = np.zeros(2)
    n = len(y)

    for _ in range(steps):
        # 数据项梯度;这里 X 为单位矩阵,便于直接观察正则效果。
        grad = (2.0 / n) * X.T @ (X @ w - y)
        z = w - lr * grad

        if kind == "l1":
            # L1 的近端算子:小于阈值的系数会直接变为 0。
            threshold = lr * lam
            w = np.sign(z) * np.maximum(np.abs(z) - threshold, 0.0)
        elif kind == "l2":
            w = z / (1.0 + 2.0 * lr * lam)
        else:
            raise ValueError("kind must be 'l1' or 'l2'")

    return w


for lam in (0.0, 0.05, 0.2):
    l1 = fit("l1", lam)
    l2 = fit("l2", lam)
    print(f"lambda={lam:.2f} L1={l1.round(4)} L2={l2.round(4)}")
预期输出:
lambda=0.00 L1=[2.   0.15] L2=[2.   0.15]
lambda=0.05 L1=[1.95 0.1 ] L2=[1.8182 0.1364]
lambda=0.20 L1=[1.8 0. ] L2=[1.4286 0.1071]
当 时,第二个 L1 系数已经归零,而 L2 仍保留约 0.1071。与此同时,L1 的第一个系数从 2 降到 1.8,L2 则降到约 1.4286,说明两种惩罚不仅影响是否稀疏,也会改变参数收缩方式。
在真实模型里怎样选择
如果目标包含特征筛选,例如 5000 个词袋特征中希望只保留少量有贡献的词,L1 通常更符合需求。验收时可以直接统计非零系数比例,例如 5000 个参数最终只有 320 个绝对值大于 ,稀疏率约为 93.6%。
如果大量特征都可能提供弱信号,或者特征之间高度相关,L2 往往更稳定。例如两个几乎重复的特征都预测房价时,L1 可能偏向保留其中一个,而 L2 更倾向把权重分摊给二者。对预测任务,实际选择应以验证集误差而不是训练误差最低为准。
可将候选强度按对数尺度搜索,例如 。每个候选值都只在训练集拟合,在验证集比较 MSE,同时记录参数的最大绝对值和非零数量。若验证 MSE 已开始上升,而系数仍在继续缩小,说明正则已经过强。