
AI 与工程数学 / 系统课时
损失变成 NaN 时排查数值溢出
损失变成 NaN 时排查数值溢出
训练过程中,损失突然从正常数值变成 NaN,通常意味着某一步计算产生了非法数值。本篇通过一个可运行的 PyTorch 示例,定位非法输入、指数溢出和除零问题,改用数值稳定的损失函数,并验证训练能否恢复正常。
学习目标
- 区分 NaN、正负无穷大,定位首次出现异常的计算环节。
- 识别非法输入、指数溢出、除零以及不稳定损失计算。
- 使用 PyTorch 稳定 API 修复问题,并检查损失、梯度和参数是否有限。
从异常现象确定排查范围
NaN 表示 Not a Number,常由 0/0、inf-inf 等非法运算产生。Inf 表示无穷大,可能由浮点溢出或除零产生。两者都可能经过后续计算污染损失、梯度及模型参数。
例如,前 80 次迭代损失都在下降,第 81 次突然出现 inf,第 82 次变成 nan。不能仅凭最终的 NaN 认定学习率过大,需要找出第一个非有限值。
建议按照以下顺序检查:
- 输入数据及标签:是否包含 NaN、Inf 或超出预期范围的数值。
- 模型输出:Logits、激活值是否已发生溢出。
- 损失计算:是否存在不稳定的指数、对数和除法。
- 反向传播:梯度是否出现 NaN 或 Inf。
- 参数更新:更新后权重是否仍为有限值。
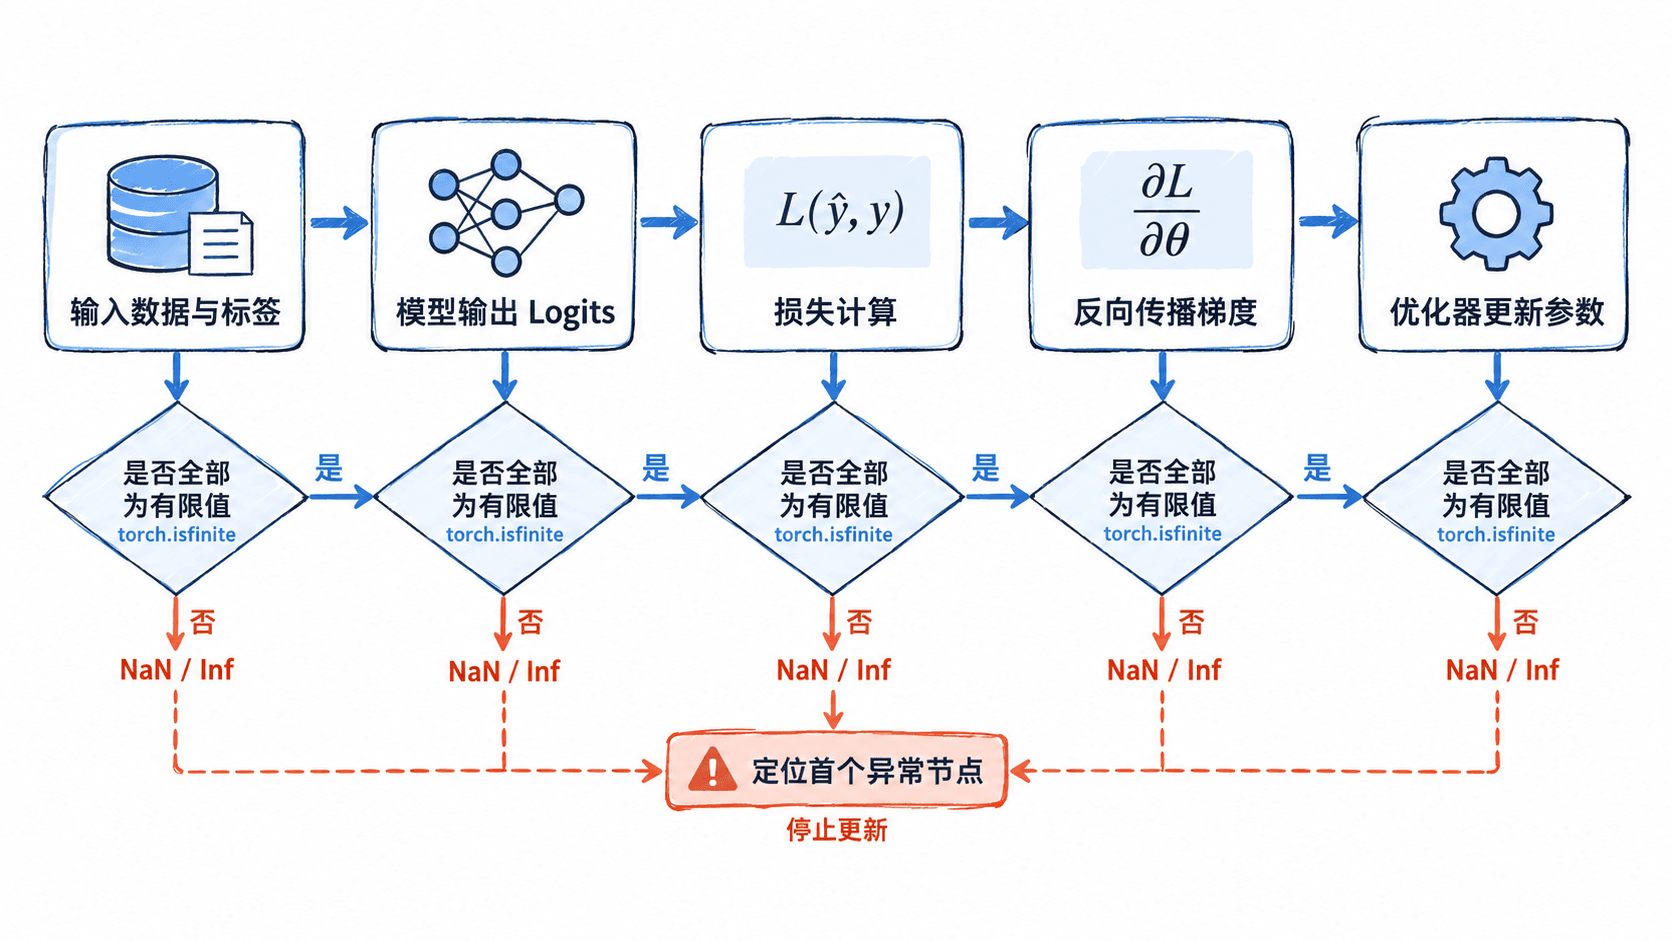
一个重要原则是:检查到非有限损失时,不要继续执行 optimizer.step()。否则异常梯度可能将参数永久污染,后续即使更换损失函数也无法恢复当前模型。
复现指数溢出和除零问题
浮点数具有有限的表示范围。对于 PyTorch 的 float32,最大有限正数约为 ,因此 exp(100) 会发生溢出,而 exp(1000) 更不可能得到有限结果。
下面的示例适用于安装了 PyTorch 2.x 的 Python 3.10 及以上环境,使用 CPU 即可运行。保存为 nan_demo.py。
import torch

# 使用 float32 模拟常见的模型计算精度
x = torch.tensor([100.0], dtype=torch.float32)
print('exp:', torch.exp(x).item())

# 零除零与无穷大相减都会产生 NaN
zero = torch.tensor(0.0)
print('0/0 is_nan:', torch.isnan(zero / zero).item())
inf = torch.tensor(float('inf'))
print('inf-inf is_nan:', torch.isnan(inf - inf).item())

# 用统一检查判断张量能否继续参与训练
values = torch.tensor([1.0, float('nan'), float('inf')])
print('finite mask:', torch.isfinite(values).tolist())
预期输出:
exp: inf
0/0 is_nan: True
inf-inf is_nan: True
finite mask: [True, False, False]
以上示例表明,溢出本身可能先产生 Inf,而后续运算才产生 NaN。调试时同时检查二者,不能仅调用 torch.isnan()。
对于包含缺失值的数据集,应先追踪缺失值来源,再决定删除、插补还是拒绝样本。直接用 torch.nan_to_num() 把所有异常替换成零,虽然可能让程序继续运行,却容易掩盖上游的数据错误。
使用稳定形式计算二分类损失
二分类模型通常先得到原始输出 Logits,再转换为概率。如果手动计算 sigmoid 和对数损失,极端 Logits 会触发数值问题。
例如,对于正样本 和 Logit ,Sigmoid 在 float32 中可能舍入为零。再执行 log(0) 会得到负无穷大。如果公式还包含 0*log(0),则可能产生 NaN。
稳定的二分类交叉熵可以写成:
实际工程中,应使用 torch.nn.functional.binary_cross_entropy_with_logits。它接收原始 Logits,在内部采用数值稳定的实现,不需要提前调用 sigmoid。
import torch
import torch.nn.functional as F

logits = torch.tensor([-1000.0, 1000.0])
targets = torch.tensor([1.0, 1.0])

# 错误示范:先算概率再手动求对数
probabilities = torch.sigmoid(logits)
naive = -(targets * torch.log(probabilities)
          + (1 - targets) * torch.log(1 - probabilities))

# 正确做法:直接输入原始 Logits
stable = F.binary_cross_entropy_with_logits(
    logits, targets, reduction='none'
)
print('naive finite:', torch.isfinite(naive).tolist())
print('stable:', stable.tolist())
print('stable finite:', torch.isfinite(stable).tolist())
预期输出:
naive finite: [False, False]
stable: [1000.0, 0.0]
stable finite: [True, True]
这里第一个样本预测严重错误,稳定损失约为 1000;第二个样本预测正确且置信度极高,损失接近零。结果有限并不意味着损失必须很小,而是计算没有产生非法浮点值。
类似地,多分类任务应直接将原始 Logits 输入 torch.nn.CrossEntropyLoss,不要先执行 Softmax 再手动取对数;需要计算 log(sum(exp(x))) 时,使用 torch.logsumexp();需要对概率求对数且存在接近零的概率时,应优先寻找对应的稳定损失 API。
在训练循环中定位首次异常
只检测最终损失还不够。假如输入正常、前向损失有限,但反向梯度已变成 Inf,那么下一次参数更新仍可能导致训练崩溃。
下面是一个完整的最小训练检查示例。它同时验证输入、模型输出、损失、梯度和更新后的参数。
import torch
from torch import nn

# 固定样本,不依赖外部数据集
model = nn.Linear(1, 1)
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
loss_fn = nn.BCEWithLogitsLoss()
x = torch.tensor([[0.0], [1.0], [2.0], [3.0]])
y = torch.tensor([[0.0], [0.0], [1.0], [1.0]])

for step in range(20):
    if not torch.isfinite(x).all() or not torch.isfinite(y).all():
        raise ValueError('Invalid input or target')

    optimizer.zero_grad()
    logits = model(x)
    if not torch.isfinite(logits).all():
        raise FloatingPointError('Invalid logits')

    loss = loss_fn(logits, y)
    if not torch.isfinite(loss).all():
        raise FloatingPointError('Invalid loss')

    loss.backward()
    # 更新前阻断异常梯度,避免污染参数
    for name, param in model.named_parameters():
        if param.grad is not None and not torch.isfinite(param.grad).all():
            raise FloatingPointError(f'Invalid gradient: {name}')

    optimizer.step()
    for name, param in model.named_parameters():
        if not torch.isfinite(param).all():
            raise FloatingPointError(f'Invalid parameter: {name}')

print('completed steps:', step + 1)
print('final loss finite:', torch.isfinite(loss).item())
预期输出:
completed steps: 20
final loss finite: True
每次运行的最终损失值可能因随机初始化而变化,因此只验证完成的迭代次数及有限性,不假设固定损失数值。实际项目里还应记录发生异常时的训练步数、样本批次编号、学习率和对应参数名称。
如果仅在 loss.backward() 时出现异常,可以临时使用 torch.autograd.set_detect_anomaly(True) 辅助定位产生异常反向梯度的运算;该功能会增加开销,适合排障而非长期开启。它也不能替代对 Inf 和输入数据的主动检查。
修复后验证并防止复发
根据第一个异常环节选择修复措施,不要同时随意修改多个超参数,否则难以判断真正原因。
| 首次异常位置 | 可能原因 | 优先修复措施 |
|---|---|---|
| 输入张量 | 数据含 NaN、Inf | 校验数据源、缺失值处理规则 |
| 模型输出 | 输入尺度或中间激活过大 | 检查归一化、学习率及模型结构 |
| 损失计算 | 直接使用 exp、log 或零分母 | 改用稳定损失 API,必要时设置合理下界 |
| 反向梯度 | 梯度爆炸 | 检查损失尺度,尝试降低学习率或梯度裁剪 |
| 参数更新 | 更新步长过大或优化器状态异常 | 降低学习率,检查优化器状态与恢复点 |
对于确实可能接近零的正分母,例如归一化中的标准差,可以依据数据量纲引入适当的 eps。但若分母理论上不应该为零,应先定位数据或公式错误,而不是无条件添加任意常数。
梯度裁剪可以限制梯度范数,例如 torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0, error_if_nonfinite=True),但它不能修复已经产生 NaN 的损失;只有在前向损失有限且反向梯度有效时,裁剪才是合适的稳定措施。
修复完成后,至少检查三个可复现的验收条件:
- 在修复前会失败的极端输入上重新运行,确认损失和梯度均有限。
- 使用固定随机种子和相同数据批次,对比修复前后的首次异常位置,确保不再出现 NaN 或 Inf。
- 执行一段连续训练,例如 100~500 步,观察损失整体趋势、梯度范数及参数有限性,并在验证集检查模型效果。
处理 NaN 最可靠的办法是找到首次产生异常值的运算,修复其数值形式或数据来源,再通过连续训练验证,而不是简单跳过异常批次或强行把 NaN 替换成零。