
AI 与工程数学 / 系统课时
学习率过大为什么会产生震荡
学习率过大为什么会产生震荡
训练模型时,损失函数明明只有一个最低点,参数却可能在最低点两侧反复跳动,甚至越走越远。问题往往不是梯度方向算错,而是学习率让每次更新跨过了最优位置。本篇用一维二次损失推导震荡条件,并通过 Python 实验比较缓慢下降、来回震荡和发散三种情况。
学习目标
- 理解学习率如何决定参数更新的方向、幅度和稳定性。
- 推导一维二次损失中单调收敛、震荡收敛和发散的条件。
- 使用 Python 验证不同学习率的轨迹,并判断训练是否稳定。
从一个二次损失开始
选择最简单的目标函数:
它的最小值位于 ,梯度为:
梯度下降使用学习率 更新参数:
这里 表示更新次数, 是正数。每一步都将当前参数乘以同一个系数 。因此,学习率不只决定步长,还决定下一步会不会跨过零点。
例如从 出发,学习率取 ,第一次更新得到 ;取 ,第一次更新得到 。两次更新都使损失从 降到 ,但第二种已经跨过最优点。
学习率决定三种运动状态
把更新公式连续展开,可以得到:
只要观察系数 ,就能判断参数的变化规律。
| 学习率范围 | 更新系数 | 参数表现 | 最终结果 |
|---|---|---|---|
| 同侧缓慢靠近零点 | 单调收敛 | ||
| 一步到达零点 | 立即收敛 | ||
| 两侧交替,振幅缩小 | 震荡收敛 | ||
| 两侧等距离往返 | 不收敛 | ||
| 两侧交替,振幅增大 | 发散 |
以 为起点,比较四种学习率的前几次更新:
| 更新次数 | ||||
|---|---|---|---|---|
| 0 | 4 | 4 | 4 | 4 |
| 1 | 3.2 | -2 | -4 | -6 |
| 2 | 2.56 | 1 | 4 | 9 |
| 3 | 2.048 | -0.5 | -4 | -13.5 |
| 4 | 1.6384 | 0.25 | 4 | 20.25 |
这张表揭示一个容易误判的现象: 时参数符号不断变化,但损失持续下降; 时参数同样交替变号,损失却越来越大。
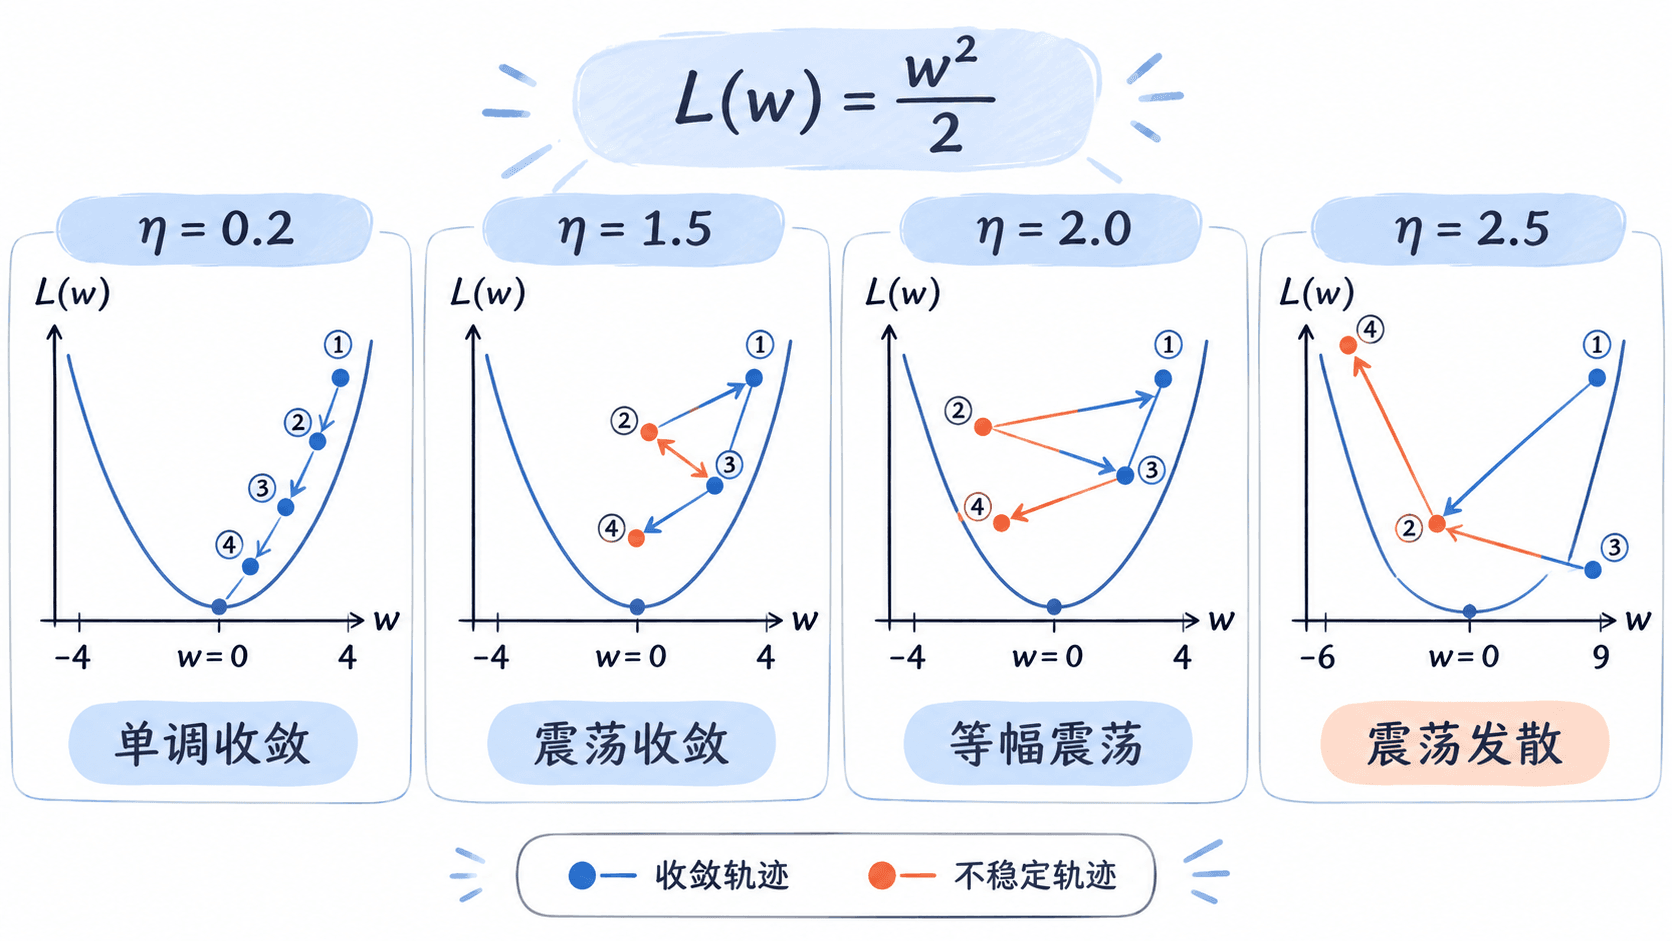
为什么临界值恰好是 2
参数收敛要求每次更新后的绝对值小于上一步:
对于非零参数,振幅必须满足:
解得:
这是当前损失函数、标准梯度下降和固定正学习率下的稳定区间。注意 时参数不更新,同样无法从非最优初值收敛到零。
更一般地,若损失为:
梯度为 。令误差 ,更新后得到:
因此稳定条件变成:
例如曲率 时,稳定学习率必须小于 ,而不是 。当 时,误差每步乘以 ,会震荡收敛;当 时,每步乘以 ,会震荡发散。
这也解释了为什么相同学习率在一个模型上正常,在另一个模型上可能导致损失暴涨:不同方向的曲率可能相差很大。对多维正定二次损失,固定学习率需要结合 Hessian 最大特征值判断局部稳定性;一般神经网络则没有统一适用的学习率临界值。
用 Python 复现三种结果
下面的示例使用 Python 3.10 或更新版本,仅依赖标准库。程序从 出发,对四种学习率各执行四次梯度更新,同时计算损失。
def loss(w: float) -> float:
    return 0.5 * w * w


def train(lr: float, steps: int = 4) -> None:
    w = 4.0
    print(f"lr={lr:.1f}")
    print(f"step=0 w={w:8.4f} loss={loss(w):10.4f}")

    for step in range(1, steps + 1):
        # 使用更新前的 w 计算梯度,避免混入下一步参数
        gradient = w
        w -= lr * gradient
        print(f"step={step} w={w:8.4f} loss={loss(w):10.4f}")


if __name__ == "__main__":
    # 同时观察单调收敛、震荡收敛、等幅震荡和发散
    for learning_rate in (0.2, 1.5, 2.0, 2.5):
        train(learning_rate)
将代码保存为 learning_rate_demo.py,执行 python learning_rate_demo.py。
预期输出:
lr=0.2
step=0 w=  4.0000 loss=    8.0000
step=1 w=  3.2000 loss=    5.1200
step=2 w=  2.5600 loss=    3.2768
step=3 w=  2.0480 loss=    2.0972
step=4 w=  1.6384 loss=    1.3422
lr=1.5
step=0 w=  4.0000 loss=    8.0000
step=1 w= -2.0000 loss=    2.0000
step=2 w=  1.0000 loss=    0.5000
step=3 w= -0.5000 loss=    0.1250
step=4 w=  0.2500 loss=    0.0312
lr=2.0
step=0 w=  4.0000 loss=    8.0000
step=1 w= -4.0000 loss=    8.0000
step=2 w=  4.0000 loss=    8.0000
step=3 w= -4.0000 loss=    8.0000
step=4 w=  4.0000 loss=    8.0000
lr=2.5
step=0 w=  4.0000 loss=    8.0000
step=1 w= -6.0000 loss=   18.0000
step=2 w=  9.0000 loss=   40.5000
step=3 w=-13.5000 loss=   91.1250
step=4 w= 20.2500 loss=  205.0312
输出保留四位小数,因此 显示为 0.0312,属于 Python 浮点格式化结果。观察时要同时检查参数和损失:参数正负交替只能证明发生了跨越,损失是否持续下降才是判断这一实验是否稳定的重要依据。
训练中遇到震荡应该怎样调整
当真实模型出现损失忽高忽低时,不应只根据相邻两次更新的参数符号判断学习率是否过大。小批量训练本来就存在梯度噪声,应优先观察多个训练步骤上的损失趋势,并区分随机波动与持续放大的震荡。
可以按下面的顺序排查:
- 保存当前学习率、损失曲线和梯度范数。若连续多个窗口的损失峰值升高,同时梯度或参数更新幅度放大,优先怀疑更新不稳定。
- 将学习率先降为原来的 倍,保持数据、批大小、随机种子和其他优化器设置一致,重新运行相同数量的训练步骤。
- 比较新旧运行的损失趋势。如果降低学习率后异常波动明显减少,可以继续在两者之间试探,而不是直接认定越小越好。
- 如果降低学习率仍不稳定,检查输入和标签尺度、异常样本、数值溢出、梯度实现及优化器配置。
例如原学习率为 ,第一次排查可测试 。如果损失变得稳定但下降很慢,再试 ;如果仍然出现持续放大的峰值,则进一步缩小学习率或检查其他原因。这些数值只是排查示例,并非通用最优参数。
可以再做一个验证:将代码中的学习率改为 和 ,分别执行四次更新。前者参数始终在零点同侧,后者每次跨越零点,但二者都会快速收敛。由此可以明确区分:震荡描述参数如何运动,发散描述误差是否扩大;学习率过大导致训练失败,是因为跨越后的振幅不再缩小。