
AI 与工程数学 / 系统课时
用二阶导数判断局部曲率
用二阶导数判断局部曲率
训练模型时,即使梯度方向正确,学习率过大也可能使损失反复震荡甚至发散。二阶导数能够描述目标函数在当前位置的弯曲程度,帮助我们判断局部形状、估计安全步长,并解释为什么不同方向需要不同的更新幅度。
学习目标
- 计算常见目标函数的一阶、二阶导数,并判断局部曲率。
- 根据曲率推导梯度下降的稳定步长范围。
- 区分正曲率、负曲率与零曲率,理解非凸优化中的判断边界。
二阶导数怎样描述曲率
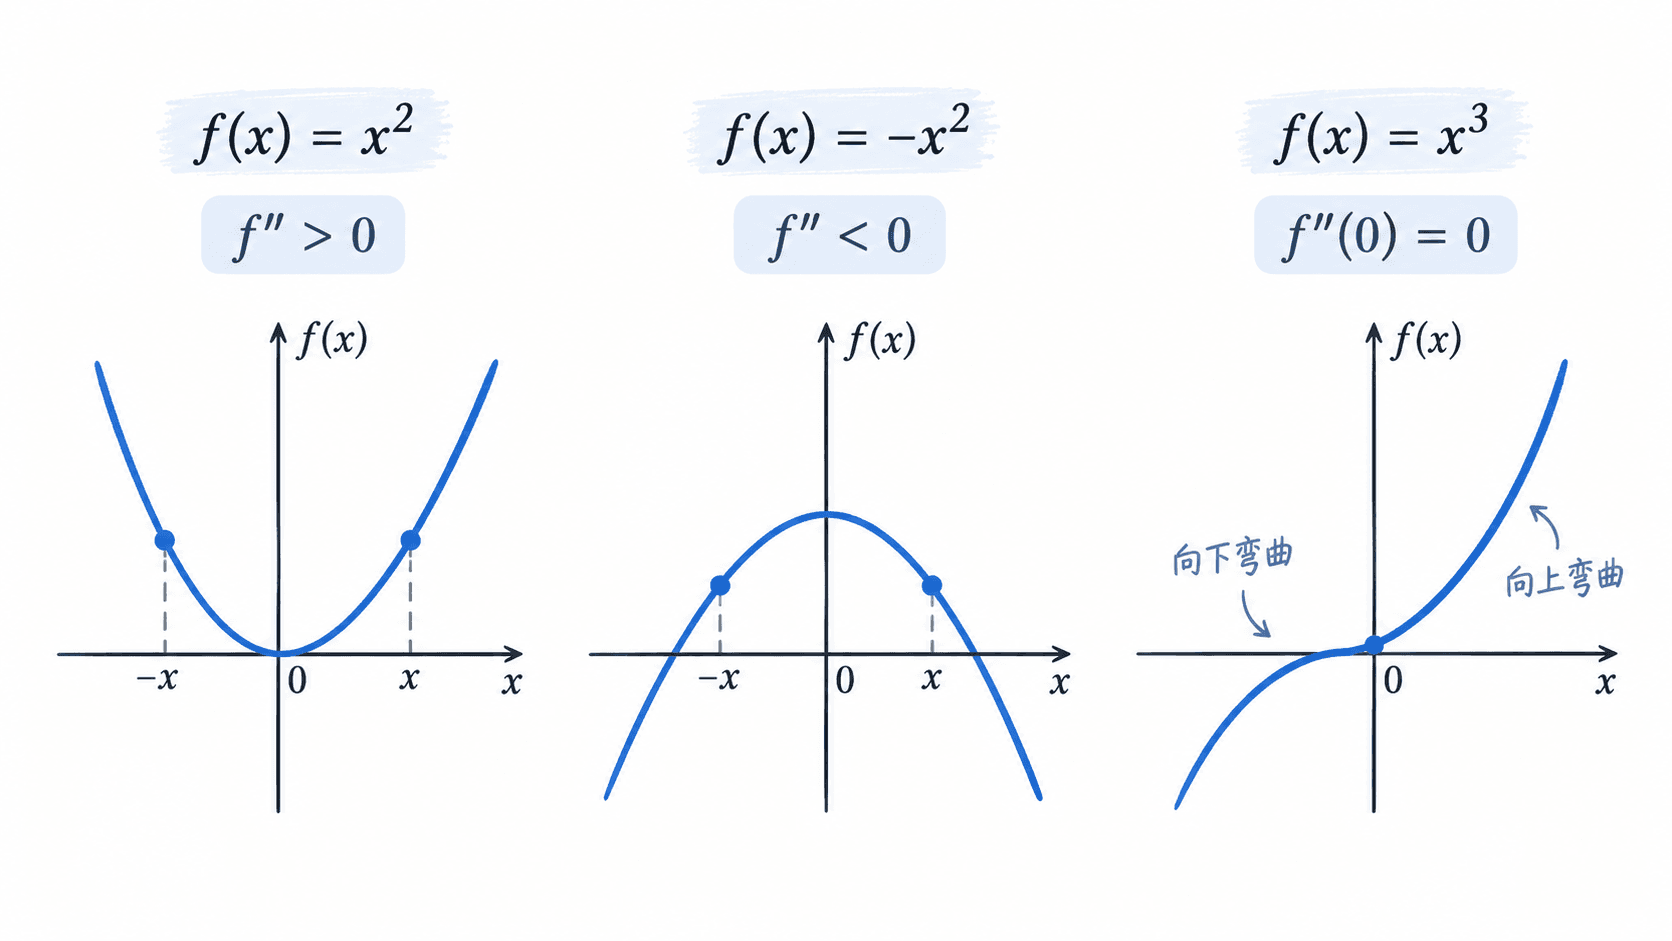
对于一元可二阶求导函数 ,一阶导数 描述斜率,二阶导数 描述斜率随位置变化的速度。
- :局部向上弯曲,斜率随 增大而增加。
- :局部向下弯曲,斜率随 增大而减小。
- :仅凭该点的二阶导数无法确定局部形状。
例如 ,其导数为:
二阶导数始终为正,表示函数处处向上弯曲。在 处,梯度是 ,而曲率指标是 ;两者反映的是不同信息。
需要注意, 是优化中常用的二阶曲率指标,并非几何曲线的精确曲率。后者还受一阶导数影响。
通过典型函数计算局部曲率
判断一个驻点是否为局部极值,通常先解 ,再检查驻点的二阶导数。
| 目标函数 | 一阶导数 | 二阶导数 | 驻点判断 |
|---|---|---|---|
| 为严格局部极小值 | |||
| 为严格局部极大值 | |||
| 二阶检验不确定,实际为严格极小值 | |||
| 二阶检验不确定,实际不是极值 |
表中的 和 都在原点具有零二阶导数,但结论不同。这说明二阶导数为零不等于函数平坦到没有极值,也不等于一定存在拐点。
再考虑非凸函数:
计算得到:
令一阶导数为零,得到三个驻点:。
- 和 :二阶导数均为 ,是严格局部极小值,函数值均为 。
- :二阶导数为 ,是严格局部极大值,函数值为 。
这个函数同时存在两个谷底和一个峰顶,说明非凸目标的局部形状可能随位置改变,不能只观察某个点的曲率就推断整个函数的形状。
曲率如何限制梯度下降步长
梯度下降的一维更新规则是:
其中 为学习率。考虑标准二次函数:
由于 、,更新式变成:
要使迭代从任意初始点收敛到 ,必须满足:
整理得到严格的稳定收敛范围:
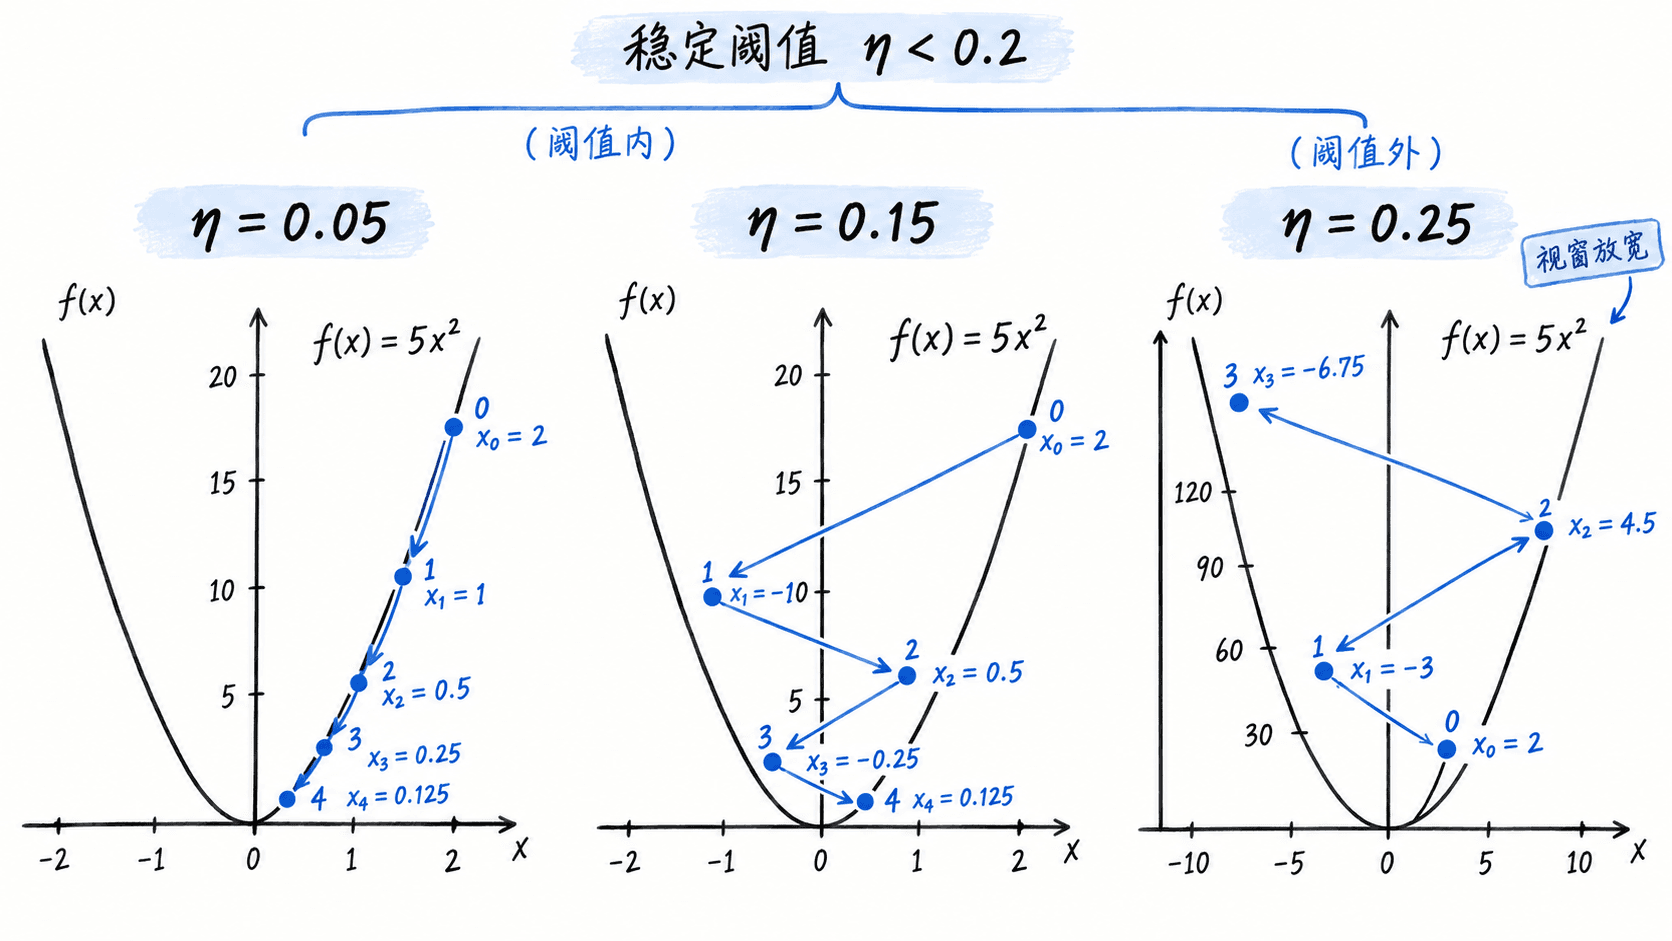
例如选择 ,其二阶导数为 ,因此学习率需要满足 。
从初始点 出发,比较三种设置:
| 学习率 | 更新倍率 | 迭代表现 |
|---|---|---|
| 同侧逐步收敛 | ||
| 两侧交替、逐步收敛 | ||
| 两侧交替、幅度扩大 |
时倍率为 ,除非已在最优点,否则会等幅往返而不收敛。 时,该精确二次函数可一步到达最优点。
使用 Python 验证步长结论
下面的完整示例使用 Python 3 标准库,不依赖 NumPy。分别运行三种学习率,每次执行五步梯度下降,观察参数是否靠近最优点。
# 目标函数 f(x)=5*x*x,其梯度为 10*x

def gradient_descent(learning_rate, steps=5):
    x = 2.0
    for _ in range(steps):
        x -= learning_rate * 10 * x
    return x, 5 * x * x


if __name__ == "__main__":
    for lr in (0.05, 0.15, 0.25):
        x, loss = gradient_descent(lr)
        print(f"lr={lr:.2f}, x={x:.6f}, loss={loss:.6f}")
预期输出:
lr=0.05, x=0.062500, loss=0.019531
lr=0.15, x=-0.062500, loss=0.019531
lr=0.25, x=-15.187500, loss=1153.330078
前两组经过五步后损失都明显下降,但第二组参数在最优点两侧交替。第三组损失大幅上升,说明梯度方向虽然正确,学习率仍可能导致发散。
这里的 是正曲率二次函数的严格收敛上界,不是所有非线性函数在任意位置都适用的全局安全学习率。一般光滑函数需要结合梯度的 Lipschitz 常数或线搜索判断步长。
多维模型中的曲率与训练难点
神经网络参数通常是向量 ,多维情况下使用 Hessian 矩阵描述二阶变化:
例如二维目标函数:
它的 Hessian 为:
沿 方向曲率为 ,沿 方向曲率为 。对于固定学习率的梯度下降,两个方向分别要求 和 ,整体收敛必须满足更严格的 。
如果选 , 分量一步归零,但 分量每次只缩小到原来的 ,需要约 步才能缩小到初始值的 以下。这就是不同方向曲率差异过大时,固定学习率可能导致某些方向收敛缓慢的原因。
对于 Hessian 对称的二阶可微函数,可以用特征值判断驻点的局部性质:
- 全部特征值大于零:Hessian 正定,驻点是严格局部极小值。
- 全部特征值小于零:Hessian 负定,驻点是严格局部极大值。
- 同时存在正、负特征值:Hessian 不定,驻点是鞍点。
- 存在零特征值且没有正负混合:二阶检验可能无法给出完整结论,需要进一步分析。
在多维正定二次目标中,固定学习率梯度下降的稳定区间为 ,其中 是 Hessian 最大特征值。
实际训练非凸神经网络时,Hessian 可能随参数变化,而且计算完整矩阵代价很高。因此,二阶分析更适合用于解释局部训练行为、诊断病态曲率与选择优化策略,而不应简单理解成每一步都要显式计算完整 Hessian。
遇到损失震荡时,可先尝试减小学习率;遇到不同方向收敛速度差异明显时,再考虑参数缩放、预条件方法或自适应优化器。通过二阶导数理解这些现象,能够把学习率调整从盲目试数值变成有依据的诊断。