
AI 与工程数学 / 系统课时
特征尺度为什么拖慢梯度下降
特征尺度为什么拖慢梯度下降
同样使用梯度下降,为什么有的模型几十步就收敛,有的模型却需要几千步?一个常见原因是输入特征的尺度差异过大。本课通过二维线性回归,对比原始特征与标准化特征的损失等高线、梯度方向和训练过程,并用 Python 验证标准化如何改善收敛速度。
学习目标
- 理解特征尺度如何影响损失等高线与梯度下降路径。
- 通过具体数值解释学习率为什么会受到大尺度特征限制。
- 使用 NumPy 对比标准化前后的收敛表现,并掌握正确的标准化方法。
特征尺度如何改变优化难度
假设要用两个特征预测某个产品的销量:
- 特征 :广告投放次数,通常在 0~10 之间。
- 特征 :广告展示量,通常在 0~10000 之间。
线性模型为:
使用均方误差作为损失函数:
其中 是样本数量。梯度下降沿损失函数的负梯度方向更新参数:
这里 是学习率。对于上面的线性模型,两个权重的梯度分别为:
注意梯度中乘了对应特征 。当特征尺度差异达到几百倍甚至几千倍时,不同权重方向的梯度尺度也可能差异显著。
这不意味着大尺度特征必然具有更大的预测价值,而是说参数空间在不同方向上的曲率可能相差很大,导致使用同一个学习率更新所有权重时效率低下。
损失等高线为什么从圆形变成长椭圆
为了看清几何关系,先考虑中心化后的两个特征,固定偏置 。令设计矩阵为 ,权重向量为 ,则平方损失的 Hessian 矩阵为:
Hessian 描述损失曲面在不同参数方向上的曲率。对于彼此正交的两个特征方向,如果特征的标准差分别为 1 和 100,那么 Hessian 的两个特征值分别为 1 和 10000。
这意味着沿第二个参数方向,损失增长得快得多。相同损失值对应的参数范围在这个方向非常狭窄,而在第一个方向相对宽阔,于是损失等高线呈现狭长椭圆。
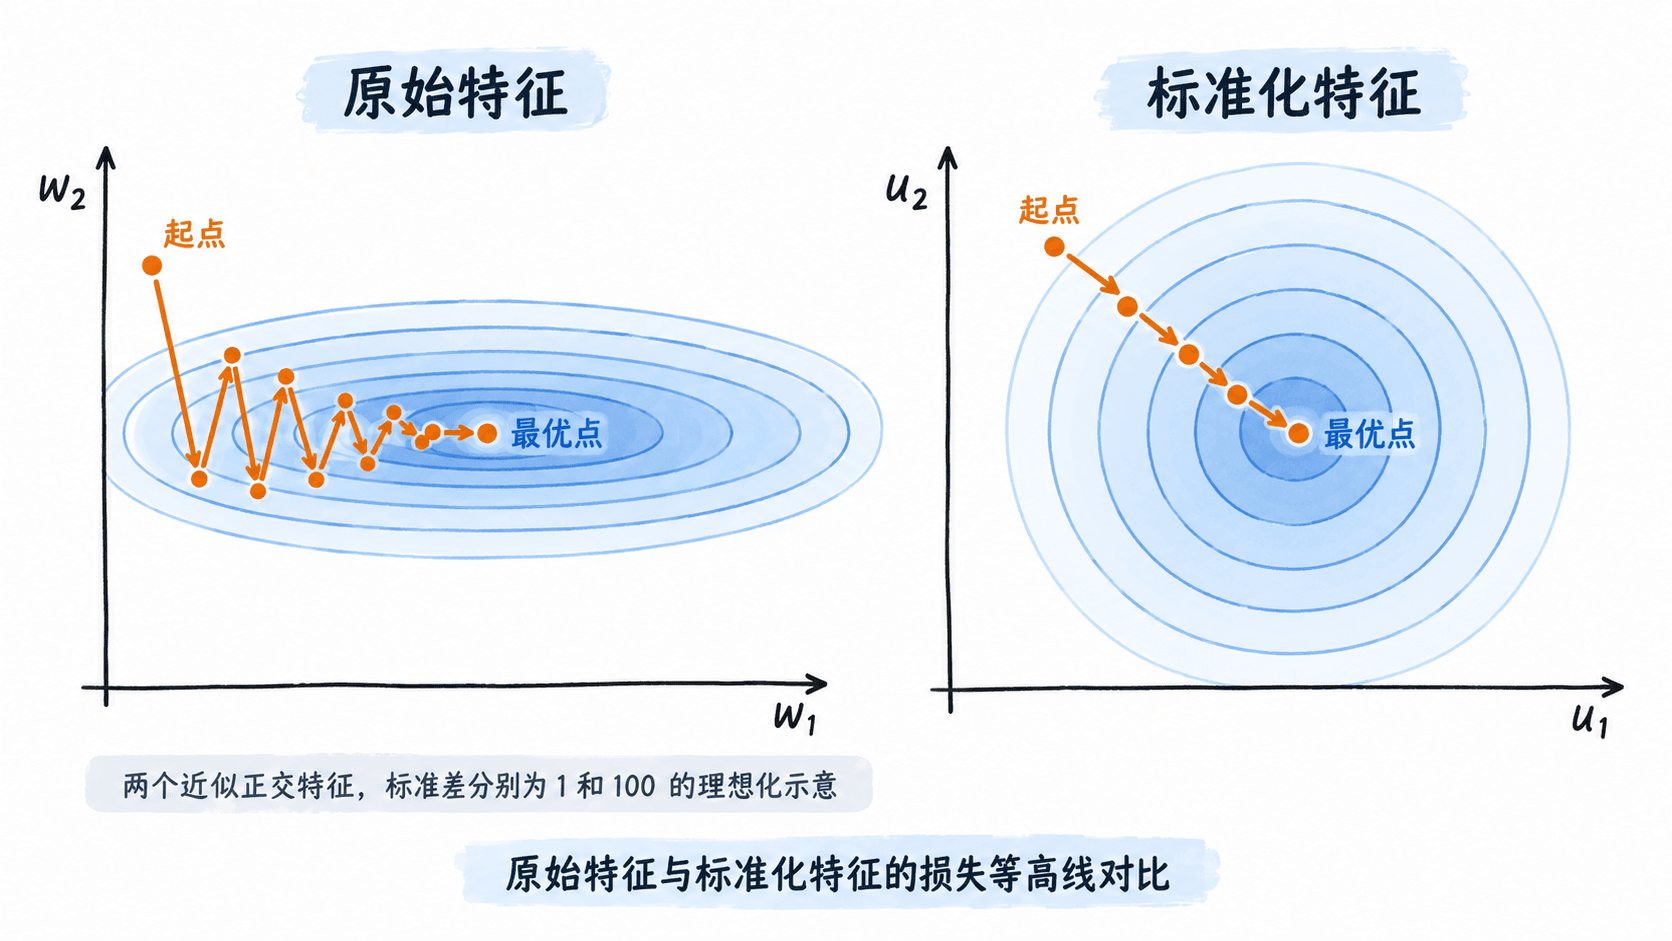
标准化将每个特征减去均值,再除以标准差:
若两个标准化后的特征近似不相关,新的 Hessian 就接近单位矩阵,损失等高线也会接近圆形。梯度下降不再需要为某一个特别陡峭的方向大幅压低学习率。
需要注意:标准化不能消除特征之间的高度相关性。如果两个特征几乎重复,即使各自方差都变成 1,等高线仍可能呈现狭长形状。
用数字看学习率为什么被限制
考虑一个用于说明曲率影响的二次损失:
对应梯度为:
梯度下降的更新为:
为了使两个方向的参数都收敛到 0,必须满足:
假设学习率取 0.0001,初始权重为 ,那么第一次更新结果为:
- 从 1 变为 0.9999。
- 从 1 变为 0。
第二个方向一步就到达最优点,但第一个方向每次只能缩小万分之一。要让 从 1 降到 0.01,大约需要 46050 次迭代。
如果将两个方向的曲率都调整为 1,取学习率 0.5,则每轮参数变为原来的一半。从 1 降到 0.01 只需要 7 次更新。
这个算例说明,曲率差异会使统一学习率受到最陡峭方向的约束。不过,特征标准化只是改善曲率条件,并不保证任何数据都能达到 7 步收敛。
用 Python 验证两种尺度的训练差异
下面构造两个互相正交、标准差分别为 1 和 100 的特征。这样可以排除特征相关性的干扰,只观察尺度造成的影响。
环境要求:Python 3.10 或更新版本、NumPy 1.26 或兼容版本。安装依赖:
python -m pip install "numpy>=1.26,<3"预期结果:安装成功,或提示已满足依赖;实际下载信息和安装路径因环境而异。
将以下代码保存为 feature_scaling.py,然后执行 python feature_scaling.py。
import numpy as np

# 两列特征正交,均值为 0,标准差分别为 1 和 100
x1 = np.array([-1.0, -1.0, 1.0, 1.0])
x2 = np.array([-100.0, 100.0, -100.0, 100.0])
X = np.column_stack((x1, x2))
y = x1 + x2 / 100.0


def train(features, learning_rate, steps):
    weights = np.zeros(features.shape[1])
    history = []
    for _ in range(steps):
        error = features @ weights - y
        loss = np.mean(error ** 2) / 2
        history.append(loss)
        # 梯度采用与均方误差前的 1/2 系数一致的定义
        gradient = features.T @ error / len(y)
        weights -= learning_rate * gradient
    return weights, history


# 原始尺度必须采用较小学习率,避免高曲率方向发散
raw_weights, raw_history = train(X, 0.0001, 100)
mean = X.mean(axis=0)
std = X.std(axis=0)
Z = (X - mean) / std
scaled_weights, scaled_history = train(Z, 0.5, 100)

print(f"原始特征:初始损失={raw_history[0]:.6f},第100轮损失={raw_history[-1]:.6f}")
print(f"标准化后:初始损失={scaled_history[0]:.6f},第100轮损失={scaled_history[-1]:.6f}")
print(f"原始权重={np.round(raw_weights, 6)}")
print(f"标准化权重={np.round(scaled_weights, 6)}")
预期输出:
原始特征:初始损失=1.000000,第100轮损失=0.490174
标准化后:初始损失=1.000000,第100轮损失=0.000000
原始权重=[0.00995 0.01   ]
标准化权重=[1. 1.]
原始特征的第二列数值更大,所以其权重可以很快达到 0.01;第一列权重却只前进到约 0.00995,距离目标值 1 还很远。
标准化后的两列特征都是单位方差,且彼此正交。学习率为 0.5 时,两个方向的误差每轮都缩小一半,所以第 100 轮损失已经小到以六位小数显示为 0。
实际训练时怎样正确标准化
生产中不能简单地对整个数据集统一计算均值和标准差。正确做法是在划分训练集和验证集之后,只用训练集统计量进行标准化。
- 将数据划分为训练集与验证集,例如 80% 和 20%。
- 仅在训练集计算每列特征的均值 与标准差 。
- 训练集和验证集都使用训练集得到的同一组统计量。
- 模型部署时保存统计量,线上输入按相同规则转换。
例如训练集某特征均值为 200,标准差为 50,验证集中某条样本取值为 300,则标准化后的值为:
不能重新计算验证集的均值和标准差,否则评估使用的特征变换将不同于训练阶段,还可能引入数据泄漏。
如果某个特征的标准差为 0,说明它在训练集中是常量。实际处理时通常直接删除该特征,或让标准化程序将其映射为 0,不能直接除以 0。
另外,标准化前后模型权重的数值不能直接比较。对于 ,若标准化空间中的权重为 ,那么原始空间对应的权重为 ,偏置也需要相应调整。
当梯度下降训练缓慢、损失反复震荡,且输入特征的取值范围明显不同时,应先检查各特征的标准差和损失曲率。标准化经常能提高训练效率,但对于高度相关、严重异常值或条件数仍然很大的数据,还需要进一步考虑特征处理、正则化或自适应优化方法。