
AI 与工程数学 / 系统课时
学习率衰减何时优于固定步长
学习率衰减何时优于固定步长
固定学习率容易遇到一个典型矛盾:步长大时前期下降快,却可能在最优点附近反复震荡;步长小时后期稳定,前期又推进过慢。本课用同一个二次目标分别测试固定步长、阶梯衰减和余弦调度,直接比较收敛速度与最终误差。
学习目标
- 解释固定学习率在训练前期和后期的速度—稳定性矛盾。
- 用可运行实验比较固定步长、阶梯衰减和余弦调度的迭代结果。
- 根据训练轮数、平台期和验证指标选择是否衰减以及何时开始衰减。
固定步长为什么会卡在速度与稳定性之间
先看一维目标 。其梯度为 ,梯度下降更新式为:
若始终使用固定学习率 ,每一步都有 ,从 出发,5 步后已经降到 ,速度很快。对于这种简单且条件良好的目标,固定步长本身就足够好。
真实模型的损失面通常存在不同曲率。某个方向允许 ,另一个高曲率方向可能只能稳定承受 。若始终保留前期较大的步长,参数在训练后段容易越过狭窄谷底;若一开始就用 ,又会浪费大量训练轮数。
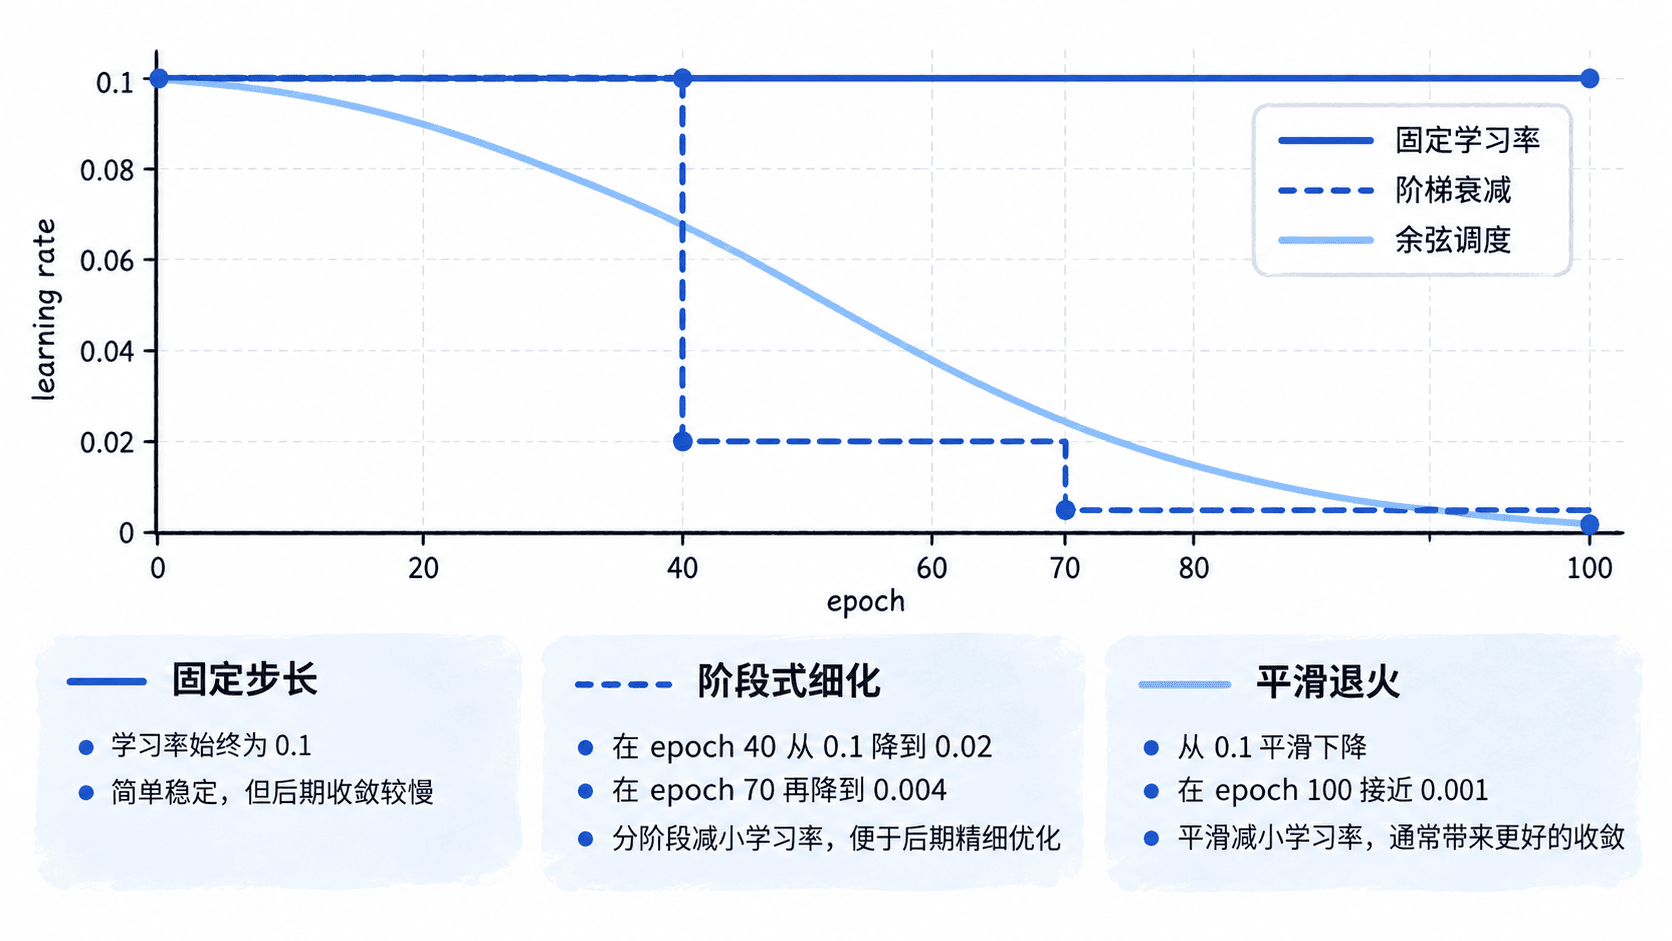
因此衰减策略解决的是时间尺度上的分工:前期使用较大学习率快速移动,后期降低学习率进行细化。它并不保证任何任务都比固定步长好;当固定学习率已经能在预算内稳定收敛时,增加调度器反而只是多一个超参数。
用同一个目标比较三种调度
下面的 NumPy 实验优化 ,梯度为 。初始值设为 ,运行 40 步。固定策略使用 ;阶梯策略前 15 步使用 ,之后降为 ,30 步后再降为 ;余弦策略从 平滑下降到 。
import math


def grad(x):
    return 10.0 * x


def fixed_lr(step, total_steps):
    return 0.18


def step_lr(step, total_steps):
    if step < 15:
        return 0.18
    if step < 30:
        return 0.06
    return 0.02


def cosine_lr(step, total_steps):
    lr_max = 0.18
    lr_min = 0.01
    ratio = step / (total_steps - 1)
    return lr_min + 0.5 * (lr_max - lr_min) * (1 + math.cos(math.pi * ratio))


def run(name, schedule, total_steps=40):
    x = 5.0
    checkpoints = {0, 4, 14, 29, 39}
    for step in range(total_steps):
        lr = schedule(step, total_steps)
        x -= lr * grad(x)
        if step in checkpoints:
            print(f"{name:7s} step={step + 1:2d} lr={lr:.4f} x={x:.8f} loss={5*x*x:.10f}")


for name, schedule in [
    ("fixed", fixed_lr),
    ("step", step_lr),
    ("cosine", cosine_lr),
]:
    run(name, schedule)
预期输出中数值应接近以下结果;不同 Python 版本只可能出现最后几位浮点差异:
fixed   step= 1 lr=0.1800 x=-4.00000000 loss=80.0000000000
fixed   step= 5 lr=0.1800 x=-1.63840000 loss=13.4217728000
fixed   step=15 lr=0.1800 x=-0.17592186 loss=0.1547425049
fixed   step=30 lr=0.1800 x=0.00618970 loss=0.0001915624
fixed   step=40 lr=0.1800 x=0.00066461 loss=0.0000022085
这个目标对 仍然稳定,因此固定步长最终也能收敛。实验真正值得观察的是参数更新幅度:前 15 步三种策略都允许较大的移动,进入后半段后,阶梯和余弦策略主动缩小更新,从而降低接近最优点时的摆动幅度。
阶梯衰减适合有明确训练阶段的任务
阶梯衰减的优点是可解释、容易复现实验。典型配置可以是初始学习率 0.1,在第 40 和第 70 个 epoch 各乘 0.2,得到 0.1 → 0.02 → 0.004。如果训练日志显示验证损失在 35~40 epoch 左右开始进入平台,这种切换点就有明确依据。
实际判断时,不要因为“训练过半”机械降学习率。更有用的依据是连续若干轮的指标变化。例如验证损失从 0.421 → 0.407 → 0.403 → 0.402 → 0.402,而训练损失仍缓慢下降,此时把学习率降低 5 倍,可以测试平台期究竟是步长过大还是模型已经接近当前容量上限。
阶梯衰减的缺点是切换点发生突变。若在 epoch 40 将学习率从 0.1 直接降到 0.001,更新幅度瞬间缩小 100 倍,后续训练可能几乎停止。第一次尝试时,常见的保守范围是每次乘 0.1~0.5,再依据验证集结果调整。
余弦调度适合希望平滑收尾的长训练
余弦调度常用形式为:
例如训练 100 个 epoch,设置 、。在开始阶段学习率接近 0.1,中段平滑下降,末期接近 0.001。与阶梯衰减相比,它没有突然的断点,适合已经确定总训练预算的场景。
需要注意,余弦调度不是“自动找到最佳学习率”。若 lr_max 本身过大,前期仍可能发散;若设成 0.001 而任务原本能稳定使用 0.1,整条曲线都会过于保守。调度器只能改变学习率随时间的形状,不能替代初始学习率搜索。
对于总轮数经常变化的实验,也要重新确认 。原计划 100 epoch 的余弦曲线如果实际只训练 30 epoch 就提前停止,学习率可能尚未进入真正的小步长阶段;此时不能把结果与完整 100 epoch 训练直接等价比较。
什么时候继续用固定学习率
可以先用一个简单判据决定是否值得引入衰减。假设同一模型训练 50 epoch,固定学习率 0.001 时验证损失在第 20、30、40、50 epoch 分别为 0.214、0.183、0.171、0.169,训练过程没有明显震荡,而且最后 10 个 epoch 的提升只有 0.002。这时调度可能带来少量收益,但未必值得增加复杂度。
反过来,如果固定 0.01 前期下降很快,但后期验证损失长期在 0.190~0.205 间摆动,而固定 0.001 又要多花数倍 epoch 才到同一水平,就很适合采用“先大后小”的调度策略。可以先试阶梯方案 0.01 → 0.003 → 0.001;如果总训练步数固定且希望变化更平滑,再测试余弦调度。
比较方案时必须保持模型初始化、数据划分、批大小和训练预算一致,并至少重复 3 个随机种子。若只看到某一次运行的最终损失从 0.168 变成 0.165,还不足以证明调度更好;更有价值的是同时检查达到目标损失所需的 epoch、最终验证指标以及最后阶段的波动幅度。