
AI 与工程数学 / 系统课时
用梯度向量确定更新方向
用梯度向量确定更新方向
当目标函数有两个或更多参数时,只看单个偏导数无法判断参数应该怎样一起移动。通过计算二维函数的梯度,我们可以确定局部上升最快的方向,再取负梯度得到下降方向,并借助等高线解释为什么梯度下降能够逐步降低损失。
学习目标
- 计算二维目标函数在指定点的梯度向量。
- 根据负梯度和学习率计算一次参数更新。
- 结合等高线理解局部最速下降及其适用条件。
从偏导数得到梯度向量
考虑一个有两个参数的目标函数:
这里的 和 可以理解为模型中两个需要训练的参数, 表示希望最小化的损失。对两个变量分别求偏导:
将偏导数组合成列向量,就是梯度:
在点 处,梯度为:
这个结果说明,在该点附近,沿正 和正 方向增加参数都会使函数增大。梯度的两个分量恰好相等,但这不意味着两个参数在整个优化过程中始终具有相同影响。
例如,在点 处,梯度变成 ,此时一阶近似下,沿 轴微小移动不会改变函数值;沿负 方向移动则会使函数下降。
利用负梯度计算参数更新
对可微函数,在当前位置附近沿单位方向 移动,函数的一阶变化率是:
当梯度不为零时,根据柯西-施瓦茨不等式,单位方向上的最小变化率为 ,对应方向是:
因此,在欧氏距离度量下,负梯度是局部最速下降方向。常见的梯度下降更新公式直接使用未归一化的负梯度:
其中 是学习率,它控制沿负梯度移动的距离。
从 出发,取学习率 :
更新前的函数值为 ,更新后为:
损失由 降至 ,下降了 。这验证了该步更新有效,但不能据此认为任意学习率都能下降。
对于本例,若取 ,新位置为 ,函数值反而变为 。负梯度只保证足够小的正步长在梯度非零时能够局部下降,并不保证大步更新一定成功。
用等高线理解方向选择
等高线连接函数值相同的点。本例的等高线满足:
当 时,它们是以原点为中心的椭圆。越靠近原点,函数值越小;原点 是全局最小点,函数值为零。
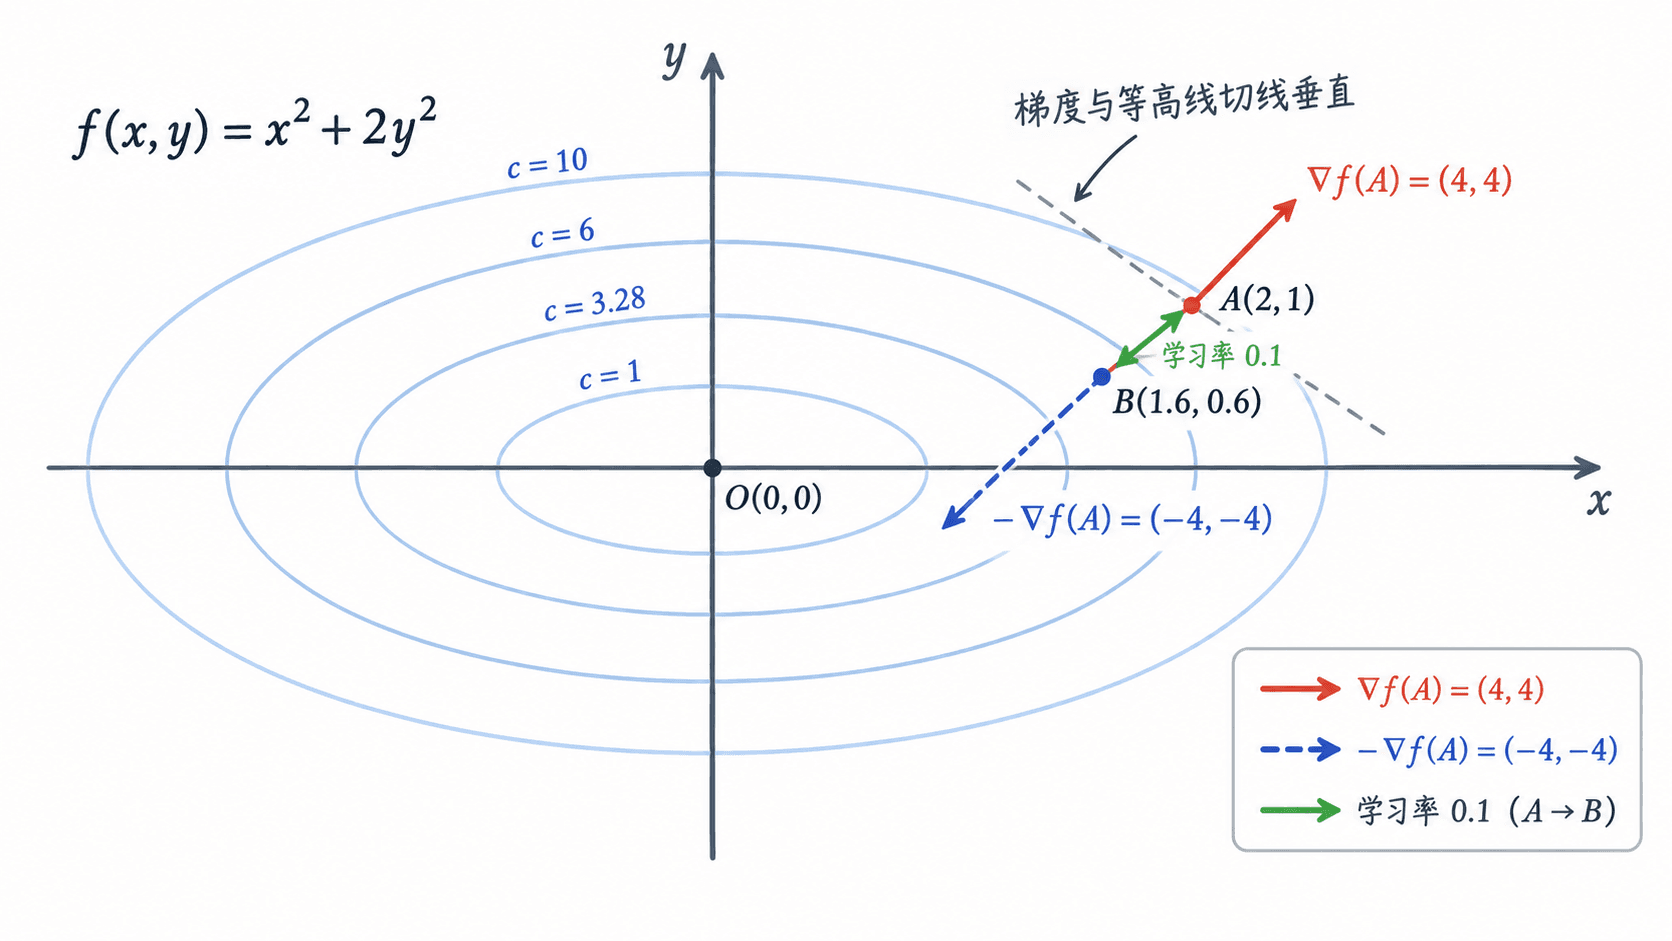
从图中可以观察到三个关键关系:
- 梯度指向局部增长最快的方向:在 处,梯度 指向右上方,垂直于经过该点的等高线。
- 负梯度指向局部下降最快的方向:反转梯度后指向左下方,朝着更低的函数值移动。
- 更新方向和实际位移不同:负梯度确定方向,学习率决定步长。本例实际位移为 ,并非一次直接到达最小点。
为什么梯度与等高线垂直?沿光滑等高线的切线方向移动时,函数值的一阶变化为零,因此梯度与切向量的点积为零。负梯度就是垂直穿过等高线、朝局部低值一侧前进的方向。
需要注意,最速下降是一个局部概念,且依赖欧氏范数的定义;它不意味着每一步都指向全局最优点,也不意味着整条优化轨迹是通向最优点的最短路径。
用 Python 核对方向与损失变化
下面用 Python 3 和 NumPy 实际计算梯度、更新位置与前后损失。先在终端安装依赖:
python -m pip install numpy预期结果:安装成功时命令退出码为 0;安装进度与版本信息随环境不同,不依赖特定日志文本。
将以下完整程序保存为 gradient_demo.py:
import numpy as np


def loss(theta):
    return theta[0] ** 2 + 2 * theta[1] ** 2


def gradient(theta):
    # 按 x、y 的顺序排列两个偏导数
    return np.array([2 * theta[0], 4 * theta[1]])


def main():
    theta = np.array([2.0, 1.0])
    learning_rate = 0.1
    grad = gradient(theta)

    # 使用同一位置的梯度同时更新两个参数
    next_theta = theta - learning_rate * grad
    print(f"gradient: {grad}")
    print(f"next theta: {next_theta}")
    print(f"loss before: {loss(theta):.2f}")
    print(f"loss after: {loss(next_theta):.2f}")


if __name__ == "__main__":
    main()
运行程序:
python gradient_demo.py预期输出:
gradient: [4. 4.]
next theta: [1.6 0.6]
loss before: 6.00
loss after: 3.28
这里使用解析偏导数,没有进行数值差分。程序计算出的结果与手工推导一致,说明梯度分量顺序和更新公式没有写反。
还可以将 learning_rate 改为 1.0 后重新运行,观察损失是否仍然下降。这能直接验证学习率过大时可能越过低值区域的现象。
梯度为零和方向失效的情况
当 时,负梯度也是零向量,无法再通过它确定非零的最速下降方向。例如本例的原点满足:
此时原点确实是全局最小点。但对于一般函数,梯度为零也可能对应局部最大点或鞍点。
例如 在原点的梯度同样为零,却沿 轴增加、沿 轴减少,因此原点不是最小点。判断驻点性质,需要进一步检查函数结构、Hessian 矩阵或邻域内的函数值。
实际训练中,可以用梯度范数与损失变化共同辅助判断是否接近收敛。例如设置 作为本例的一个停止阈值,但在不同尺度、不同噪声水平的模型中必须重新选择容差。
处理多参数优化问题时,先按固定参数顺序求出梯度,再用负梯度和学习率执行更新,最后重新计算损失验证效果。这样既能解释更新方向,也能及时发现偏导数符号、参数顺序或步长设置错误。