
AI 与工程数学 / 系统课时
权重衰减与 L2 正则差在哪里
权重衰减与 L2 正则差在哪里
L2 正则和权重衰减都会把参数往零拉,因此在普通 SGD 中看起来几乎是同一件事;但进入 Adam 这类按参数自适应缩放梯度的优化器后,两者不再等价。理解差别后,就能知道 AdamW 为什么要把衰减从梯度计算中拆出来。
学习目标
- 推导普通 SGD 下 L2 正则与权重衰减为何等价
- 解释 Adam 中把 L2 项加入梯度会怎样受到自适应缩放影响
- 用一个可运行的单步更新实验验证 Adam 与 AdamW 的差异
先区分两种写法
设原始目标函数为 。L2 正则是在目标函数中加入参数平方惩罚:
因此参与优化器计算的梯度变成:
权重衰减则可以直接写在参数更新上。若学习率为 、衰减系数为 :
例如 、数据梯度 、、。L2 项为 ,普通 SGD 使用的总梯度为 ,更新结果是 。直接做权重衰减则得到 。
这就是为什么在不带动量和自适应预条件的普通 SGD 中,两种写法可以相互转换。
Adam 为什么打破这种等价关系
Adam 不直接用原始梯度更新参数,而是先计算一阶矩和二阶矩,再按 对每个参数的更新进行缩放。简化后的更新为:
如果把 L2 项直接并入梯度,传给 Adam 的就是 。这个正则梯度会和数据梯度一起进入一阶矩、二阶矩,因此也会受到 Adam 的历史统计与逐维缩放影响。不同参数即使具有相同的 ,最终承受的有效收缩强度也可能不同。
AdamW 的做法是让 Adam 只处理数据梯度,再独立执行参数衰减:
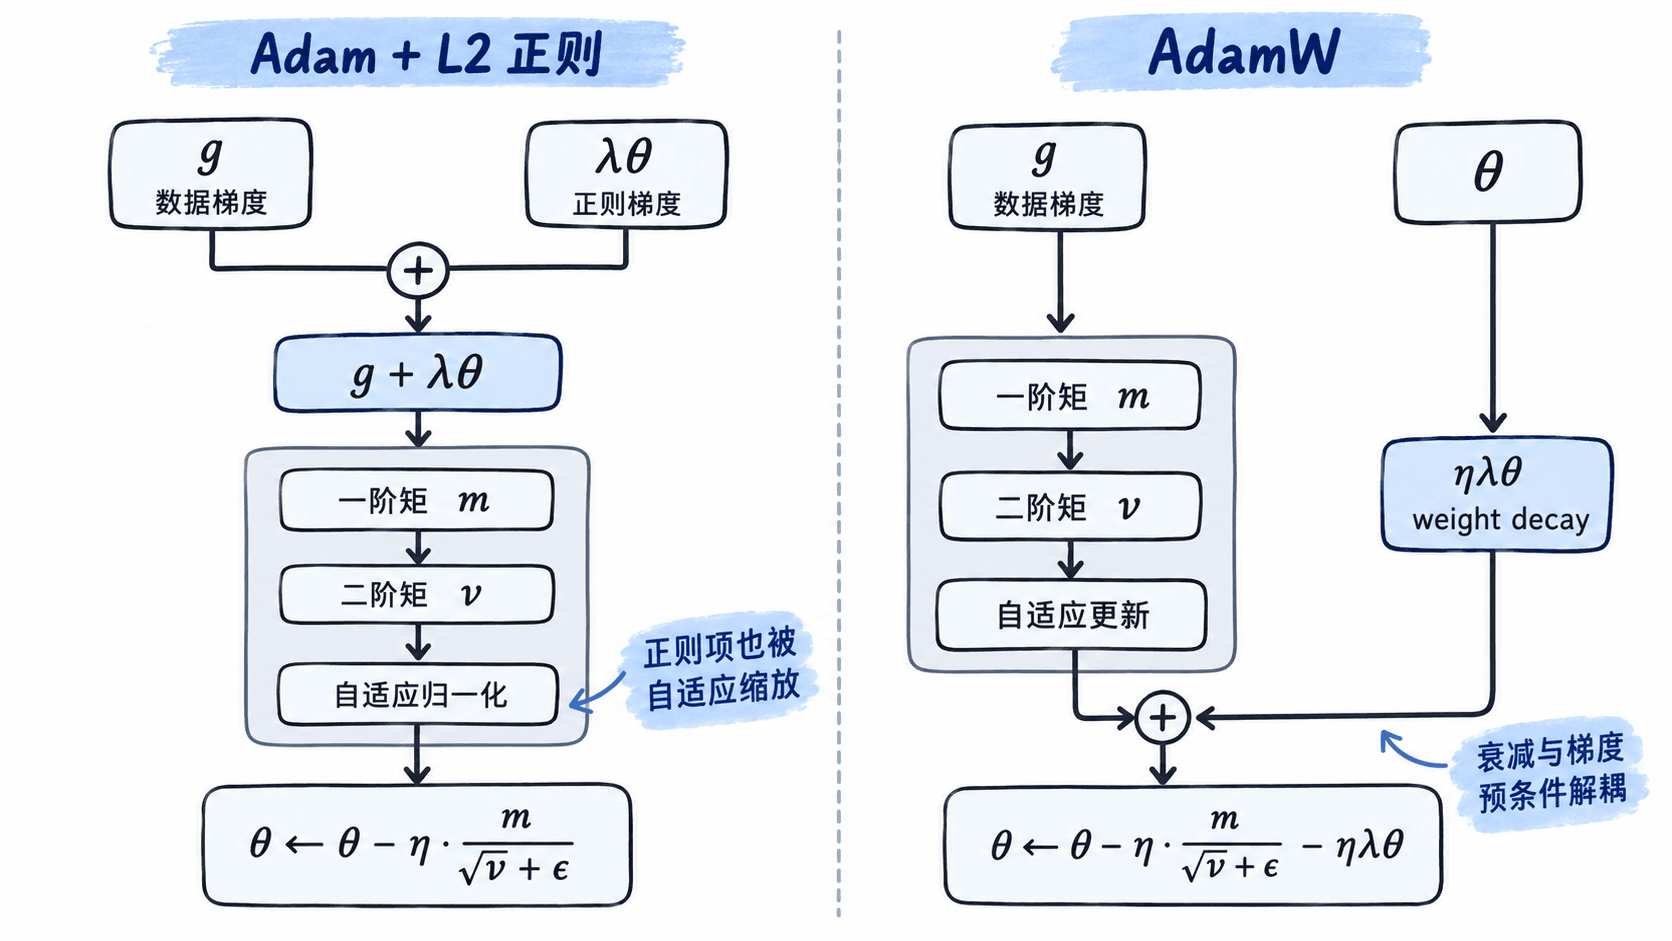
用一次更新看出数值差别
下面固定同一个参数、数据梯度和超参数,只计算第一次更新。第一次 Adam 更新中,偏差修正后的 与梯度一致, 与梯度平方一致,因此特别容易观察两种做法的差别。
import math


def adam_first_step(theta, data_grad, lr, weight_decay, eps=1e-8):
    # 耦合做法:L2 项先加入梯度,再进入 Adam 的矩估计。
    grad = data_grad + weight_decay * theta
    m_hat = grad
    v_hat = grad * grad
    return theta - lr * m_hat / (math.sqrt(v_hat) + eps)


def adamw_first_step(theta, data_grad, lr, weight_decay, eps=1e-8):
    # 解耦做法:Adam 只预条件数据梯度,参数衰减独立执行。
    m_hat = data_grad
    v_hat = data_grad * data_grad
    adaptive_update = lr * m_hat / (math.sqrt(v_hat) + eps)
    decay_update = lr * weight_decay * theta
    return theta - adaptive_update - decay_update


theta = 2.0
data_grad = 0.6
lr = 0.01
weight_decay = 0.1

print(f"Adam + L2: {adam_first_step(theta, data_grad, lr, weight_decay):.6f}")
print(f"AdamW:      {adamw_first_step(theta, data_grad, lr, weight_decay):.6f}")
预期输出:
Adam + L2: 1.990000
AdamW:      1.988000
耦合版本中的总梯度是 。第一次 Adam 更新会把这个 同时用于分子和二阶矩,归一化后更新量接近固定的 ,所以 L2 项并没有表现为额外的 参数收缩。AdamW 则先产生约 的自适应梯度更新,再明确减去 的权重衰减。
在实际训练中怎样选择
使用普通 SGD 且没有复杂预条件时,把 L2 惩罚写进损失与采用对应的权重衰减通常可以得到等价更新。加入 momentum 后,具体等价关系还会受到实现方式影响,因此不要只根据参数名判断行为。
使用 Adam 或类似自适应优化器时,如果目标是经典的解耦权重衰减,应明确选择 AdamW。以 PyTorch 为例,可以直接使用 torch.optim.AdamW:
import torch

model = torch.nn.Linear(4, 1)
optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=1e-3,
    weight_decay=1e-2,
)

x = torch.ones(2, 4)
y = torch.zeros(2, 1)

optimizer.zero_grad()
loss = torch.nn.functional.mse_loss(model(x), y)
loss.backward()
optimizer.step()

print("step completed")
预期输出:
step completed这里的 weight_decay=1e-2 由 AdamW 作为解耦衰减处理,不需要再手工把 加进损失,否则会同时施加两套正则化。实际模型还常把 bias、LayerNorm 或其他归一化层参数排除在权重衰减之外;是否排除应由模型结构和训练方案决定,而不是机械地给所有参数使用同一个衰减系数。
判断两者时可以抓住一条可检查的标准:正则项如果先加进梯度再交给 Adam,就是耦合 L2;参数如果在自适应梯度更新之外单独按比例缩小,就是 AdamW 式解耦权重衰减。