
AI 与工程数学 / 系统课时
设置停止条件避免无效迭代
设置停止条件避免无效迭代
梯度下降需要明确何时结束训练:停得太早,参数可能尚未接近最优解;停得太晚,又会浪费计算资源。本课通过梯度范数、目标函数变化容差和最大迭代次数三种条件,构建一套能够直接运行、验证和排查的停止机制。
学习目标
- 理解三种停止条件的判断依据及各自的局限。
- 使用 Python 实现带停止原因的梯度下降。
- 根据训练日志识别过早停止、停滞和达到迭代上限的情况。
三种停止条件分别解决什么问题
考虑最小化目标函数 。它的梯度为 ,最优解为 。梯度下降按 更新参数,其中 是学习率。
如果只写无限循环执行更新,即使参数已经非常接近最优值,也无法自动结束。实际实现通常同时使用以下三个判断。
| 停止条件 | 判断规则 | 示例阈值 | 主要作用 |
|---|---|---|---|
| 梯度范数 | 判断是否接近驻点 | ||
| 函数值变化 | $ | f_k-f_{k-1} | \leq\varepsilon_f\max(1, |
| 最大迭代次数 | 已执行更新次数达到 | 1000 | 限制计算资源消耗 |
这里的函数值变化使用相对与绝对混合容差:目标值绝对值较小时,以 1 为尺度;目标值较大时,按其量级调整阈值。它比固定绝对差值更适合不同数量级的目标函数。
三个条件不能互相替代。梯度小可能意味着局部极小值、鞍点或数值问题,不保证全局最优;函数值变化小也可能只是学习率过低;最大迭代次数则只能说明计算预算已经用完。
设计判断顺序与停止原因
推荐将梯度判断放在参数更新前,将函数值变化判断放在更新后,并始终保留迭代上限作为兜底条件。每一次结束都返回明确的停止原因,而不是只有一个布尔值。
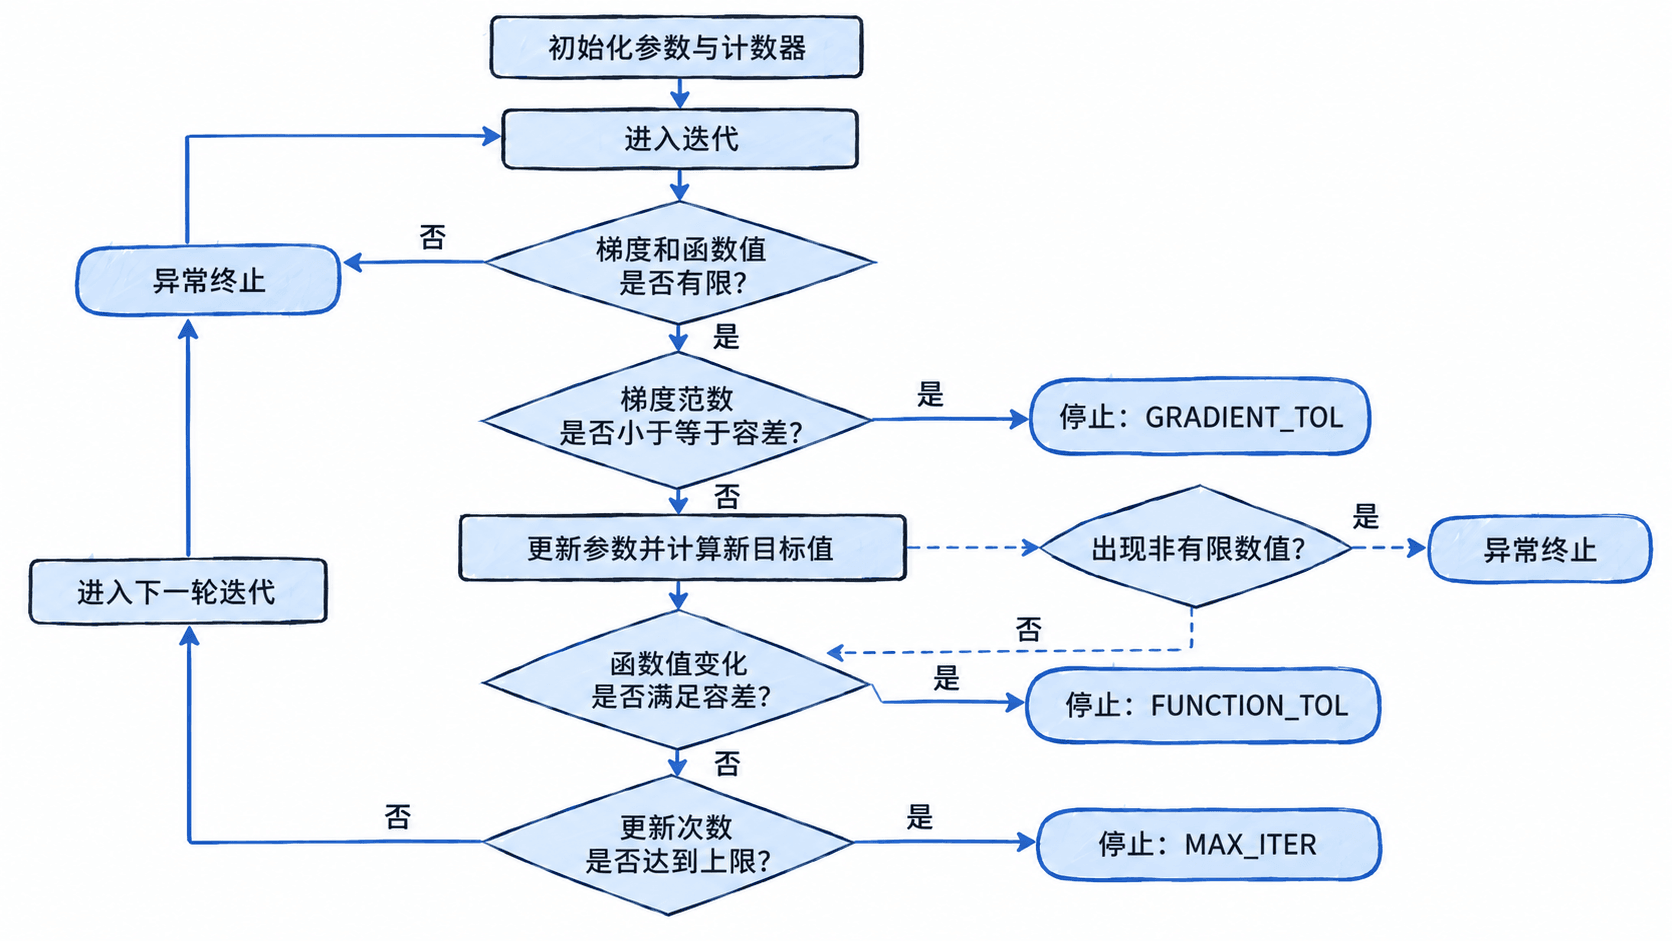
具体执行顺序如下:
- 在每轮开始计算当前目标函数值与梯度,检查是否出现
NaN或无穷大。 - 如果梯度范数不超过
grad_tol,返回GRADIENT_TOL。 - 否则执行一次参数更新,计算更新后的目标函数值。
- 如果本次函数值变化满足
func_tol,返回FUNCTION_TOL。 - 如果累计更新次数达到
max_iter,返回MAX_ITER;否则继续下一轮。
这套逻辑中,梯度判断优先于更新,而函数值变化在当前更新完成后立即检查。因此返回的迭代次数代表实际执行的参数更新次数,不包含单纯的梯度检查。
在深度学习中,还应区分优化器停止条件和验证集早停。验证集早停通常监控验证损失,并使用 patience(连续若干次验证未改善才停止),用于控制过拟合;它不等同于梯度范数收敛。
实现可运行的梯度下降
下面使用 Python 3.10 及以上版本,只依赖标准库。初始值设为 0,学习率为 0.1,梯度阈值为 ,函数值变化容差为 ,最大更新次数为 1000。
import math


def objective(x):
    return (x - 3.0) ** 2


def gradient(x):
    return 2.0 * (x - 3.0)


def optimize(x0=0.0, lr=0.1, grad_tol=1e-6,
             func_tol=1e-10, max_iter=1000):
    if not (0.0 < lr and math.isfinite(lr)):
        raise ValueError("lr must be positive and finite")
    if grad_tol < 0 or func_tol < 0 or max_iter < 1:
        raise ValueError("invalid stopping parameters")

    x = float(x0)
    for k in range(max_iter):
        old_loss = objective(x)
        grad = gradient(x)
        if not all(map(math.isfinite, (x, old_loss, grad))):
            return x, k, "NON_FINITE"
        if abs(grad) <= grad_tol:
            return x, k, "GRADIENT_TOL"

        # 先更新,再根据实际目标值改善判断是否停止
        new_x = x - lr * grad
        new_loss = objective(new_x)
        if not all(map(math.isfinite, (new_x, new_loss))):
            return x, k, "NON_FINITE"
        x = new_x
        delta = abs(new_loss - old_loss)
        threshold = func_tol * max(1.0, abs(old_loss))
        if delta <= threshold:
            return x, k + 1, "FUNCTION_TOL"

    return x, max_iter, "MAX_ITER"


if __name__ == "__main__":
    x, steps, reason = optimize()
    print(f"x={x:.6f}")
    print(f"loss={objective(x):.12f}")
    print(f"steps={steps}")
    print(f"reason={reason}")
保存为 stop_gradient.py,在其所在目录运行 python stop_gradient.py。
预期输出:
x=2.999984
loss=0.000000000262
steps=54
reason=FUNCTION_TOL
为什么没有触发梯度阈值?第 54 次更新后,函数值变化已经足够小,但梯度绝对值仍大于 。由于程序采用任一条件满足就停止的策略,因此先触发 FUNCTION_TOL。这说明函数值容差的设置会直接影响最终参数精度。
用数值实验检查阈值是否合理
对于当前二次函数,学习率取 0.1 时,每次更新都会把参数到最优解的距离乘以 0.8:
因此,迭代次数越大,参数误差越小,但每次改善幅度也逐渐缩小。
可以在上述文件末尾的主入口内追加以下片段示例;它依赖已定义的 optimize、objective 和 gradient 函数,放在原有打印语句之后执行。
    # 分别检验梯度主导、函数值主导和迭代上限
    cases = [
        ("gradient", 1e-6, 0.0, 1000),
        ("function", 1e-6, 1e-10, 1000),
        ("budget", 1e-6, 0.0, 10),
    ]
    for name, gt, ft, limit in cases:
        value, count, why = optimize(
            grad_tol=gt, func_tol=ft, max_iter=limit
        )
        print(f"{name}: steps={count}, reason={why}, "
              f"grad={abs(gradient(value)):.6g}")
预期输出:
gradient: steps=70, reason=GRADIENT_TOL, grad=9.87364e-07
function: steps=54, reason=FUNCTION_TOL, grad=3.48449e-05
budget: steps=10, reason=MAX_ITER, grad=0.644245
实验表明,函数值容差在第 54 次更新触发,但严格的梯度阈值需要 70 次更新;当预算限制在 10 次时,梯度仍然较大,显然不应该把 MAX_ITER 解释为成功收敛。
工程实践中可先设置 grad_tol=1e-6、func_tol=1e-10、max_iter=1000 作为本例的测试基线,再根据目标函数尺度、噪声和计算预算进行调整。这些值不是所有 AI 模型的通用默认值。
避免过早停止与无效运行
实际训练出现异常停止时,先看停止原因,再检查梯度、损失变化和学习率,不要只根据更新次数判断效果。
| 观察现象 | 可能原因 | 可执行的修正 |
|---|---|---|
迭代几次就触发 FUNCTION_TOL,但梯度仍较大 |
容差过宽或学习率过小 | 将 func_tol 从 1e-6 降至 1e-10,同时检查学习率 |
频繁触发 MAX_ITER,损失持续下降 |
迭代预算不足 | 将上限从 100 增至 1000,比较最终梯度 |
损失反复增大或出现 NON_FINITE |
学习率过大或数值溢出 | 降低学习率,例如从 1.1 改为 0.1,并检查输入尺度 |
| 梯度很小,但损失仍不理想 | 鞍点、平坦区域或目标函数存在局部极值 | 检查初始化、目标函数和验证指标 |
对于含噪声的小批量随机梯度下降,单次梯度和损失变化都会波动。实际可以每 100 次更新评估一次完整训练集或固定验证集指标,并结合连续多次评估结果决定是否停止,避免一次偶然波动触发结束。
还有一个容易忽略的数值边界:当新旧函数值因浮点精度而完全相同时,变化量会变成零。此时若梯度仍然很大,不应直接报告高质量收敛,而应检查参数更新幅度、浮点精度和学习率是否已经使更新失效。
可以用三个检查项验收停止机制:每次执行有明确停止原因;实际更新次数不超过 max_iter;只有满足约定精度时才将结果标记为收敛。达到迭代上限或出现非有限数值时,应保留当前参数与诊断信息,交由训练任务决定重试、调参还是报错。