
AI 与工程数学 / 系统课时
何时需要打乱训练样本
何时需要打乱训练样本
使用小批量随机梯度下降训练模型时,样本的排列顺序会影响每一步梯度的方向。如果数据按类别、时间或来源集中排列,模型可能出现周期性震荡或阶段性偏移。本篇通过可复现的实验比较两种训练轨迹,并说明时间序列数据为什么不能随意打乱。
学习目标
- 解释样本顺序如何影响小批量梯度和参数更新。
- 使用 Python 对比顺序遍历与随机遍历的训练结果。
- 区分普通独立样本训练、时间序列预测和数据集划分中的打乱规则。
为什么样本顺序会影响优化
小批量随机梯度下降(Mini-batch SGD)每次只使用部分样本计算梯度。假设有 1000 条训练数据,batch size 为 50,那么每个 epoch 包含 20 次参数更新。
如果前 500 条属于类别 A,后 500 条属于类别 B,不打乱时,优化器会连续执行 10 次偏向 A 的更新,再连续执行 10 次偏向 B 的更新。当两类样本的梯度方向存在冲突时,参数就可能反复朝不同方向移动。
打乱后,每个小批量更可能同时包含两类样本,梯度方向通常更接近整个训练集的平均方向。需要注意,打乱并不能保证每个批次类别均衡,也不能消除随机梯度本身的噪声。
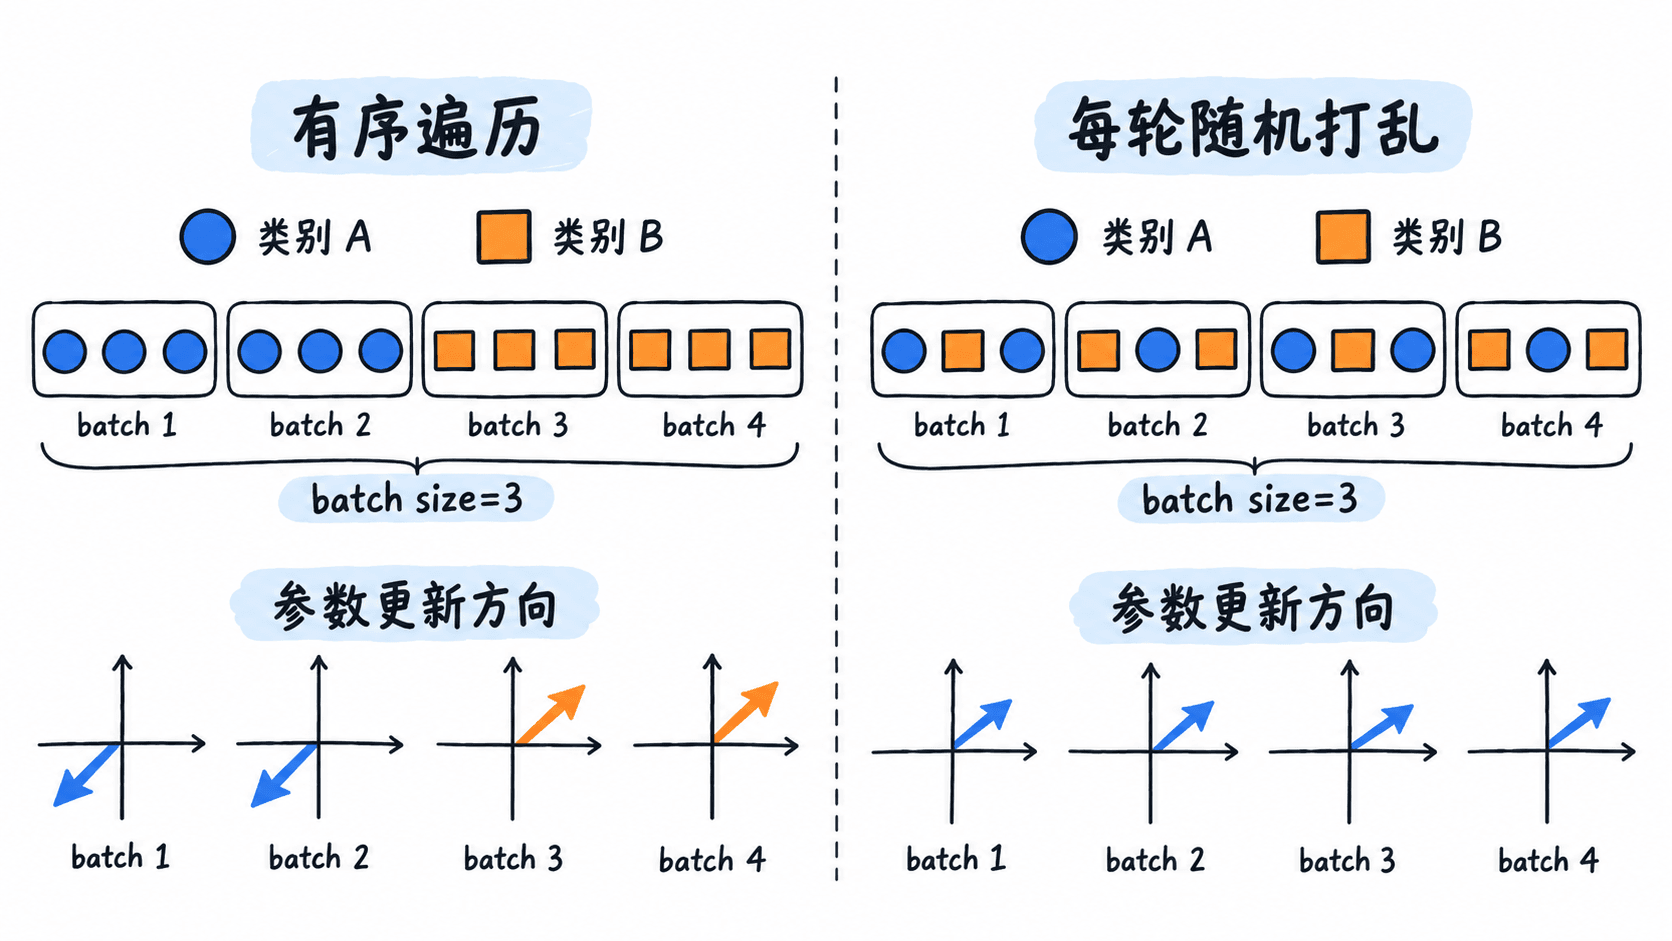
对于固定的一组样本,在固定参数位置计算的全量平均梯度不受排列顺序影响。但 SGD 会在每次小批量更新后改变参数,因此后续梯度是在不同参数位置计算的,最终训练轨迹可能不同。
用实验比较两条训练轨迹
下面使用一个简单的一维回归问题:模型预测值为 ,目标是学习参数 。训练数据的输入都为 1,前 100 条目标值为 0,后 100 条目标值为 4,因此整体均方误差的最优参数是 2。
实验使用 NumPy,batch size 为 10,学习率为 0.1,训练 20 个 epoch。两组训练使用相同的初始参数,区别仅在于是否每轮打乱样本。
先安装依赖:
python -m pip install numpy预期结果:命令正常退出,NumPy 可以被 Python 导入。具体安装日志和版本号取决于本地环境。
将以下完整代码保存为 shuffle_demo.py:
import numpy as np

# 两组样本按目标值排序,整体最优参数为 2
x = np.ones(200, dtype=np.float64)
y = np.concatenate([np.zeros(100), np.full(100, 4.0)])


def train(shuffle):
    rng = np.random.default_rng(42)
    w = 0.0
    history = []
    batch_size = 10

    for epoch in range(20):
        indices = np.arange(len(y))
        if shuffle:
            rng.shuffle(indices)

        for start in range(0, len(y), batch_size):
            batch = indices[start:start + batch_size]
            # 对当前批次的均方误差求梯度
            gradient = 2.0 * np.mean((w * x[batch] - y[batch]) * x[batch])
            w -= 0.1 * gradient

        history.append(w)

    return np.array(history)


ordered = train(False)
shuffled = train(True)

for epoch in [0, 4, 19]:
    print(
        f"epoch={epoch + 1:2d} "
        f"ordered={ordered[epoch]:.3f} "
        f"shuffled={shuffled[epoch]:.3f}"
    )

print(f"ordered_mse={np.mean((ordered[-1] * x - y) ** 2):.3f}")
print(f"shuffled_mse={np.mean((shuffled[-1] * x - y) ** 2):.3f}")
运行命令:
python shuffle_demo.py预期结果:程序输出第 1、5、20 轮的两组参数,以及各自的最终均方误差。由于每轮固定先训练目标为 0 的样本、再训练目标为 4 的样本,有序遍历在后半轮会持续将参数推向 4;随机遍历则通常在最优值 2 附近波动。固定随机种子可以复现实验中的采样顺序,但不同 NumPy 版本的随机排列实现不宜作为跨版本完全一致的保证。
这里的排序数据是刻意构造的极端示例,不代表所有有序数据都会训练失败。如果批次已经具有代表性,或者使用全批量梯度下降,打乱所带来的收益可能很小。
训练时应该怎样打乱
对于普通图像分类、表格分类等近似独立同分布的样本,常用策略是在训练开始时构造索引,并在每个 epoch 开始时重新随机排列,然后按 batch size 切分。
以 12000 条训练样本、batch size 为 64 为例,每轮包含 188 个批次,其中最后一个批次只有 32 条。如果不希望丢失样本,应保留这个不足 64 条的批次,而不是默认丢弃。
实际项目可按以下规则检查:
- 训练集:通常每轮打乱,避免固定批次长期包含相似样本。
- 验证集和测试集:一般不需要打乱;如果打乱,必须确保预测结果与真实标签仍按同一索引对应。
- 类别极不均衡:不能只依靠打乱,应考虑分层采样、加权损失或专门的采样器。
- 具有相同用户、设备或患者标识的相关记录:先按组划分训练集和验证集,再决定训练集内部如何打乱,防止关联样本跨集合泄漏。
时间序列为什么需要特殊处理
时间序列预测通常要求使用过去的信息预测未来,例如用过去 24 小时的电力负荷预测下一小时。此时必须区分两个操作:打乱原始时间点,以及打乱已经构造好的时间窗口。
如果直接打乱原始时间点,再按相邻位置生成窗口,就会破坏真实的时间先后关系。模型看到的所谓过去 24 小时实际上可能来自完全不同的日期,预测问题也随之改变。
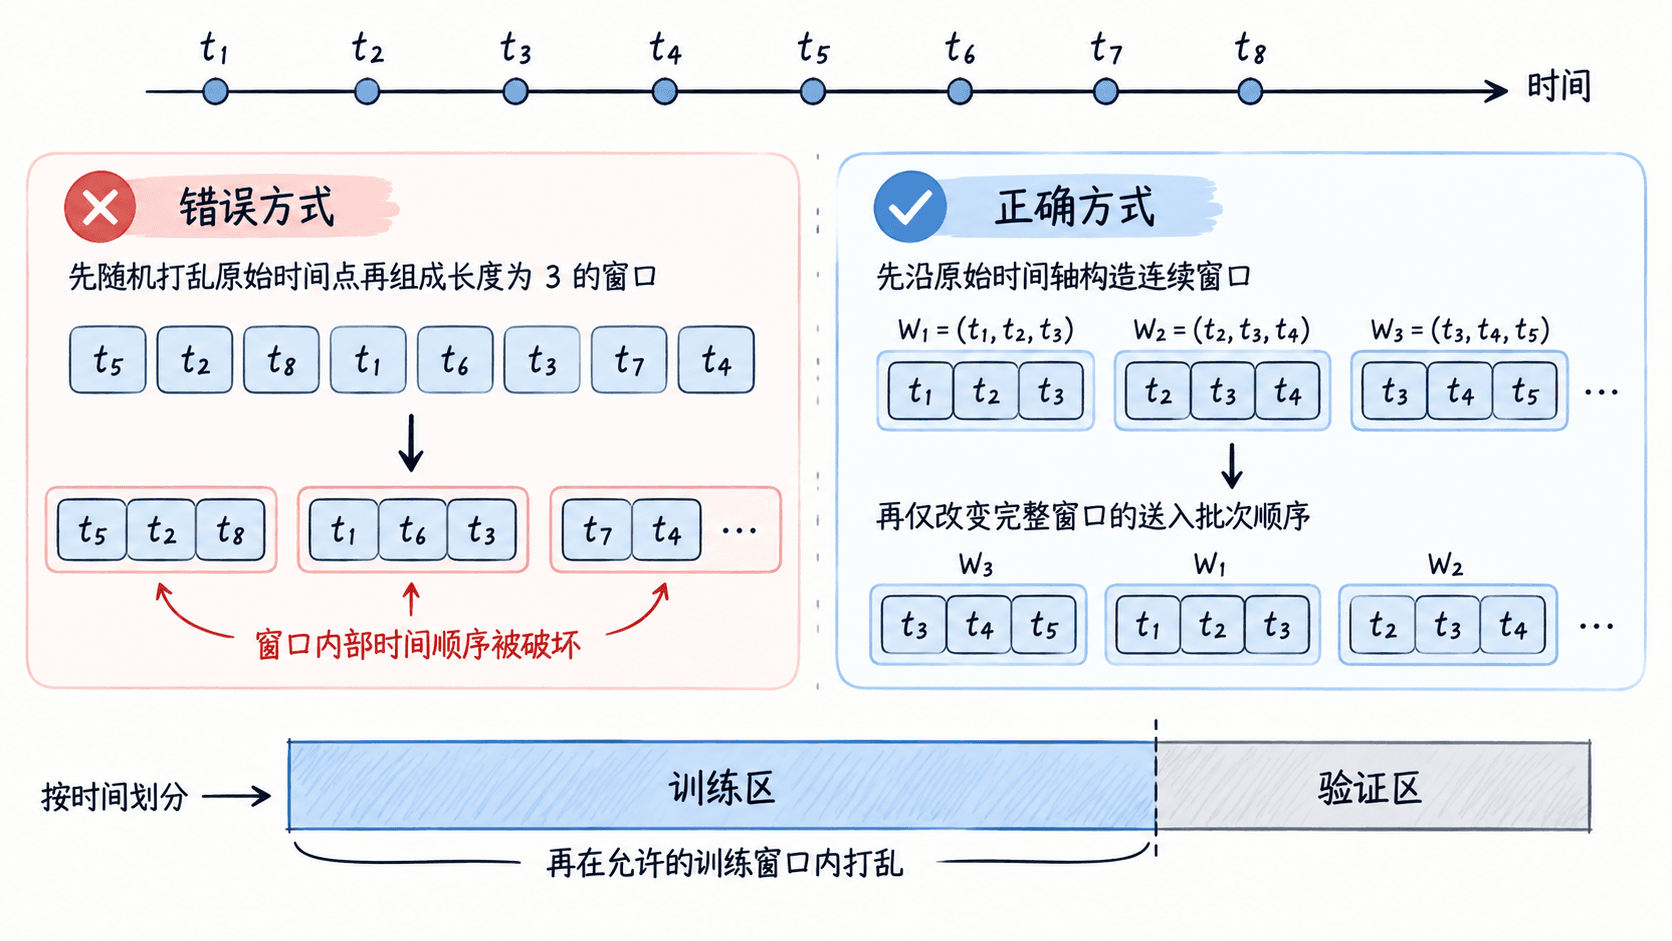
假设有 100 天的数据,使用前 7 天预测第 8 天,可按照以下顺序处理:
- 按日期将前 80 天作为训练时段,后 20 天作为验证时段,不随机分割原始时间点。
- 在各自时段内构造长度为 7 的连续输入窗口,预测紧随其后的第 8 天。
- 如果模型对窗口之间的处理顺序没有依赖,可以打乱完整训练窗口的排列顺序,但不能改变单个窗口内部的时间顺序。
- 验证时按日期顺序评估,并确保每次预测只使用预测时刻已经能够获得的数据。
如果使用有状态 RNN 并且需要跨窗口传递隐藏状态,或者训练的是在线更新、连续回放的时序模型,窗口之间的顺序也可能必须保留,不能直接使用普通随机采样。
什么时候不应该盲目打乱
打乱能够降低样本排序带来的系统性梯度偏差,但它解决不了数据泄漏,也不能替代正确的数据划分。尤其是按时间预测未来的任务,应优先保证训练、验证和测试的时间边界正确。
可以用两个问题决定具体策略:第一,交换两条训练样本的处理顺序会不会改变任务语义或模型状态?第二,打乱之后是否仍然保证每条输入只包含预测时可用的信息?如果两个答案分别是不会、能够,通常可以在训练阶段随机打乱。
实践中建议先固定随机种子、数据划分、学习率和 batch size,只改变是否打乱,比较多轮训练损失、验证损失及参数波动。对于强相关数据,再按时间或实体分组进行验证,避免仅凭训练曲线更平滑就判断模型泛化能力更强。